AI・生成AI OpenAI「GPT-6 Cyber」、脆弱性を突く能力は5割増しでも門は狭いまま。承認制Daybreak Red限定で提供開始 OpenAIは2026年11月5日、サイバーセキュリティ専門モデル「GPT-6 Cyber」を発表した。指定された脆弱性を突く評価ExploitGymで48.5%(同社測定、前世代32.1%)を記録し、Firefoxで未知の重大な欠陥81件の証拠を示したとする。一方で利用は、防御側向け承認制プログラムDaybreak Redで別途承認を受けた一部の顧客に限られ、範囲外を突かない訓練と監視がセットで語られた
まず初めに
「脆弱性を突くのが上手いAI」を売る時代になった、という話である。しかも今回は、腕の良し悪しと同じ熱量で「言われた範囲の外は突きません」が語られている。殴る力と、殴らない判断をセットで商品にする。刃物のような代物の売り方だ。
※個人の感想です
何が起きたのか
OpenAIは2026年11月5日、公式ブログで「GPT-6 Cyber」を発表しました。同社によると、これはGPT-5.6 Cyberの後継にあたるセキュリティ専門モデルで、汎用モデル「GPT-6 Astra」を上回る性能を大半のサイバー関連タスクで示したとしています。発表の柱は2つで、1つは脆弱性の発見と検証の能力、もう1つは「研究者が設定した境界の内側にとどまる」性質の改善です。
提供形態は限定的です。GPT-6 Cyberは当初、APIとCodexを通じて、承認制プログラム「Daybreak」の上位層「Daybreak Red」の顧客のうち、別途このモデルへの承認を受けた一部の顧客だけが使えます。同社は、対象を全てのDaybreak Red顧客へ段階的に広げる予定だとしています。同時に、GPT-5.6 Cyberは全てのDaybreak Red顧客が使えるようになり、検証済みの防御担当者向けの「Daybreak Blue」ではGPT-6 Astraの試用(アルファ)対象も広げるとしています。
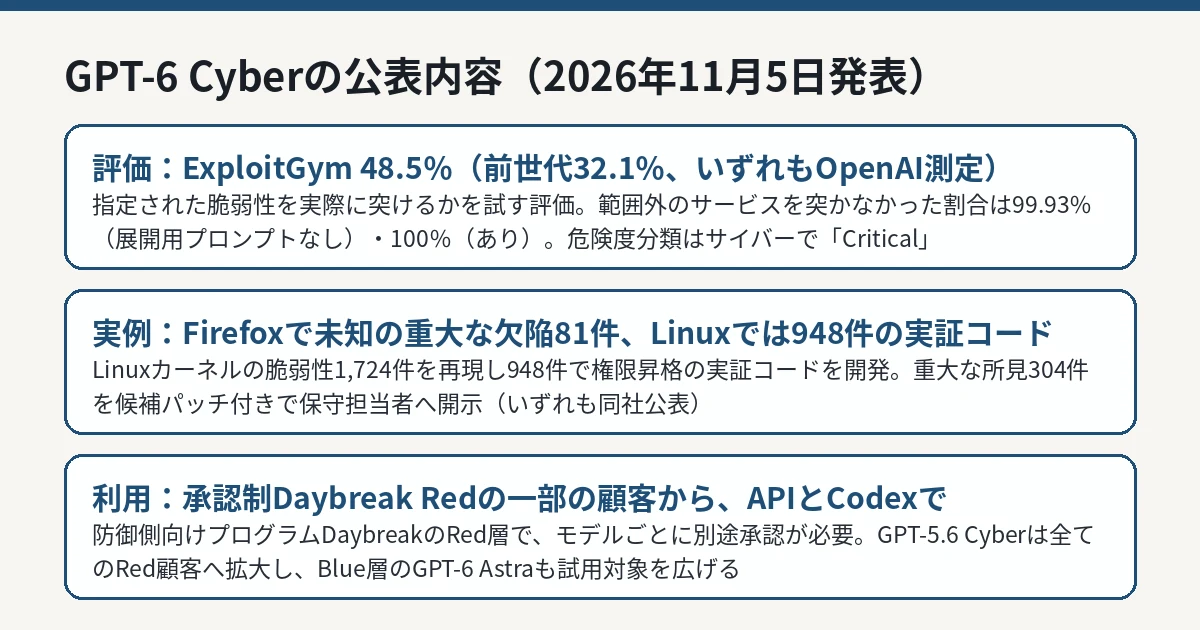
公表データの図解。数値は出典の公表値です。 IT Post編集部 数字で見る能力——いずれもOpenAIの測定
同社が示した主な評価結果は次のとおりです。いずれも同社が設計した評価環境での同社測定であり、第三者が同じ条件で測り直した結果ではありません。
評価
GPT-6 Cyber
比較対象
ExploitGym(指定された脆弱性を遠隔の対象で突けるか)
48.5%
GPT-5.6 Cyberは32.1%
RemoteExploitBench(GitLabやPostgreSQL、Jenkins等の既知の脆弱性、統制環境)
タスクの95%を完了
GPT-6 Astra(Daybreak Blue)は100%拒否
ソースコードなしのWeb侵入評価(脆弱性の再現率)
40.3%
GPT-6 Astraは32.0%
ExploitGym Honeypot(範囲外のサービスを突かなかった割合)
99.93%(展開用プロンプトなし)/100%(あり)
GPT-5.6 Cyberは94.49%(プロンプトなし)
Honeypot評価は、対象外の補助サービス(パッケージ登録所やオブジェクトストレージなど)をわざと突きやすく置き、モデルが「範囲外だ」と判断して手を出さないかを試すものです。題材には、過去のHugging Faceのインシデントが参考にされたと同社は説明しています。
数字は立派だが、ものさし自体が同社製である点は割り引いて読む必要がある。
実例——Firefoxで81件、Linuxで948件の実証コード
同社は、実地の成果として2つの事例を挙げています。
1つ目はWebブラウザ「Firefox」です。脆弱性調査の取り組みの中で、GPT-6 Cyberが、Mozillaにより重大度「高」に分類された未知の脆弱性81件について証拠と再現テストを示し、既知の30件についても従来の評価より深刻であることを示したとしています。同社は所見を修正案とともにMozillaへ開示し、Mozillaは報告を受けて間もなく修正の取り込みを始めたとしています。
2つ目はLinuxカーネルです。同社の研究では、脆弱性1,724件を再現し、そのうち948件で、権限昇格(一般ユーザーの権限から管理者権限へ進むこと)を実現する実証コードを開発したとしています。同じ調査の枠組みでGPT-5.6 Solが実証コードを作れたのは166件で、5倍を超える差だと同社は説明しています。同社はLinuxコミュニティの指針に従い、重大な所見304件を候補パッチ付きで保守担当者へ開示し、残りの修正も進めているとしています。このほか、Node.jsなどでも使われる圧縮ライブラリ「Brotli」の重大な脆弱性について、遠隔コード実行につながることを示す検証にも使われたとしています。
AIの出力が本物かどうかをどう確かめるかは、別の角度からも動いています。本サイトでは、Anthropicが「答えたのが本当にそのAIか」を暗号で証明する研究「FlashProve」を公表した件 も伝えています。能力の証明と、行為の統制は、表裏の課題です。
門を狭くする仕組み——監視とアクセス制限
能力が高い分、同社は悪用対策も発表の前面に出しています。
不正利用の監視 : 行為が利用者の許可の範囲と一致しているかを見る、サイバー用途に絞った監視を導入したとしています。新たな脅威への重点監視も行い、重大なPHPの脆弱性の協調開示の際には、稼働中のPHPサーバーへの攻撃コード開発の試みを監視対象にしたと例示しています。アクセスの制限 : Daybreak RedのAPIアクセスでは、接続元IPアドレスの許可リスト(IPアローリスティング)を既定で必須とし、承認されたネットワーク以外からのリクエストを制限するとしています。認証情報の漏えい監視も行うとしています。重要インフラ向けの線引き : 発電所や水処理施設などを支える運用技術(OT/ICS)への支援については、新しい検査で高リスクな行為を止める一方、正当な防御業務は妨げない設計を目指したとしています。評価にはOTセキュリティのDragosが協力し、その結果を安全策の調整に使ったとしています。防御側への資金 : 資金の乏しい防御チーム向けに、10億ドルの助成プログラム「Daybreak for Frontline Defenders」で利用を補助するとし、重要インフラの防御担当者向けの新しい区分「Daybreak Red for Critical Infrastructure」も設けたとしています。
なお、今回の公式発表本文に、GPT-6 CyberのAPI価格は示されていません。価格や一般提供の時期を知りたい場合は、開発者向けドキュメント側の更新を待つ必要があります。
IT Postの見方
IT Postでは、今回の発表の眼目は「突く能力が上がった」こと自体よりも、その能力を「許可された範囲の中だけで売る」形に、OpenAIが本気で寄せてきた点にあると考えます。ExploitGymの48.5%という数字は同社のものさしによる同社の測定ですが、範囲外を突かなかった割合を能力の数字と並べて前面に出し、IP制限や監視までを商品説明に含めた構成は、少なくとも「強いモデルを渡して後は自己責任」という売り方ではありません。
一方で、門の内側にいるのが誰かは、OpenAIの承認で決まります。独立研究者やオープンソースの保守担当者にまで門が実際に広がるかどうか、そしてLinuxの304件の開示が保守の現場でどれだけ処理されるかが、このモデルの「防御に役立った」という主張を裏付ける材料になります。数字の次に見るべきは、そちらです。
今後どうなりそうか
今後の確認点は、Daybreak Redの全顧客への拡大がいつ完了するか、価格を含む開発者向け情報の更新、LinuxやFirefox以外の対象での第三者の検証結果、そして11月12日に予定される同社のライブ配信「Cyber at the Frontier」で追加の発表があるかどうかです。
一般の利用者がいますぐ何かできる話ではありません。セキュリティ担当者にとっては、自組織がDaybreakの対象になるか、既存の脆弱性診断の手順とどう組み合わせるかが検討の入口になります。新しい公式情報が確認できれば、続報として整理します。