AI・生成AI Anthropic、答えたのが本当にそのAIか暗号で証明する「FlashProve」を公開。4000億パラメータでも毎秒110トークン、代償は計算70〜95倍 Anthropicは2026年11月2日、AIの回答が本当に指定したモデルから出たものかを暗号学的に証明するオープンソースの研究プロトタイプ「FlashProve」を公開した。重みを見せずに証明でき、4000億パラメータのモデルで毎秒約110トークンの証明生成を確認したが、通常の推論の70〜95倍の計算がかかる。仕組みと制約を整理した
まず初めに
AIに「あなたは本当に高性能モデルですか」と聞いて「はい」と答えられても、何の証明にもならない。仲介サービスが安いモデルにすり替えていても、利用者には見分ける術がない。身分証のない相手に高級品の代金を払い続けてきたのが、今のAI APIの正直な姿である。その身分証を暗号で作ろうというのが今回の話だ。
※個人の感想です
何が起きたのか
Anthropicは2026年11月2日、研究記事「Progress on provable inference for large language models」を公開し、証明可能推論(provable inference)のためのシステム「FlashProve」を発表しました。あわせて、今回の記事自体、技術レポート、プロトコル仕様書、証明を作るプログラムと2種類の検証プログラム、安全性の主張を形式検証 言語Leanで書いた証明と対話型の可視化ツール、の5点をApache 2.0ライセンスで公開しています。同社は、この研究記事は中間段階の進捗の共有であり、完成した研究ではないと明記し、他の人が引き取って改良することを期待するとしています。
同社が問題にするのは、利用者がAIモデルに質問しても、返ってきた回答が本当に指定したモデルから出たものかを確認する手段が、今日は存在しないことです。出力の出来栄えだけでは判断できません。同社は例として、料金を払っているモデルとは別の安いモデルへ、仲介するルーティングサービスがこっそり差し替える場合、攻撃者がトークンの流れを改ざんする場合、公開前後のモデルを評価する担当者が、評価対象とは別のモデルを掴まされる場合を挙げています。
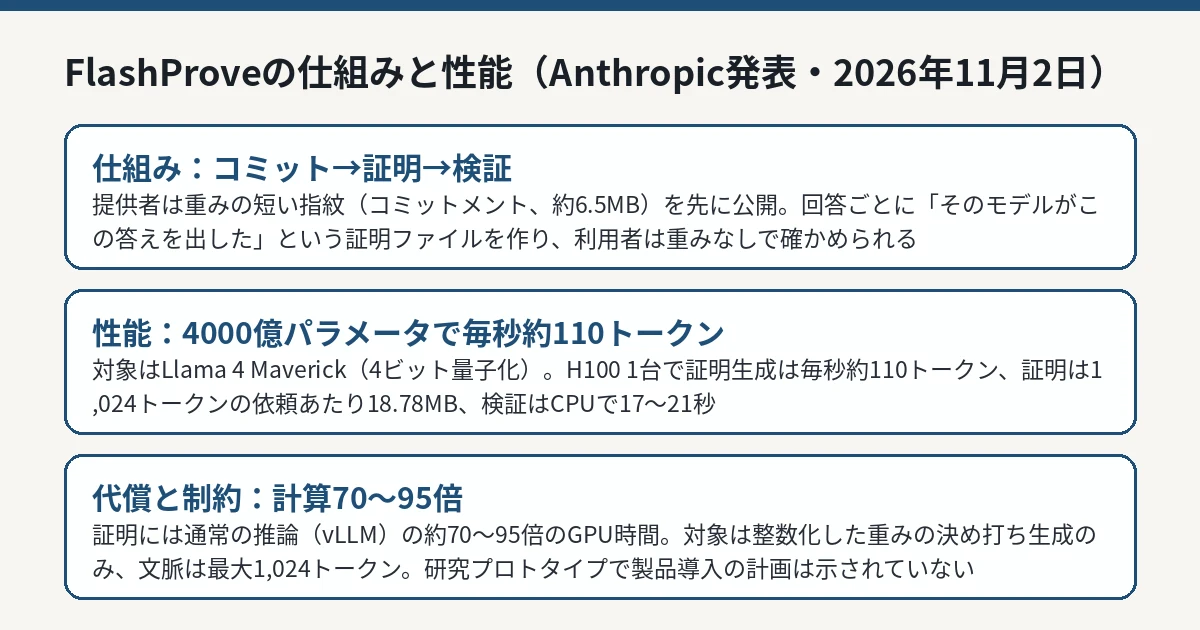
FlashProveの仕組みと性能(Anthropicの2026年11月2日の発表に基づく編集部の図解) IT Post編集部 仕組み——重みを見せずに「このモデル製」を証明する
FlashProveの土台は、zkSNARKと呼ばれる暗号学的な証明の仕組みです。大まかな流れは、提供者(証明する側)と利用者(確かめる側)の2段階に分かれます。
まずオフライン段階で、提供者はモデルの重みに対する「コミットメント」を公開します。これは重みそのものではなく、重みを1つに特定する短い指紋のようなもので、重みの中身は隠れたままです。今回の実測では、コミットメントは全体で約6.5MB、作成に約39分かかり、約1,600万リクエスト分まで有効だとされています。
次にオンライン段階で、提供者は利用者の質問と回答の組に対して証明ファイルを生成します。証明が示すのは「コミットされたモデルが、この入力に対して、この出力トークンを出す」という一文です。コミットメントと質問と回答を持つ人は、重みを持たず、限られた計算資源でも、その証明を確かめられます。
同社は証明の性質として、正直な証明は受理されること(完全性)、偽の証明は作れないこと(健全性)、証明から重みや途中の計算値は何も漏れないこと(ゼロ知識)、証明が小さく検証が速いこと(簡潔性)の4点を掲げています。安全性の主張の要所は、形式検証言語のLeanで機械的に確かめられる形で証明されています。一方で、日常用に使う高速なC++版の検証プログラム自体には形式的な保証はなく、Lean版の検証プログラムは遅い代わりに正しさが証明されている、という線引きも同社は明示しています。
数字で見る性能
同社の実測条件と結果は次のとおりです。対象は、Metaの「Llama 4 Maverick」(4000億パラメータの専門家の混合型モデルで、1トークンあたり約170億パラメータを使用。公開されている4ビット量子化の重み)です。
項目
実測値
証明の生成
H100 GPU 1台で毎秒約110トークン(24リクエスト一括で約223秒)
証明ファイルの大きさ
1,024トークンの依頼1件あたり18.78MB
証明の検証
CPUで17秒(24スレッド)〜21秒(1スレッド)
通常の推論との比較
推論エンジンvLLMの約72倍(一括処理時)〜約94倍(最高負荷時)。同社のまとめでは70〜95倍
同社の比較では、先行するオープンな実装は桁違いに遅く、同じモデルを対象にした先行研究「VerInf」は毎秒約0.02トークン、1,000トークンの証明に14.3時間、証明ファイルは93.6GBだったとされています。今回の毎秒約110トークンという数字は、その比較の上では大きな前進です。ただし、これは同社自身の測定であり、第三者が再現した数字ではありません。
AIの評価結果をどこまで信じられるかは、ベンチマークの側でも課題になっています。評価されるモデルが本物かどうかという今回の論点は、GoogleとMercorが公開したAIエージェント向けベンチマーク「PLE」 のような取り組みとも地続きです。
使い道として挙げられた4つ
同社は、証明可能推論が役立つ場面として、次の4つを挙げています。いずれも同社が示した応用例であり、実装済みの製品機能ではありません。
開発ペースの管理: 推論に使った計算の証明を求めることで、計算資源を学習など別の用途へ回すごまかしを難しくする
改ざんの検知: 推論サーバーが侵害されたり、より強いモデルが弱いモデルのふりをして動いたりした場合に、証明の不一致で気づけるようにする
文章の出所の証明: 「この分析は高性能モデルで実施した」という主張を、記録の自己申告ではなく証明で裏づける
承認されたモデルだけの提供の確認: 規制側が、提供されているのが承認済みのモデルかを軽い計算で確かめる
なお同社は、AIの安全性に関する公開ロードマップで「2026年9月30日までに証明可能推論のプロトタイプを作る」という目標を掲げていましたが、この目標自体は、推論の通信に署名し、信頼できるサーバーで再計算する別のプロジェクトで達成したと説明しています。FlashProveは、暗号方式で同じ目的を追う、もう1つのルートという位置づけです。
制約——「今すぐAPIに付く」仕組みではない
同社は、この公開が研究プロトタイプであることを繰り返し断っています。主な制約は次のとおりです。
証明の対象は、重みを整数化したモデルの、決め打ち(貪欲)な生成方式だけです。通常の浮動小数点の実装や、確率的に選ぶ生成方式では、計算結果がずれ、証明した計算と一致しなくなる場合があります。敵対的に作られた入力は、この誤差の想定の対象外です
扱える文脈は最大で1,024トークンまでです。現在のチャット型サービスの文脈の長さと比べると、かなり短い部類です
仕組みは専門家の混合型(MoE)の構造を前提にしており、モデルの構造そのものを隠すことは目的に入っていません。証明を作るのにかかる時間のような、証明の外側の情報(サイドチャネル)も保証の対象外です
高速な実行コードと、Leanで証明された仕様とが一致すること自体は保証されていません
また、TechCrunchは、Anthropicには現時点でFlashProveを製品に導入する計画はないと報じています。今回の公開をもって、Claudeなどの実際のAPIで「検証済みモデル」の表示が始まるわけではありません。
IT Postの見方
IT Postでは、今回の本質は性能競争ではなく、「AIの身分証明」という新しい競争の軸を、動く試作品で示した点にあると考えます。これまでモデルの正体は、提供者の自己申告と、出力の印象でしか判断できませんでした。そこに「重みを見せずに、計算で確かめられる」という選択肢が、4000億パラメータ級のモデルで毎秒110トークンという現実的な数字を伴って出てきたことには意味があります。
一方で、証明のコストが通常の推論の70〜95倍というのは、すべての回答に付けるには重すぎます。ただし同社の設計は、証明を回答の後から一括で作る方式で、検証側はCPUで数十秒です。「全部」ではなく「抜き取り」でよいのなら、評価機関の監査や高額な契約の確認など、計算が合う場面は限定的に存在します。
もう1つ残る論点は、証明が示す範囲です。証明が保証するのは「あらかじめコミットされた重みと一致するか」までで、その重みに付けられた商品名が正しいかどうかは、証明の外にあります。身分証の仕組みができても、発行元を誰がどう信用するかという問題は消えません。ここをどう運用するかが、次の論点になると見ています。
※個人の感想です
今後どうなりそうか
同社は、今回の成果を他の人が引き取って改良することに期待を寄せています。今後の確認点は、扱える文脈の長さの拡大、対象にできるモデル構造の広がり、商用の検証サービスがどこまで実用に近づくか、そして仲介サービスや評価機関が、提供者に証明を求め始めるかどうかです。
IT Postでは、続報や他社の追随が公表された場合は本記事を更新します。