セキュリティ CloudflareのAI基盤で「他人の入力」が155件の応答に混入、原因はキャッシュの容量とHTTP 200だった Cloudflareは2026年10月26日、Workers AIで提供するGLM-5.3モデルで、2026年8月27日から9月9日にかけて、681,280トークンを超えるプロンプトへの応答155件に他の利用者のリクエストのデータが含まれていたと公表した。原因はKVキャッシュプールの容量不足と、推論エンジンSGLangの拒否処理の不具合の組み合わせ。修正内容と、SGLangを自前運用する側の確認点を整理する
まず初めに
AIの応答に、見知らぬ誰かの入力が混ざって返ってくる。ホラー映画の筋書きのようだが、原因は呪いでも悪意でもなく、ただの寸法違いである。入るはずの箱より、中身の上限が大きかった。それだけの話が、天下のCDN事業者の本番環境で2週間近く生き残った。怖いのは寸法違いそのものより、それを誰も「中身を見て」確かめなかったことの方だ。ステータスコード200は、成功の証明にはなっても、正しさの証明にはならない。
※個人の感想です
何が起きたのか
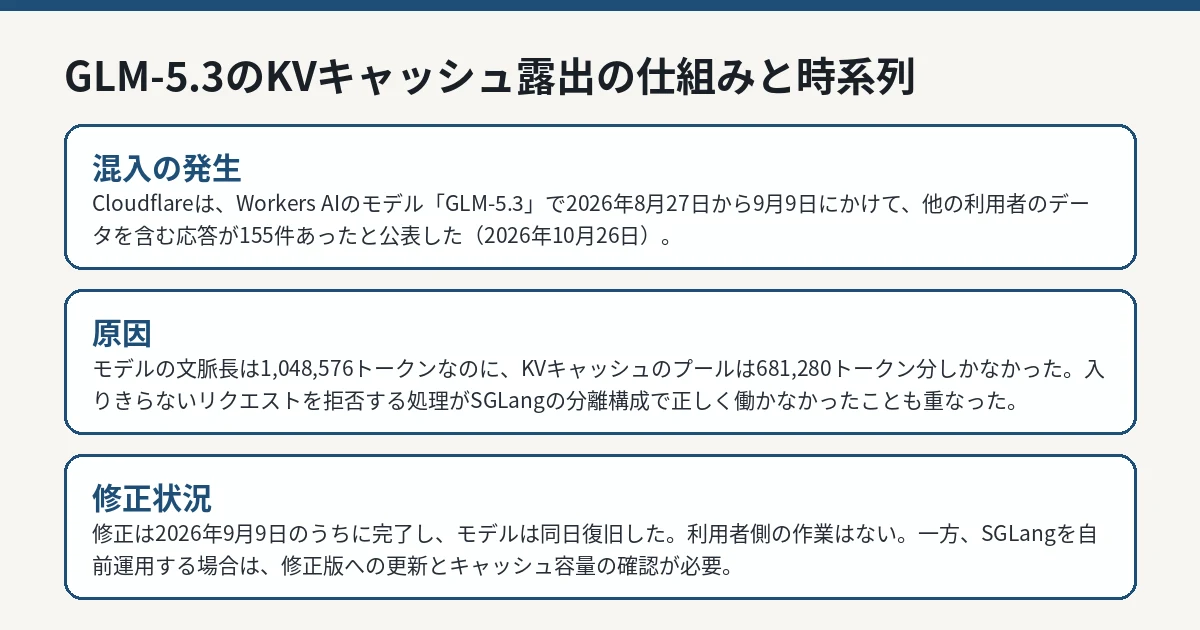
Cloudflareの公表によると、2026年9月8日、セキュリティ研究者のGadi Evron氏(Knostic)が、同社のHackerOneプログラムを通じて、GLM-5.3へ非常に長いプロンプトを送ると他の利用者のデータが返ってくる場合があると報告しました。
Cloudflareは9月9日にセキュリティインシデントを宣言し、同日中にモデルを非公開化して調査と修正を行い、修正を検証したうえで同日19時40分(UTC)にモデルを復旧しました。影響期間は、GLM-5.3がWorkers AIで提供開始された2026年8月27日から9月9日までです。
影響を受けた応答は合計155件で、いずれも681,280トークンを超えるプロンプトに対するものでした。Cloudflareは、自社のテストと報告者のリクエストを除いた分について、タイミングと量の点で通常の長文脈利用と整合的であり、不具合を意図的に悪用した形跡は見つからなかったと説明しています。また、影響はGLM-5.3に限られ、Workers AIの他のモデルは影響を受けていないことを確認した、としています。
影響は155件、全て681,280トークンを超えるプロンプトへの応答。修正はプールの拡大(約204万トークン)と拒否処理のパッチ IT Post編集部 なぜ起きたのか——2つの原因の組み合わせ
第一の原因は、寸法の不一致です。GLM-5.3は最大1,048,576トークンの文脈を受け付けると設定されていましたが、prefill側のKVキャッシュプール(推論の途中経過を保持するGPUメモリ領域)が保持できるのは681,280トークン分でした。Cloudflareは、収まりきらないリクエストはエンジン側がエラーとして処理するはずだ、と想定していたと説明しています。
第二の原因は、その「はず」が崩れたことです。SGLangの、prefillとdecodeを別々に担う分離構成では、拒否されるはずのリクエストが1トークンのプレースホルダに置き換えられて処理が進み、decode側が、まだ上書きされていない過去のリクエストのキャッシュページを読んで応答を生成しました。クライアントには、エラーであるHTTP 400ではなく、成功を示すHTTP 200が返っていました。
つまり、長大なプロンプトを送った利用者は、自分の入力への応答ではなく、直前に同じモデルを使った誰かの入力や生成途中の内容を含む応答を受け取ることがあった、という事案です。
修正の内容
Cloudflareは2段構えで修正したと説明しています。
1つ目は設定の修正です。プールの容量を約204万トークン(文脈長1,048,576トークンのおよそ2倍)まで広げ、正規のリクエストでは拒否処理の経路自体に入らないようにしました。
2つ目はエンジン側の修正です。拒否が保留されているリクエストは、転送や割り当ての前に、本来のエラーで終了させるようSGLangへパッチを当てました。Cloudflareはこの修正を上流へ提案し(#38704)、decode側で転送トークン数と予約数の一致を検証する仕組みも加わりました。関連する修正はSGLang側でも取り込まれています(#36988、#38935)。Cloudflareは、報告者の再現スクリプトと自社のカナリアマーカーによるテストで両方の修正を検証してから、モデルを復旧したとしています。
自前でSGLangを分離構成で運用している事業者向けには、新しい版への更新が推奨されています。二次情報では、完全な修正を含む版としてv0.5.22以降が挙げられています。運用中の版数と構成を、公式のリリース情報で確認してください。
私たちへの影響
Workers AIのGLM-5.3を、2026年8月27日から9月9日の間に、非常に長いプロンプトで使ったことがある開発者は、その応答に他人のデータが混ざっていないか、そして自分の入力が他人の応答に混ざる側になっていないか、という2方向で考える必要があります。とりわけ、プロンプトにAPIキーや顧客の個人情報などの機密を含めていた場合は、その情報を漏えいしたものとして扱い、キーの再発行などの対応を検討してください。
一般の利用者への直接の影響はありません。ただし、この事案の教訓は利用者側にもあります。AIサービスの応答に、自分の入力と無関係な内容が混ざっていたら、それは「AIの幻覚」で片付けず、事業者へ報告すべき事象だということです。今回の発見も、利用者側の研究者による報告から始まっています。
手順が必要な行動喚起の記事ではないため、ここでは確認観点を表にまとめます。
立場
確認すること
Workers AIのGLM-5.3利用者
対象期間(8月27日〜9月9日)に長大なプロンプトを送ったか。機密を含む入力はなかったか
SGLangの自前運用者
分離構成(prefill/decode)の有無、版数、KVキャッシュプールの容量が文脈長以上か
AI基盤の運用者一般
上限付近の入力で「応答の中身」まで検証するテストがあるか。ステータスコードだけ見ていないか
初心者が知っておくべきこと
Q. KVキャッシュとは何ですか。
A. 大規模言語モデル が推論の途中経過を保持しておくためのメモリ領域です。会話の文脈を毎回最初から計算し直さずに済むため高速化できますが、複数の利用者で設備を共有する以上、ここは利用者同士の境界でもあります。今回の事案は、その境界の管理に失敗した例です。
Q. HTTP 200なのに、なぜ問題なのですか。
A. HTTP 200は「処理が成功した」という合図です。本来エラーとして返すべきリクエストが200で返ったため、利用者側のプログラムも、Cloudflare自身の長文脈テストも、「成功した」と判断して通り過ぎてしまいました。Cloudflareは、長文脈のテストでステータスコードと性能だけを検証し、応答の中身の正しさを確認していなかったことが、発見の遅れにつながったと認めています。
IT Postの見方——これは「AIの漏えい」ではなく「共有基盤の古典的な失敗」だ
IT Postでは、今回の事案を、AI特有の新しい脅威というより、共有基盤で昔から繰り返されてきた「前の利用者の残り物を読んでしまった」失敗の、AI版だと考えます。メモリの使い回し、境界の検証漏れ、エラー経路の未検証。どれも目新しい欠陥ではありません。新しかったのは、舞台がGPUのキャッシュで、被害が「応答の文章」という形で表に出たことだけです。
評価すべきは、公表の具体性です。影響件数155件、境界値681,280トークン、想定と現実の食い違い、テストの不備まで、原因を「設定とエンジンの組み合わせ」として分解して書いています。直したのが自社だけではなく、オープンソース側の修正提案まで含まれる点も、基盤事業者としての筋の通し方です。逆に言えば、これだけ書ける事業者は多くありません。同種の基盤を運用する各社には、「うちはステータスコードしか見ていないテストで済ませていないか」という問いが、そのまま突き付けられています。
※個人の感想です
今後どうなりそうか
焦点は、SGLang側の修正版の普及と、分離構成を採用する他の推論基盤で同種の検証が行われるかどうかです。文脈長が伸び続けるほど、プール容量と上限の不一致は起きやすくなります。
IT Postでは、SGLangのリリースや関連する追加公表が出た場合は、本記事を更新して追います。