AI・生成AI SGLangコンソーシアム発足、NVIDIAとAMDとIntelが同じ推論エンジンの卓についた LMSYS Orgは2026年11月12日、オープンソースの推論エンジンSGLangのコンソーシアムを発足させた。創設メンバーはNVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArkの8社。年2回のロードマップ会議で優先順位を共有し、技術判断とコードの受け入れは従来どおりメンテナーが握る。推論がAI計算の約3分の2を占めるという見積もりを背景に、顔ぶれと仕組みを公式発表で整理する
まず初めに
GPUの売り子同士が、同じ卓について同じエンジンの設計図を眺める。数年前なら冗談みたいな絵だ。NVIDIAとAMDとIntelは、AIの計算基盤では正面から殴り合っている当事者である。その3社が、オープンソースの推論エンジンのロードマップ会議では隣同士に座る。殴り合いの場所が、チップそのものから「チップの上で何をどう動かすか」へ移った、ということだ。エンジンの効率がそのまま各社のチップの商品力になる以上、共通の土台は敵同士でも一緒に磨く価値がある。そういう計算が透けて見える顔ぶれだ。
※個人の感想です
何が発表されたのか
発表は、2026年11月12日から13日にサンフランシスコのFort Mason Center for Arts & Cultureで開かれた、初のSGLang Summitの基調講演で行われました。同イベントには、AIのハードウェア、モデル、基盤、応用の各分野から100人を超える登壇者が参加したとされています。
SGLangは、LMSYS Orgが支えるオープンソースの推論エンジンで、PyTorchのエコシステムの一部です。同社の説明では、数十万規模のGPU上で動作し、Meta、Microsoft、Google、Amazon、Thinking Machines Lab、Cloudflare、Reflection、Modalなど、大規模な本番推論の現場で使われています。推論エンジンとは、学習済みのモデルへ問い合わせを流し、速く安く答えを返すためのソフトウェアで、その効率が、そのまま各社のハードウェア上での実効性能とコストを決めます。
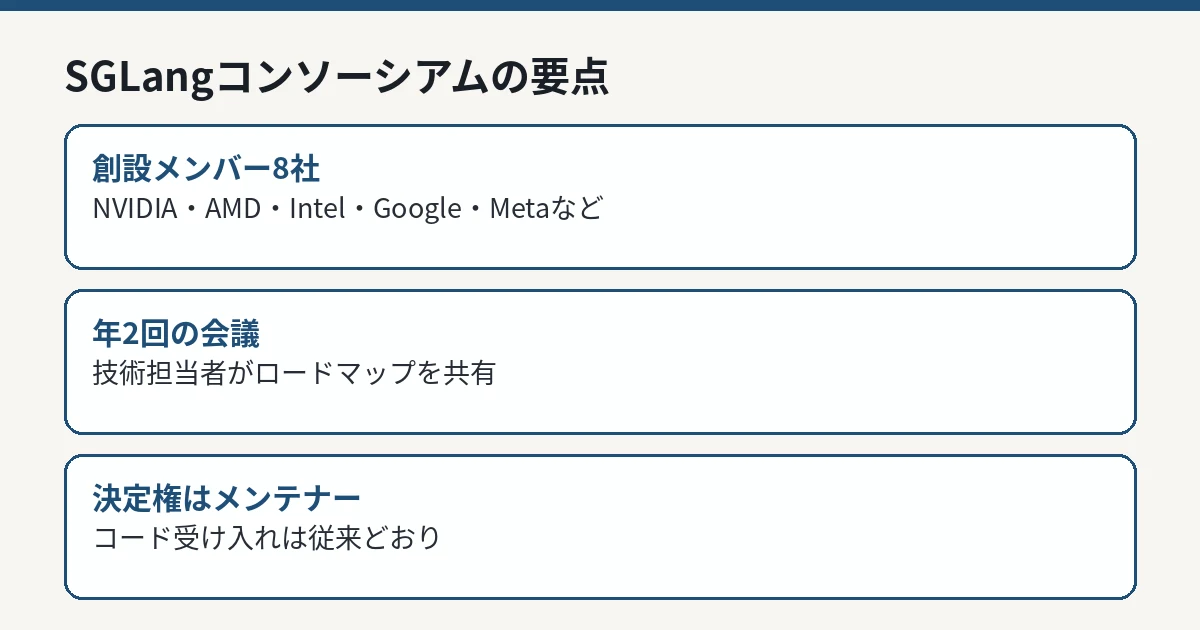
SGLangコンソーシアムの要点 IT Post編集部 コンソーシアムの仕組み――決めるのはメンテナーのまま
コンソーシアムは、メンバー企業がSGLangのメンテナーと推論の動向を議論し、共通の優先順位を共同の技術作業へ変えていくための常設の場と位置づけられています。焦点は、最先端モデルのサポート、推論(reasoning)とマルチモーダルのワークロード、分散推論、ハードウェア最適化の4つです。
各創設メンバーは技術担当者を指名し、年2回のロードマップ会議に参加します。貢献の形は、技術的な知見、実運用からのフィードバック、テスト資源、共同開発などです。会議の合間にはワーキンググループが活動することもあり、ロードマップの方向性や進捗は公開されるとしています。
重要なのは、権限の置き方です。技術的な判断とコードの受け入れについては、SGLangのメンテナーが引き続き責任を持ち、プロジェクトはコミュニティ全体に開かれたままにすると明言されています。出資企業が並ぶ場でありながら、決定権は企業の側へ移さない、という設計です。
発表には関係者のコメントも添えられています。SGLangの原論文の共著者でRadixArkの共同創業者兼CEOのYing Sheng氏は、大規模にSGLangを運用するチームの知見が全ての利用者に利益をもたらすことや、新しいデータセンターの建設が難しくなる中で、ソフトウェアによる効率改善が重要になることを述べました。NVIDIAのIan Buck氏(ハイパースケール・HPC担当バイスプレジデント)は、オープンな推論ソフトウェアの前進に協力する姿勢を示し、AMDのRamine Roane氏(AIアプリケーション担当コーポレートバイスプレジデント)は、オープンソースがAI推論をさらに前進させることや、SGLangがAMD Instinct GPUを含むハードウェア横断で動く点を挙げています。
周辺の動き――v1.0と各社の最適化
二次報道によれば、SGLangのチームはあわせてバージョン1.0のマイルストーンを発表し、採用組織は330を超え、217のモデルへの公開初日の対応(デイゼロサポート)を掲げたとされています。ただし、安定化に向けた作業は続いている段階であり、「1.0」という数字を、全機能が本番向けに固まったことの証明と読むべきではありません。
また、IntelとRadixArkは11月12日に別の発表として、IntelのCPU、GPU、アクセラレータ向けにSGLangを最適化し、AMX(Advanced Matrix Extensions)への対応を進めるとしました。RadixArkとAWS Annapurna Labsが共同開発したSGLang-Neuron v0.1.0は、AWSのTrainiumへSGLangを持ち込むもので、AWSのリリースノート上は公開プレビューであり、一般提供ではありません。各社の最適化は個別に進んでおり、コンソーシアムの共同作業の成果とは分けて評価する必要があります。
推論基盤の共通化という点では、llama.cppとggmlがv1.0.0に到達し、安定したAPIの約束を打ち出した動き とも地続きです。ローカル実行の土台と、データセンター側の推論エンジンとで、どちらも「長く使える共通基盤」への投資が目立つ局面になっています。
IT Postの見方
IT Postでは、このコンソーシアムの成否は、会議の顔ぶれではなく、提出されるコードと再現可能なベンチマークで決まると考えます。ライバル同士が同じ土台を磨く構図は、土台が中立である間だけ成り立ちます。メンテナーが決定権を持つという設計は、その中立性を守るための明示的な仕掛けであり、ここが崩れれば、企業は自社専用の最適化へ戻っていくでしょう。
もう1つの見どころは、主戦場の移り方です。推論がAI計算の約3分の2を占めるという見積もりが正しければ、競争の中心は「どのモデルが賢いか」から「同じ答えをどれだけ安く速く返せるか」へ移ります。その土台をオープンに保てるかどうかは、特定のベンダーへの依存を避けたい利用者全体の利害に直結します。
今後どうなりそうか
今後の確認点は、第一に年2回のロードマップ会議から具体的な優先順位と進捗の公開が出てくるか、第二に複数ベンダーのハードウェアで再現できる形の性能比較が示されるか、第三にv1.0の安定化がどこまで進むかです。同社はコンソーシアムの方向性と進捗の情報を公開・更新していくとしています。発表の熱がコードに変わるかどうかを、続報で追います。