AI・生成AI LongCat-2.5、1.6兆パラメータの重みをMITで公開。中国Meituanの本気は「配る」ではなく「動かす場所」の方に出た 中国のMeituanは、ネイティブマルチモーダルなMoEモデルLongCat-2.5の重みをHugging Faceで公開した。総パラメータ1.6兆、トークンごとに約480億を活性化し、ライセンスはMIT。モデルカードの評価は同社測定が中心で、配布形態はBF16と4ビット量子化版、導入ガイドが示すのはNPUプラットフォーム向けという条件も含めて公式情報で整理する
まず初めに
1.6兆パラメータをMITで配る。ライセンスの緩さとモデルの重さが、見事に反比例している。誰でも自由に使っていいが、その「誰でも」の中には、数テラバイトの重みを置ける倉庫と、それを回せる計算機を持っている者しか実質的には入っていない。オープンウェイトの民主化とは言うが、実態は「設計図は全員に配る。工場を持っている者はどうぞ」という配り方だ。それでも、設計図が本物かどうかを誰でも検証できる点で、APIの向こう側に閉じたモデルとは意味が違う。
※個人の感想です
LongCat-2.5とは何か
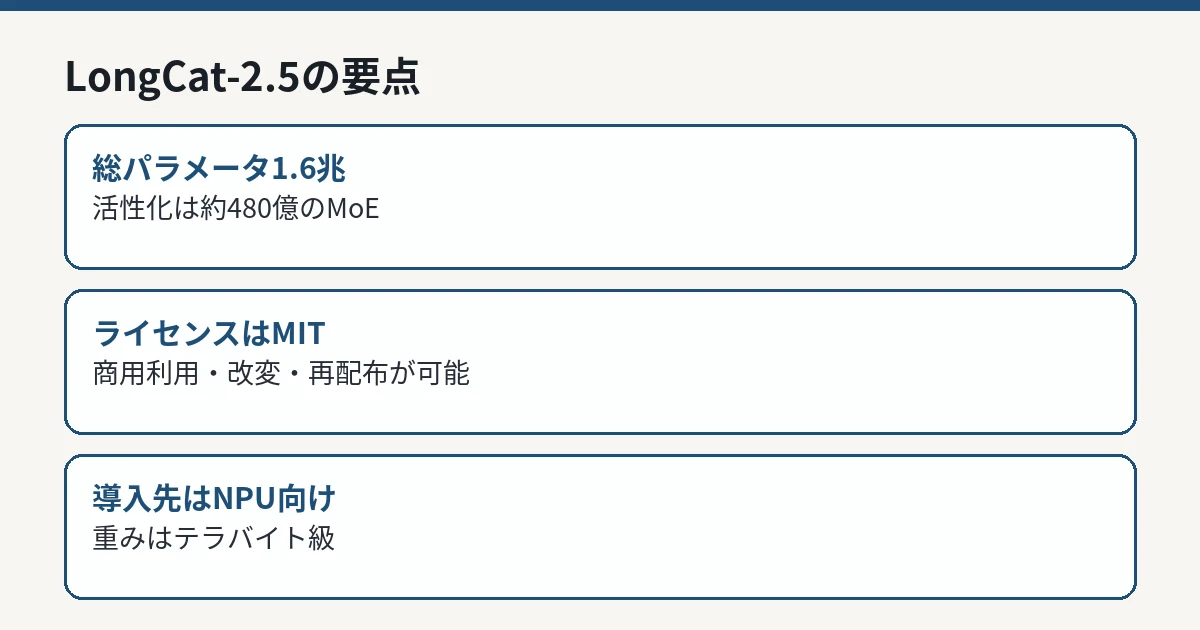
LongCat-2.5は、Meituanが公開した大規模言語モデルです。モデルカードによれば、長時間のエージェント作業(long-horizon agentic tasks)を想定したネイティブマルチモーダルなMoEモデルで、前世代のLongCat-2.0を土台に、視覚理解とエージェント型コーディングを組み合わせています。総パラメータ数は1.6兆、トークンごとに活性化するパラメータは約480億です。学習面では、長系列の学習、大規模な強化学習、複数の専門モデルから学ぶマルチティーチャー学習、そして中国国内のAIアクセラレータ上での基盤最適化が挙げられています。
視覚の扱いが特徴です。前段の研究(LongCat-Next)に基づき、画像を本来の解像度の特徴のまま離散トークンへ変換し、テキストと同じ意味空間でそろえる設計だと説明されています。文章だけでなく、画面や画像を見ながらコードを書き、プロジェクト全体を作る用途が前面に出ています。
LongCat-2.5の要点 IT Post編集部 評価スコアの読み方
モデルカードの評価表は、読み方の注意書き付きです。星印(*)の付いたスコアは公開された技術レポートやブログ、公式リーダーボードからの引用で、星印のない自社モデルのスコアは同社内で測った「目安(indicative)」の値だと明記されています。この留保を踏まえて見ると、LongCat-2.5の値は、コーディングエージェント系のTerminal-Bench v2.1で88.4(前世代2.0は70.8)、DeepSWE v1.1で64.6(同9.7)、一般エージェント系のBrowseCompで91.9、MCP Atlasで83.1、視覚系のVision2Webで78.6などとなっています。
一方で、同じ表の中でもTerminal-Bench v4.0では38.5と、Claude Opus 5の引用値53.9を下回る項目があります。つまりこの表は、自社に有利な項目だけを抜いた宣伝表ではなく、勝っている項目と負けている項目が混在した開示です。もっとも、測定条件は項目ごとにハーネスや温度設定が細かく注記されているとはいえ、同社測定と他社引用が同居する以上、順位の断定には使えません。数字は「どの土俵で測ったか」とセットで読むのが前提です。
重みの配り方と、動かす場所の条件
ライセンスはMITです。モデルカードのライセンス表示もMITで、二次資料によれば、商用利用や追加の学習にMeituanの許可は要らないと同社のオープンソース発表で説明されています。重みの公開は、モデル発表(11月2日)に続いて11月10日にオープンソース化が発表されたと報じられています。
配布形態は2系統あります。BF16の重み一式と、W4A4(重みと活性化を4ビットへ量子化)版です。モデルカードによれば、W4A4量子化は専門家の重みと活性化に適用され、国内AIアクセラレータ上でのINT4計算を可能にするもので、W8A8のベースラインと比べても処理効率の改善値が示されています。ただし、肝心の導入先です。モデルカードの「Deployment」欄が案内するのは「NPUプラットフォーム」であり、導入手順として示されているのはSGLangの派生実装(SGLang-FluentLLM)への参照です。一般的なGPU向けの実行レシピは、モデルカード上には示されていません。
重みの量も桁違いです。二次資料によれば、Hugging Face側のメタデータ上のパラメータ総数は約1.8兆と表示され、BF16のファイルは多数のシャードに分割されています。1.6兆という公称との差は視覚部分などを含む数え方の違いとみられますが、いずれにせよ、個人のワークステーションで気軽に試せる規模ではありません。同じHugging Faceで公開されたInkling 2 Smallのような「重みは公開、ただし巨大」なモデル と同様、「公開された」と「自分の環境で回せる」の間には大きな距離があります。
IT Postの見方
IT Postでは、LongCat-2.5の面白さは性能表よりも、公開の仕方の「割り切り」にあると考えます。ライセンスは最も緩い部類のMIT、しかし実行基盤は自国製アクセラレータとそのソフトウェアスタックに寄せてある。重みを世界に配りながら、実際に回す場所の標準はこちら側で握る。半導体を巡る輸出規制の時代に、これは偶然の組み合わせには見えません。モデルそのものよりも、「どの計算機の上でAIが動くか」の主導権争いが、公開モデルの設計にまで染み出してきた例だと言えます。
もう1点は、評価の開示姿勢です。自社測定であること、目安であることを表の注記に書くのは、最近の大規模モデルの公開ではむしろ丁寧な部類です。問題は、こうした注記が二次情報ではほぼ確実に剥がれ落ち、「88.4でOpus超え」のような見出しだけが流通することです。読む側が注記まで辿る習慣を持てるかどうかが、オープンウェイト時代のリテラシーになりつつあります。
今後どうなりそうか
確認点は、第一にGPU向けを含む実行レシピや量子化済み配布がコミュニティ側から整うかどうか、第二に第三者による独立評価が出るかどうかです。1.6兆級のモデルは検証できる組織自体が限られるため、独立評価は小規模なタスクでの部分検証から始まる可能性が高いとみられます。第三に、中国勢のオープンウェイト公開がMIT級の緩いライセンスで続くかどうかです。ライセンスの緩さが定番になれば、米国のクローズドな提供との対比はさらに際立ちます。
新しい公式情報が確認できれば、本記事を更新して整理します。