IT Post

by Rice Studio Lab


記事を検索
文字サイズ
ふりがな
AI・生成AI

Google CloudのSC26は「エージェントにHPCの作法を教える」が主役。AlphaEvolveはCloud Batchへ、A5Xベアメタルも

Google Cloudは2026年11月13日、スーパーコンピューティング会議SC26に向けたHPCとAIの発表を公開した。目玉は計算機の増強よりも、Cluster Toolkitにエージェント向けスキルを組み合わせる運用の型と、進化計算エージェントAlphaEvolveのCloud Batchソリューション。第8世代TPU 8t/8i、NVIDIA Vera Rubin基盤のA5Xベアメタル、Managed Lustreなどの基盤側の顔ぶれも整理する

30秒で分かる結論

  • Google Cloudは2026年11月13日、SC26向けの発表で、HPCの構築と運用の手順をエージェント向けの「スキル」として再利用可能な形で提供する方針を示しました。スキルはGitHubのGoogle SkillsとDeepMind Science Skillsのリポジトリから入手できます。
  • 進化計算でアルゴリズムを最適化するAlphaEvolveは、Cloud Batchのソリューションとして提供され、1つの設計図から数百件の候補評価を並列に実行できる構成が示されました。
  • 基盤側では、第8世代TPUのTPU 8tとTPU 8i、NVIDIA Vera Rubin NVL72基盤のA5Xベアメタル、H4DやG4、Managed Lustreなどが並びます。TPU 8t/8i自体は今回が初出ではなく、発表の主役は運用の型のほうです。
この記事の目次 6項目
出典を確認する(2件)
サーバーホールで設計図を読むロボットとケーブルを接続するロボットたちを描いた編集部の生成イラスト
生成イラスト。実在の画面やロゴは含まない IT Post編集部

まず初めに

スーパーコンピュータの祭典で、Googleが一番前に出したのは速い計算機ではなく「段取り」だった。クラスタの立て方、流体の回し方、詰まったキューの直し方。職人の頭の中にあった手順を、エージェントが読める形に書き下ろして配るという話である。計算機の自慢合戦に疲れた目には地味に映るが、現場が本当に金と時間を溶かしているのは、計算そのものより段取りのほうだったりする。 ※個人の感想です

発表の柱は「スキル」――手順をエージェントに渡す

Google Cloudは2026年11月13日、HPC製品担当のMegan Gawlik氏とAnnie Ma-Weaver氏による公式ブログで、SC26(2026年11月15日から20日、シカゴで開催)に向けたHPCとAIの取り組みを公表しました。

中心にあるのは、同社のCluster Toolkitと組み合わせるエージェント向けスキルです。Cluster Toolkitは、宣言的なYAMLの設計図から再現可能なHPC環境を構築する仕組みです。今回、自己記述的で決定論的な道具を備えたスキルが追加され、自動のエンドツーエンドテストで検証済みのものが、Google SkillsとDeepMind Science SkillsのGitHubリポジトリからダウンロードできる形になりました。

スキルの中身は3種類に整理されています。第一に基盤構築のスキルで、エージェントはデプロイの前に計算とストレージのクォータを監査し、地域の容量を素早く試し、検証済みの設計図と照合して、人間の承認を待ってから構築コマンドを実行します。第二に科学分野ごとのスキルで、OpenFOAMやSiemens STAR-CCM+の流体計算、GROMACSやAlphaFold 3のライフサイエンス系パイプライン、DevitoやOpen Porous Mediaの地下シミュレーションなどを扱います。第三に運用と診断のスキルで、IAMやKueueのクォータ、予算のガードレールの内側で動き、記録はCloud Loggingに残り、詰まったキューやノードの切り離しを扱う構造化されたトラブルシューティングも含まれます。

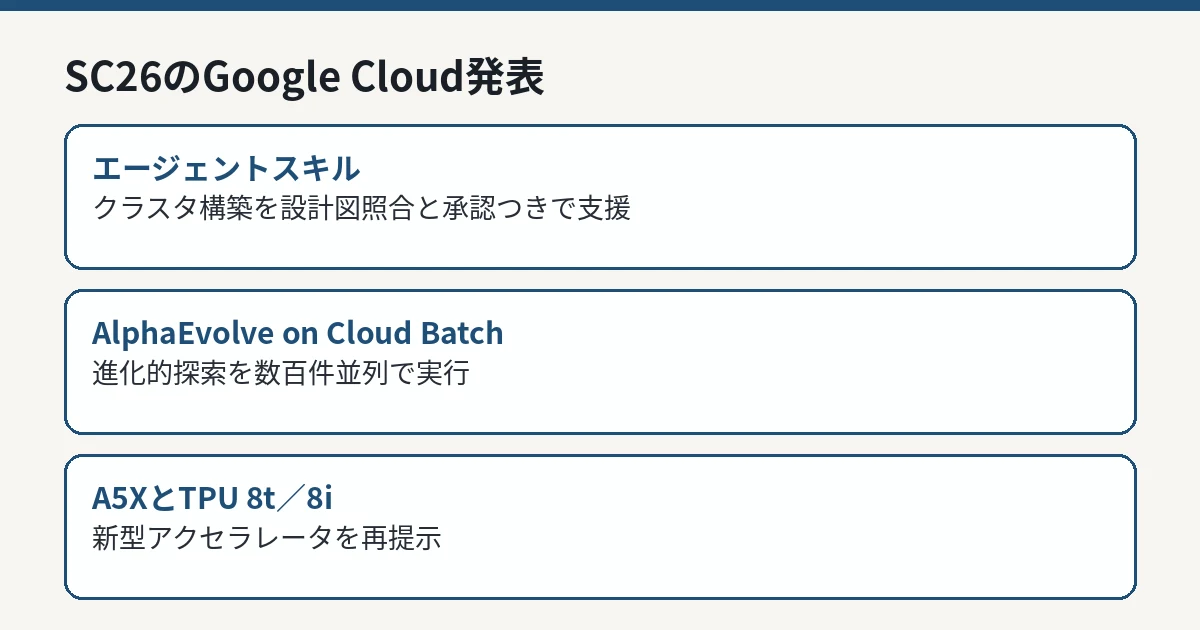
Google Cloud公式ブログの図解カード
SC26のGoogle Cloud発表の要点を整理した図解 IT Post編集部

AlphaEvolve on Cloud Batch――進化計算を本番の規模で回す

もう一つの柱が、Google DeepMindが開発したAlphaEvolveです。これはGeminiによる進化のループで、コードや3次元設計のパラメータを変異させ、指標に対して測定しながら最適化する仕組みです。今回、ノートパソコン上の種アルゴリズムから大規模な並列実験へ移す過程を簡単にする「AlphaEvolve on Cloud Batch」ソリューションが示されました。

構成は、1つのgclusterの設計図でコントローラ環境を用意し、Batchを使って数百件の候補評価を同時に広げる形です。評価は単一VMのサンドボックス、または複数ノードのMPIタスクグループで実行されます。研究者はホストされたPythonノートブックから実験を操作し、候補の系譜を確認できるほか、既存のCLIのワークフローやエージェント駆動の開発道具へ組み込むこともできます。

評価を本番の規模で行う点も強調されています。Cloud RDMAとGoogle Cloud Managed Lustreの上で候補を評価し、Spot VMやDynamic Workload Schedulerで費用と所要時間の釣り合いを取ることで、小規模でしか速くないアルゴリズムではなく、実際のスーパーコンピューティングの基盤で速いアルゴリズムを見つけられると同社は説明しています。

基盤側の顔ぶれ――TPU 8t/8i、A5X、H4D、Managed Lustre

発表は、エージェントの作業を支える基盤としてCluster Directorが管理する計算とストレージの組み合わせも示しています。

密結合のHPCとスケールアウト計算では、第5世代AMD EPYCとCloud RDMAを備えたH4Dインスタンスが挙げられ、大規模なEDAや工学モデル向けに3TBの高メモリ形状も用意されています。Arm基盤のC4A(Google Axion)も選択肢に並びます。

GPUでは、A4とA4XがNVIDIA BlackwellのB200とGB200 NVL72に対応し、新たに利用可能になったA5XベアメタルインスタンスはNVIDIA Vera Rubin NVL72基盤です。G4インスタンスはNVIDIA RTX PRO 6000 Blackwell GPUを搭載し、CAEやCFD、3次元可視化の用途と、コア単位のソフトウェアライセンス費用の削減がうたわれています。

第8世代TPUについては、TPU 8tが大規模な事前学習と強化学習、数学的モデリングとシミュレーションの加速向け、TPU 8iが高スループットで低遅延の推論とエージェント型推論向けと位置づけられています。あわせて、Batchが単一ホストのTPUスライスでのジョブ実行に対応したことも示されました。TPU 8t/8iの系統自体は以前から公表されており、派生型のTPU 8txとTPU 8i Maxを扱った記事でも整理しています。今回の発表での位置づけは、エージェント時代の基盤としての再提示です。

ストレージでは、Google Cloud Managed Lustreが最大で毎秒10TBの読み取りスループット、RDMA経由のGPUDirect Storage、Cloud Storage Mirroringによる80PBのDynamic Tierを備えるとされています。これらの数値は同社の公表値です。

会場では、McCormick Place Westのブース3418で、Antigravity for HPCやHPC Prompt Playground、AlphaEvolve for HPCのデモが行われます。

IT Postの見方

IT Postでは、この発表の読みどころは「AIの賢さ」ではなく「手順の資産化」にあると考えます。クォータを確認し、容量を試し、設計図と照合して、人間の承認を待つ。スキルの中身は、派手な自律性ではなく、失敗しないための順番そのものです。エージェントに任せられる仕事の範囲は、モデルの賢さより先に、こういう順番がどれだけ書き下ろされているかで決まります。

ハードウェアの列挙は相変わらず豪華ですが、主役の座は段取りに移った。計算資源の競争が「誰の山が一番高いか」から「誰の登山道が一番整備されているか」へ移る兆しとして読むのが、この発表への正しい向き合い方です。

今後どうなりそうか

今後の確認点は、第一に公開されたスキルが実際の研究現場でどこまで使われるか、第二にAlphaEvolve on Cloud Batchの料金と提供範囲、第三にA5Xなど新しい形状の提供地域と価格です。発表時点では、これらの詳細は示されていません。

新しい公式情報が確認できれば、続報として整理します。

情報源

「一次情報」は資料の出所を示す区分で、編集部による独立した実測や、すべての主張の実証を示すものではありません。確認の範囲や未確認の点は、本文の説明と併せてご覧ください。

この記事を共有する

用語辞典へ