AI・生成AI NVIDIA、「Cosmos 3 Nano」の世界モデル4種を重み付きで公開。16Bで運転もロボットも「次の画面」を作る NVIDIAは2026年11月5日、世界モデル基盤「Cosmos 3 Nano」を土台にした事後学習済みチェックポイント4種をHugging Faceで公開。いずれも16Bで、最大11視点のカメラ映像とLiDARの同時生成、物理シミュレータの制御からの映像化、両腕ロボットの動作からの次の観測予測までを担う。商用利用も可能なOpenMDW1.1ライセンスと、4段階の学習レシピもあわせて整理した
まず初めに
「世界モデル」という言葉は立派だが、やっていることは要するに「次に何が見えるか」を当てる仕事である。天気予報のAI版を、道路とロボットアームのために作る。今回NVIDIAが出したのは、その予報士の完成品ではなく、用途別に鍛えた予報士の卵4人組だ。しかも重み付きで、商用利用も条件付きで認める。予報の腕前そのものより、「予報士を育てる型」まで一緒に配ってしまうところに、この会社の本気と余裕がにじむ。
※個人の感想です
何が公開されたのか
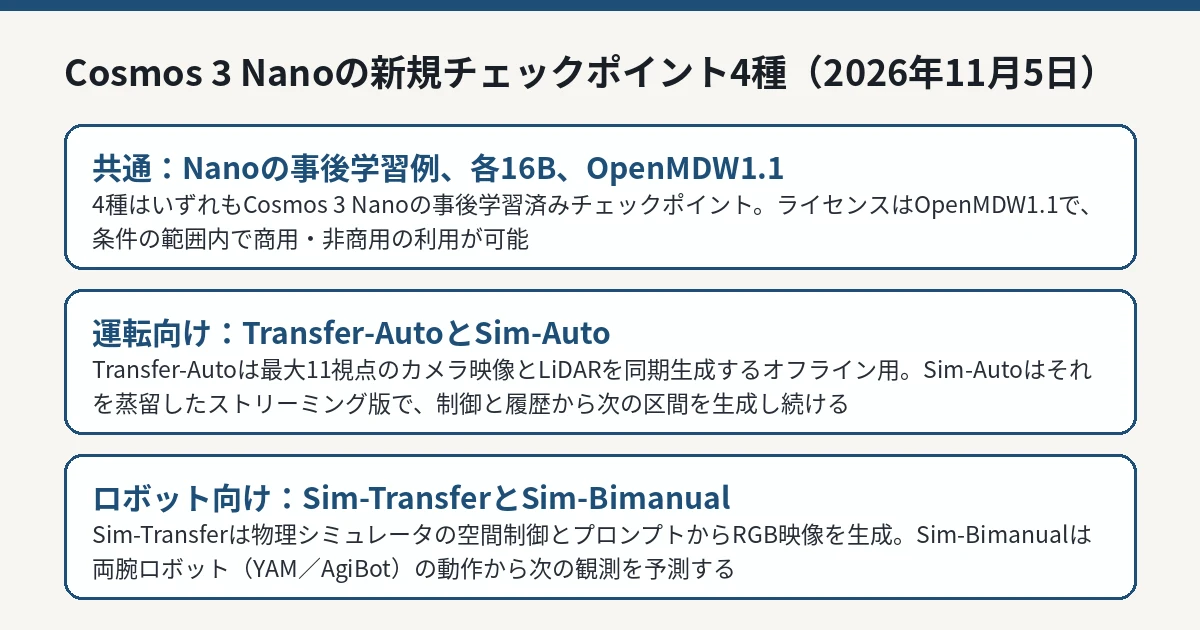
NVIDIAは2026年11月5日、Hugging Face Blogで「Cosmos 3」ファミリーへの新しいオープンなチェックポイント4種の追加を発表しました。4種はいずれも「Cosmos 3 Nano」の事後学習(post-training)の実例という位置づけで、学習可能パラメータは各16Bです。ライセンスはOpenMDW1.1で、その条件の下で商用・非商用の利用が可能とされています。
役割分担は次のとおりです。
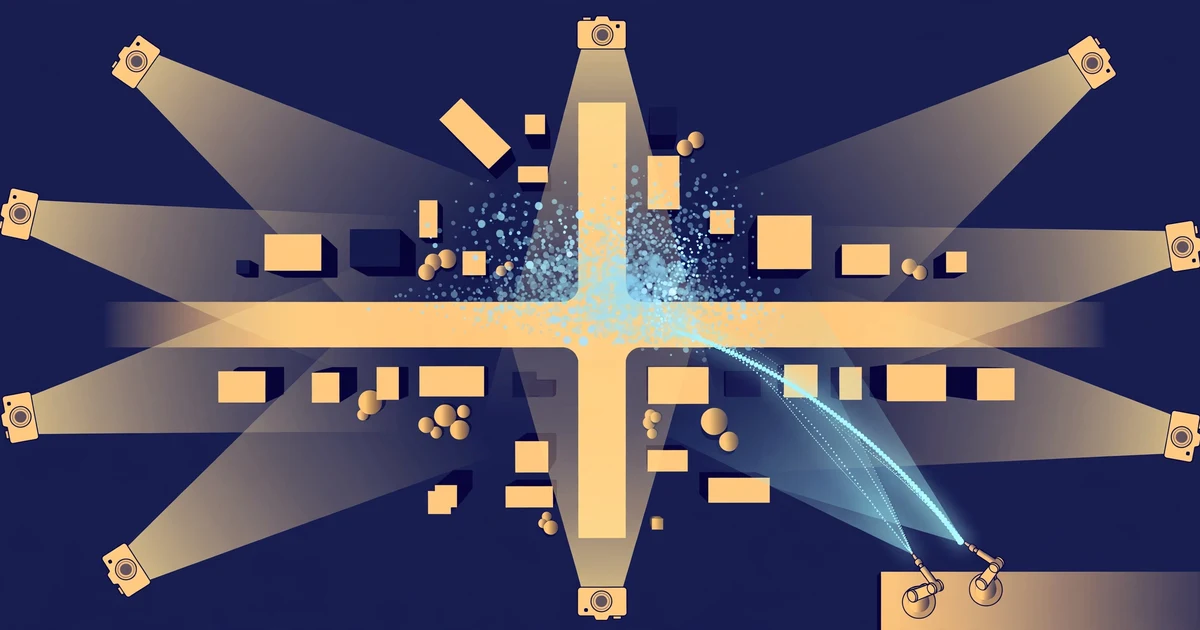
Cosmos3-Nano-Transfer-Auto:運転シーンから多センサーのデータを生成する双方向モデル。最大で魚眼を含む11視点のカメラ映像を同期生成し、RGB映像とLiDARの同時生成にも対応します。カメラごとの「World Scenario Map(WSM)」制御で場面の構造と交通の動きを指定し、テキストプロンプトで見た目を誘導します。天候・照明・時間帯を変えた学習・評価データの拡張が用途です。
Cosmos3-Nano-Sim-Auto:Transfer-Autoを因果的に蒸留したストリーミング版。同期したカメラ映像とLiDARを、数ステップのノイズ除去で小さな塊(チャンク)ごとに生成し続けます。生成済みの履歴と更新される運転制御を使って、速いストリーミングと長い対話的な展開(ロールアウト)を狙います。
Cosmos3-Nano-Sim-Transfer:物理シミュレータの制御から映像を作るモデル。奥行き(Depth)、領域分割(Segmentation)、輪郭(Edges)、粗い見た目(Blur)といった空間制御とテキストプロンプトから、方策(ポリシー)が消費するRGB映像を生成します。物理と実状態はシミュレータ側が持ち、モデルは見た目を描く分担です。
Cosmos3-Nano-Sim-Bimanual:両腕ロボットの動作から環境の変化を予測するモデル。YAMとAgiBotという2つの身体(エンボディメント)での対話的な両腕シミュレーションに対応し、方策または人間のジョイスティック操作で制御します。混合動作の例では59個の制御値を使い、学習時は64にそろえて扱います。
NVIDIAのHugging Face Blog発表(2026年11月5日)に基づく図解です。 IT Post編集部 ストリーミング生成の仕組みと4段階の学習
対話的に「次の画面」を作り続けるための仕組みも説明されています。Cosmos 3の Mixture-of-Transformers 構造が、テキスト処理と視覚生成のネットワークを注意機構でつなぎ、生成側はプロンプトと制御、生成済みの履歴から短い区間を予測します。モデルは圧縮された動画表現(latent)を扱い、最初の画像の後は、1つの潜在時間ステップがRGBの4フレーム分に当たります。小さなチャンクに分けるほど、新しい制御が生成に反映される頻度は上がります。
学習レシピは4段階です。第0段は双方向の適応(記録済みクリップ全体から領域と制御と映像の関係を学ぶ)、第1段は教師あり強制(記録済みの過去の観測から各チャンクを予測する)、第2段は一貫性蒸留(凍結した教師を使い、各チャンクを4ステップのノイズ除去で生成できる生徒を育てる)、第3段は自己強制(生徒自身が生成した履歴を学習に使う)です。少し予測を外した物体が次のフレームの文脈になり、誤差が積み上がる問題への対処として、最後の自己強制が置かれています。
公開された推論の前提も具体的です。Sim-Bimanualの実行要件は、Linux、NVIDIA GPU、Docker、NVIDIA Container Toolkitで、公開されたvLLM-Omni構成はGB200が1台の環境でテストされたもの(最小メモリ仕様ではない)と明記されています。研究室の大型GPUが前提の世界であり、ノートPCで気軽に回す類の公開ではありません。
「動画生成」とは何が違うのか
同じ「AIが映像を作る」でも、狙いは対照的です。前日に紹介したGoogleの動画AI「Gemini Omni 1.2 Flash」 は、人が見る15秒のクリップを速く安く作るためのモデルでした。今回のCosmos 3 Nano系は、人が見るためではなく、運転やロボットの制御方策が「観測」として消費するための映像を作ります。評価軸は「きれいさ」ではなく、制御と幾何(カメラとLiDARの整合)が現実と食い違わないかです。発表記事自身も、「モデルが方策の学習と評価をどこまで忠実に支えられるかを測ること、その限界を理解することが今後の仕事だ」と書いています。生成の派手さではなく、嘘のつき方の少なさが問われる領域です。
なお、今回の発表には、生成品質を数値で示すベンチマーク結果は含まれていません。4種の能力は説明とデモ映像で示される形で、第三者による再現評価はこれからです。
IT Postの見方
IT Postでは、今回の本質は「世界モデルそのもの」よりも「育て方の型を配ったこと」にあると考えます。4種は完成品というより、土台のNanoを自分のセンサー構成やロボットに合わせて事後学習するための実例集です。レシピの4段階、適応の手順、推論の足回りまでそろえて出すのは、「うちのモデルを使ってほしい」ではなく「この土台の上で勝負してほしい」という生態系の作り方です。重み公開の競争が、モデルの配布から「開発の型」の配布へ移りつつあることが分かります。
ただし、型が配られても、検証は配られない。
生成した運転データで学習した方策が、現実の道路で同じように振る舞うかは、誰の発表でも保証されません。「シミュレーションの中で正しい」ことと「現実で正しい」ことの間の溝は、世界モデルが賢くなるほど、かえって見えにくくなります。ここは発表の熱量とは別に、冷やしておくべき部分です。
今後どうなりそうか
今後の確認点は、第三者による生成品質と方策学習への効果の評価、4種以外のチェックポイントの追加、そして自社のセンサーやロボットへ適応した事例が外部から出てくるかです。Cosmos基盤そのものの展開(より大きなモデルや推論基盤との連携)も、NVIDIAの技術ブログ側で続報が出る可能性があります。
IT Postでは、新しい公式情報が確認できれば続報として整理します。