AI・生成AI Baidu、280Bの基盤モデル「ERNIE 5.5 Flash Base」の重みを公開。1回に動くのは14B、でも抱える重みはFP8で約280GB 中国のBaiduは2026年11月5日、総パラメータ280B・活性14BのスパースMoE基盤モデル「ERNIE-5.5-Flash-Base」の重みをHugging FaceとModelScopeで公開。事前学習だけを終えた「Base」の位置づけ、33.5兆トークンの学習、独自ライセンスの条件と評価値の読み方を整理した
まず初めに
「活性化するのは5%だけ」と聞くと、軽いモデルが来たように思える。ところが実際にダウンロードする重みは約280GB。用意する置き場は総パラメータ分まるごとである。MoE (専門家の寄せ集め方式)の請求書は、いつもこの形で届く。使う人数は少なくても、全員の席は確保しなければならない。賢い仕組みだが、財布とストレージには一切優しくない。
※個人の感想です
何が公開されたのか
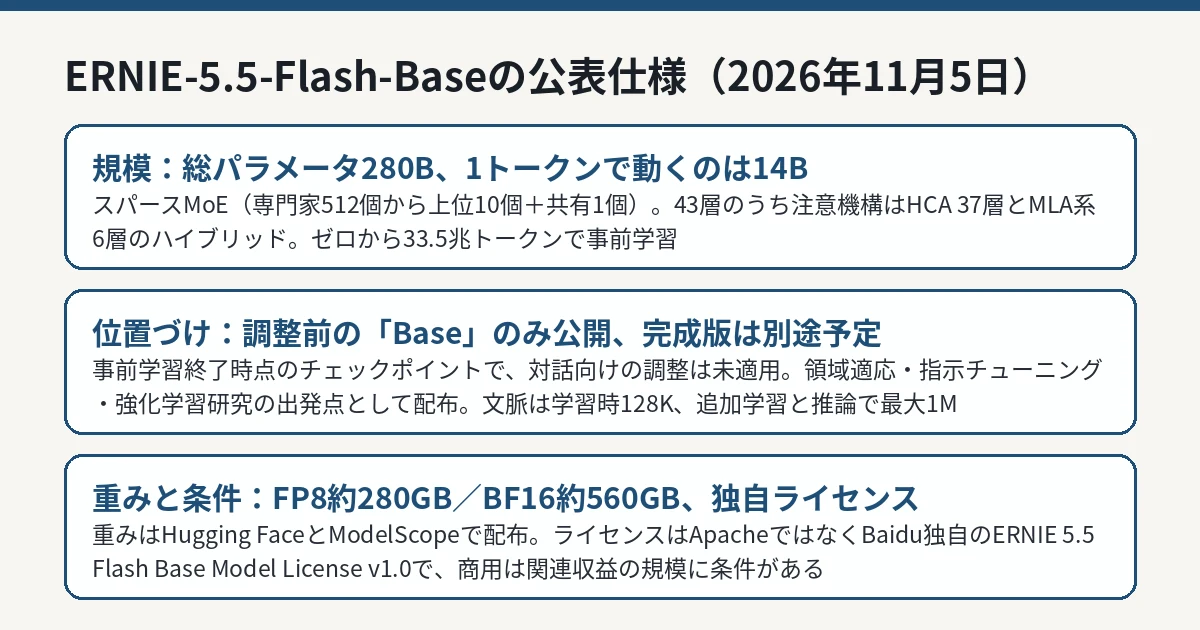
Baiduは2026年11月5日、「ERNIE 5.5 Flash」系統の基盤モデル「ERNIE-5.5-Flash-Base」の重みを公開しました。モデルカードによると、このモデルはゼロから(from scratch)事前学習されたスパース型のMoEモデルで、学習データは33.5兆トークン、学習時のコンテキスト長は最大128K(131,072トークン)です。追加学習(ファインチューニング)と推論では、最大1M(1,048,576トークン)のコンテキストに対応するとされています。
「Base」という位置づけが今回の肝です。公開されたのは事前学習終了時点のチェックポイントで、中間学習も事後学習(対話向けの調整など)も適用されていません。Baiduは、この状態を「領域適応(ドメイン特化の追加学習)、指示チューニング、強化学習研究の共通の出発点」として配ると説明しています。後続の手順で調整された完成版「ERNIE 5.5 Flash」は、別途提供される予定と報じられています。
重みの公開は、中国勢のオープンな重み公開の流れにBaiduが本格的に合流した形でもあります。前日の記事で紹介したPFNの翻訳モデル「PLaMo 3 Translate」 が「最小モデルはスマホで動く」方向の公開だったのに対し、こちらは「データセンターに置いて育てる」方向の公開です。同じ「重み公開」でも、想定する読者はまったく違います。
仕組みと規模
モデルカードに示された主な仕様は次のとおりです。
総パラメータ280B、1トークンあたりの活性パラメータ14B
層数は43層(密なフィードフォワード1層+MoE層42層)
注意機構は、強く圧縮するHCA(Heavily Compressed Attention)37層と、疎な注意を組み合わせたMLA系(MLA-DSA)6層のハイブリッド
MoE層ごとに、ルーティングされる専門家(エキスパート)が512個あり、1トークンで上位10個と共有エキスパート1個を使う
語彙数は201,216、学習にはMuonオプティマイザーを使用
総パラメータには入力埋め込みと出力ヘッドを含み、別途ある推測デコーディング用のECHOモジュール(0.36B)は総数・活性数のどちらにも含まない
Baiduのモデルカード(2026年11月5日公開)に基づく図解です。重み容量は公表資料の概数です。 IT Post編集部 推論の実行環境としては、SGLangとvLLM(Baiduが公開したvLLM-ERNIEプラグイン)が案内されています。Baseモデルであるため、呼び出しは対話形式ではなく、文章の続きを生成する「completions」方式が前提です。公開資料では、100万トークンの長文脈を扱う構成例として、大容量メモリを持つGPUを複数枚組み合わせる設定が示されています。個人のPCや1枚のGPUで気軽に試す規模ではないことは、重みの容量からも明らかです。
評価の数字の読み方
Baiduはモデルカードで、同じ評価パイプライン・同じプロンプト・同じ条件で測った比較表を公開しています。代表的な値は、知識評価のMMLUで93.3(比較対象のDeepSeek-V4-Flash-Baseは89.4、Hy3-preview-Baseは87.5、MiMo-V2.5-Baseは87.6)、推論評価のGPQAで60.2、コード評価のHumanEval+で82.3、長文脈評価のLongBench-v2で48.7です。
ただし、これはBaidu自身が設計した統一パイプラインによる自社測定です。比較対象も同社が選んでおり、「同じ土俵で測った」という意味では条件はそろっていますが、土俵そのものは主催者の持ち物です。第三者による再現評価が出るまでは、「公表値としては強い」という読み方にとどめるのが妥当です。特にMMLUの93.3という値は基盤モデルとしては非常に高く、ここは再現確認が最も必要な部分でもあります。
ライセンスは「独自」で、Apacheではない
重みは無料でダウンロードできますが、ライセンスはオープンソースで一般的なApache 2.0ではなく、Baidu独自の「ERNIE 5.5 Flash Base Model License Agreement v1.0」です。ライセンス本文(2026年11月5日付、11月6日改訂)によると、商用利用は関連収益が年5,000万米ドル相当を下回る範囲ではライセンス料なしで可能とされ、「Powered by ERNIE」の表示と、Baiduへの一度きりの通知が求められます。一定規模を超える利用には別途の許諾が要る設計で、地域に関する制限も含まれます。「重みが公開されている=条件なしで自由に使える」ではありません。業務で使う場合は、ライセンス本文を先に読む必要があります。
IT Postの見方
IT Postでは、今回の面白さは性能表よりも「Baseだけを出す」という配り方にあると考えます。完成品のチャットモデルではなく、事前学習の終わった土台だけを渡す。調理済みの料理ではなく、仕込み終わった出汁を渡すようなものです。受け取る側に追加学習の資金とGPUがなければ、出汁は冷蔵庫(ストレージ)の中で場所を取るだけです。280GBという容量が、そのまま「誰のための公開か」を物語っています。
もう一つは、Baiduの姿勢の変化です。同社は長くクローズドな提供を続けてきた側ですが、ERNIE 4.5系統から重み公開へ舵を切り、今回は最新系統の基盤まで出してきました。元・白物家電の王国ならぬ、中国の検索大手が「土台を配って育ててもらう」側に回るのは、それだけオープンな土台の生態系が無視できない力を持ったということでしょう。ただし、独自ライセンスの収益条件と地域制限は、完全なオープンとは距離があります。「公開」と「自由」は別の言葉だ、という当たり前を再確認させる公開でもあります。
今後どうなりそうか
今後の確認点は、第三者によるベンチマーク再現が出るか、事後学習済みの「ERNIE 5.5 Flash」完成版がいつ・どの条件で提供されるか、そして日本語を含む多言語評価がどう示されるかです。100万トークン対応やFP8の容量といった仕様は魅力的ですが、評価の裏付けが自社測定の段階では、導入判断の材料はまだ半分しかそろっていません。
IT Postでは、新しい公式情報が確認できれば続報として整理します。