AI・生成AI 65Bの「密」なモデルが、975Bを端末作業で上回ったと主張。Ricursive「Ripple-65B Preview」をApache 2.0で公開 半導体設計AIのRicursive Intelligenceは2026年11月4日、65Bパラメータの密な(dense)モデル「Ripple-65B Preview」の重みをHugging FaceでApache 2.0公開。12兆トークンでゼロから学習し、文脈は最大約105万トークン。同社測定のTerminal-Bench 2.1で80.52を掲げ、8〜15倍のMoE勢を上回ると主張するが、評価は自社実施で、他の指標では後れも残る。数字の読み方を整理した
まず初めに
巨大モデルの自慢合戦に、半導体設計の会社が「うちは65Bで十分」と割り込んできた。しかも最近の主流である「専門家の一部だけ働かせる」方式ではなく、全員出勤の密な設計で、だ。パラメータの物量で殴る時代に、人数ではなく鍛え方で勝負するという宣言は痛快である。ただし、スコア表の主催者は同社自身。痛快さと検証済みかどうかは、きっちり分けて読む必要がある。
※個人の感想です
何が公開されたのか
Ricursive Intelligenceは、AIで半導体設計を支援する技術を持つ企業です。同社にとって初の公開言語モデルとなる「Ripple-65B Preview」を、2026年11月4日にHugging Faceで公開しました。社内のチップ設計基盤で使われてきたモデルの汎用版、という位置づけが報じられています。
仕様の要点は次のとおりです。
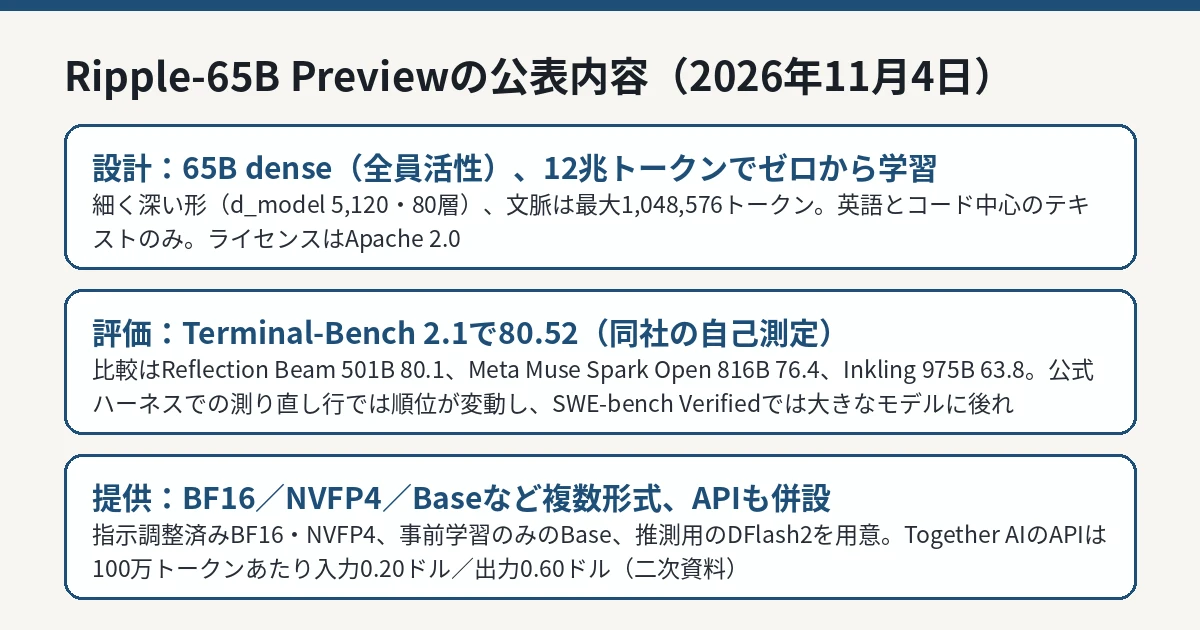
総パラメータ65Bの密なTransformer。全パラメータが毎トークンの処理に参加する
英語とコード中心のテキストのみのコーパス12兆トークンで、ゼロから事前学習。学習時の系列長は8K
対応文脈は最大1Mi(1,048,576トークン)
形は「細く深く(thin-and-deep)」で、隠れ次元(d_model)5,120、層数は80層
ライセンスはApache 2.0で、商用利用・改変・再配布が可能
公開形式は複数あり、指示調整済みモデルのBF16版(このリポジトリ本体)とNVFP4版、事前学習のみのBase版、推測デコーディング用の小型ドラフトモデル(DFlash2)などが用意されています。モデルカードでは、65B級であればNVIDIA DGX Sparkのようなコンシューマー向けハードウェアにも載せられるとし、NVFP4のチェックポイントとColabが案内されています。前日の記事で紹介したBaiduの「ERNIE-5.5-Flash-Base」 が「総280B・活性14B」のMoEエムオーイー だったのとは対照的に、こちらは「総65B・全員活性」の正反対の設計です。
Ricursive Intelligenceのモデルカード(2026年11月4日公開)に基づく図解です。評価値は同社公表値です。 IT Post編集部 評価の数字——強い表と、正直な表が同居する
モデルカードの目玉は、Terminal-Bench 2.1の80.52です。これは、AIエージェントがコマンドライン環境で実作業をどこまで完遂できるかを測る評価で、同社の表では米国の公開モデルの中で最高水準と位置づけられています。比較対象と値は、Reflection Beam 501Bが80.1、Meta Muse Spark Open 816Bが76.4、Thinking Machines Inkling 975Bが63.8、NVIDIA Nemotron 3 Ultra 550Bが56.4です。
ただし注意点が2つあります。第一に、この80.52はモデルカード上で「self-reported」と明示された同社の自己測定です。第二に、同じモデルカードの別行では、公式のTerminus 2ハーネス(128K系列長・要約あり)で測り直した値も併記され、モデルによって順位が入れ替わります。たとえばMuse Spark Openは78.7、Beamは70.8と、自己申告行とは顔ぶれが変わります。測り方で順位が動くこと自体、同社が表に出しているのは正直な開示です。
さらに同じ表では、SWE-bench VerifiedでRippleが76.5に対し、Beam 81.6、Muse Spark Open 78.7、Inkling 77.6と、大きなモデルに後れを取る項目もあります。同社は事後学習が比較的軽く、エージェント型コーディングに絞った調整だと説明しています。「全面で最強」ではなく「端末作業に特化して頭一つ抜けた(という同社測定)」が、正確な読み方です。
効率面の主張も大きく、同社はコード領域での計算効率が自社の検証用ラダー比で16倍、最終の大規模学習では55倍まで広がったとしています。開発全体のコストは約3,200万ドルで、従来の同種の最良モデルの約10分の1だったとも述べています。これらも同社の公表値であり、第三者の監査を受けた数字ではありません。
提供面では、重みの無料公開に加え、Together AIでホスト型APIも提供され、価格は100万トークンあたり入力0.20ドル・出力0.60ドルと案内されています(二次資料による)。
IT Postの見方
IT Postでは、今回の面白さは「MoE全盛へのカウンター」として密なモデルが帰ってきたことだと考えます。ここ数年の大型公開は、総パラメータを膨らませて活性分だけ働かせる方式が主流でした。そこへ「65B全員出勤で、975Bの専門家集団に端末作業で勝った(自社測定)」という話が出ると、物量の物差しそのものが疑わしくなる。学習データの作り方と学習の進め方が、規模の差をどこまで埋められるのか。その問いへの、かなり挑発的な回答です。
同時に、数字の扱いには冷たさも必要です。80.52は自己申告であり、測り直しの行では順位が動く。開発費3,200万ドルも同社の言い分です。主張が大きいモデルほど、第三者の再現評価が出るまでは「公表値としては強い」にとどめるのが、このサイトの読み方です。もっとも、自社に不利な行(SWE-bench Verifiedの後れ、測り直しでの順位変動)まで同じ表に載せている点は、数字の出し方としては誠実な部類に入ります。Apache 2.0で重みも検証材料もそろっている以上、再現する側の条件は整っています。
今後どうなりそうか
今後の確認点は、第三者によるTerminal-Bench 2.1の再現評価が出るか、「Preview」の名が外れた正式版で事後学習がどこまで厚くなるか、そしてNVFP4版を個人級ハードウェアで動かす実例が増えるかです。効率の主張(16倍・55倍、3,200万ドル)が再現されれば、大型モデルの開発費の相場そのものに影響しかねません。
IT Postでは、新しい公式情報や独立した評価が確認できれば続報として整理します。