IT Post

by Rice Studio Lab


記事を検索
文字サイズ
ふりがな
AI・生成AI

Googleの世界モデル「Genie 4」は、世界に音まで付けた。映像生成ではなく『触れるシミュレーション』に寄せた一手

Google DeepMindが2026年10月27日、世界モデル「Genie 4」を発表した。映像に加えて音楽・環境音・対話までを同時に生成し、自然言語で場面をリアルタイムに書き換えられる。Geminiとの役割分担、提供範囲、公表された限界を整理する

30秒で分かる結論

  • Google DeepMindは2026年10月27日、リアルタイム対話型シミュレーションのための世界モデル「Genie 4」を発表しました。世界そのものの生成に加え、音楽、環境音、登場人物の対話といった音声までを同時に生成する「ネイティブにマルチモーダル」な設計が特徴です。
  • 場面の途中で自然言語により、天候の変更、カメラの移動、新しい人物や物の追加といった指示を出せます。一貫性の維持や複雑な出来事の段取りはGeminiモデル群が担い、Gemini 3.8 Flashが案内役として目標を手順に分解し、進行を確認します。
  • 提供は研究プレビューとして信頼できるテスターから開始し、Project GenieにおけるGoogle AI Ultra契約者と、Gemini APIおよびGoogle AI Studioの早期アクセスパートナーへ広げる予定です。一般提供の日程は示されていません。
この記事の目次 9項目
出典を確認する(2件)
ガラスの球の中に川と木々と小さな人々のいるミニチュアの世界があり、その上に音波と音符が漂い、手が天気を調整しているイラスト
生成AIによるイメージイラスト。実際の製品画面ではありません。 IT Post編集部

まず初めに

動画生成AIはこれまで、「いかに本物らしく見えるか」の競争だった。そこへ「音も付けます、途中で天気も変えられます、人物は喋ります」と全部盛りで来られると、これはもう動画ではなく、粗くても中に入れる世界である。前モデルから1年あまり、「生成」と「シミュレーション」の境目をわざと曖昧にしに来た感じがする。もちろん中に入れる時間はまだ短いし、細部は平気で崩れる。その「まだ」を公式が自分で列挙している点も含めて、今の実力を測る材料はそろっている。

※個人の感想です

何が起きたのか

Google DeepMindは2026年10月27日、公式ブログで「Genie 4:世界シミュレーションの新世代」と題して、世界モデル「Genie 4」を発表しました。

同社によると、Genie 4はGeminiファミリーの能力を取り込んでいます。Gemini Omniがシミュレーションを現実世界の見た目と振る舞いに結び付け、他のGeminiモデルが、シミュレーションの一貫性と連続性を保つために必要な複雑な推論を提供する、という役割分担です。

利用者は出来事のきっかけを設定し、Genie 4が「次に何が起きるか」——世界がどう応答し、どんな音がし、人々がどう動き、反応し、話すか——をシミュレーションします。同社は、世界を理解しシミュレーションすることを汎用人工知能(AGI)に向けた重要な要素と位置付け、安全で無限に変化させられるシミュレーションが、ロボットやエージェントの訓練環境の開発や、新しい対話型体験の創出に役立つとしています。

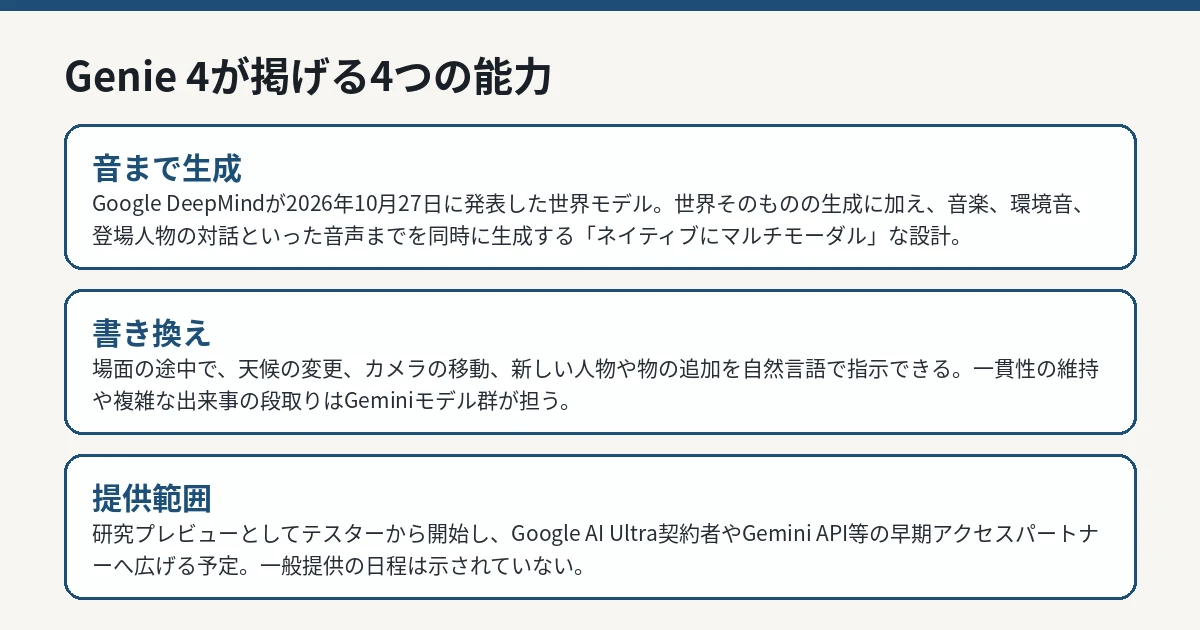
Genie 4が掲げる4つの能力(リアルタイムな書き換え、物理と人の動きの写実性、音の生成、Geminiによる複雑な出来事のシミュレーション)
公式発表の内容をもとに編集部が作成した図。 IT Post編集部

4つの能力

公式ブログは、Genie 4の前進を4つの能力で説明しています。

1. リアルタイムに世界を書き換える

自然言語でシミュレーションをその場で変更できます。例として、天候を変える、カメラを動かす、新しい人物や物を登場させる、といった指示が挙げられています。利用者の入力の合間にも、Geminiが場面を監視して方向付けし、世界がまとまりを持って進行するよう保つとされています。

2. 物理と人の動きの写実性

空気力学や衝突など、現実世界の物理シナリオをシミュレーションするとしています。最も劇的な飛躍は人の描写で、自然に動き、環境に有機的に反応し、リアルタイムに対話的に誘導できるキャラクターを生み出す、という説明です。テクノロジーメディアのTechCrunchは、Genie 4が一貫した場面を最大2分間保てるようになり、前世代の限界の2倍になったとも報じています。

3. 世界の「音」を生成する

Genie 4は、同社にとって初めて音声をネイティブに生成するリアルタイム世界モデルだとされています。木々の風の音から浜辺の波の音まで、場面ごとの環境音が付きます。さらに、登場人物同士の対話が、利用者の入力や世界で起きた出来事に反応してその場で適応する「対話的な会話」も導入されました。発表に添えられた音声はすべてGenie 4が直接生成したものだ、と同社は述べています。

4. Geminiと組んで複雑な出来事を段取る

複数段階の出来事をモデル化するため、Gemini 3.8 Flashがループ内の案内役(ガイディングエージェント)を務めます。Genie 4が世界を生成する間、Geminiが場面を継続的に観察し、目標を一連の手順に分解し、入ってくるフレームを確認して、各手順が成功したかを検証します。世界が変化したり利用者が介入したりすれば、Geminiはその場で計画を適応させる、という仕組みです。

この能力の実験として、同社はGemini 4 ArgonとGenie 4をGemini Roboticsの研究と組み合わせています。例として、Argonが利用者の指示したタスクを手順に分解し、その手順をテキストのキャプションとして生成中のシミュレーションに差し込み、Apptronikのヒューマノイド「Apollo」がチェッカー(ボードゲーム)をする場面をシミュレーションする様子が紹介されました。

誰が使えるのか

提供は段階的です。まず研究プレビューとして信頼できるテスターへの展開を開始し、フィードバックを集めたうえで、利用者と開発者へ広げます。最初の対象は、Project GenieにおけるGoogle AI Ultra契約者と、Gemini APIおよびGoogle AI Studioの早期アクセスパートナーで、Project Genie向けの待機リストも案内されています。

信頼できるテスターの試用分野として、映画制作者によるプリビジュアライゼーション(撮影前の可視化)、写真報道に携わる人々による歴史的場面や災害の展開のシミュレーション、ゲーム開発者によるプロトタイプ作成、企業パートナーによるシナリオ生成などが挙げられています。

公表されている限界と安全策

同社は限界も明記しています。Genie 4は短いセッションでは一貫した環境を保てるものの、時間が経つにつれて、特に複雑な指示の編集を重ねたり場面内を移動したりすると、視覚的な細部や物体の永続性がずれたり漂ったりすることがあります。複雑な物理的相互作用、リアルタイム音声の正確さ、読める文字の描画、空間の正確さ、長期的な一貫性は、研究が進行中の領域だとしています。

安全面では、同社の他のモデルと整合する厳格なガードレールを備え、プレビューに先立って有害・悪意のあるコンテンツの生成を防ぐ内部の安全評価を行ったとしています。また、Genie 4で生成されたすべての動画と音声には、AI生成コンテンツの識別を助ける電子透かし技術「SynthID」が含まれます。

私たちへの影響

一般の利用者が今日から使える製品ではありません。影響はまず、映像・ゲーム・シミュレーションの「試作」の作り方に現れます。撮影やエンジンのコードを書く前に、音と対話まで付いた試作品を数秒で作り、その場で条件を変えて試す、という使い方がテスターの事例として示されているからです。

もう一つは、ロボットやエージェントの訓練です。現実の環境では試しにくい手順を、仮想世界の中で先に試す用途は、同社のGemini Roboticsとの実験が示す方向です。ただし、これは現時点では研究実験の段階であり、実用化の時期は示されていません。

初心者が知っておくべきこと

Q. 「世界モデル」と動画生成AIは何が違うのですか。

A. 動画生成AIは、指示に沿った映像を作って終わりです。世界モデルは、その世界の「次に何が起きるか」を、利用者の操作や介入に反応しながら生成し続けます。Genie 4の場合、途中で天候を変えたり人物を足したりでき、その結果が世界の続きに反映される点が違いです。

Q. 音まで生成するのは、効果音を後から付けているのですか。

A. 公式の説明では、環境音や音楽、人物の対話は、世界と同時にモデルが生成する「ネイティブ」な音声だとされています。発表動画の付随音もGenie 4が直接生成したものだと明記されています。

Q. いつ使えるようになりますか。

A. 現時点では研究プレビューで、対象は信頼できるテスターから始まります。次に対象となるのはProject GenieのGoogle AI Ultra契約者と、Gemini APIおよびGoogle AI Studioの早期アクセスパートナーで、一般提供の時期は公表されていません。

IT Postの見方——勝負は画質ではなく「段取り役」を付けたこと

IT Postでは、Genie 4の本質は画質の向上ではなく、生成モデルに「段取り役」を付けた設計だと考えます。Genieが世界の見た目と音を1コマずつ作り、Geminiが目標を手順に分け、進み具合を見て、崩れたら計画を直す。作る側と見る側を分けたことで、「言われた物を出す生成」から「目的に向けて進むシミュレーション」へ、役割の置き方が一段変わった。ロボットの実験で、タスクの分解結果をキャプションとして流し込む形にしたのも、この設計の延長である。

とはいえ、公式自身が認める限界——2分程度の場面維持、物体の永続性の漂い、文字の描画——は、実務の試作で一番困る種類の弱点でもある。映画のプリビズやゲームの企画段階なら「雰囲気の合意形成」には十分使えても、正確さが要る訓練データにそのまま使える段階ではない。評価すべきはデモの派手さではなく、次にこの「漂い」がどこまで減るかだ。世界モデル競争は、見た目の勝負から、時間に耐える勝負へ移っている。

※個人の感想です

今後どうなりそうか

焦点は2つあります。第一に、Project GenieのGoogle AI Ultra契約者向け提供がいつ始まり、どの程度の長さと正確さのシミュレーションが安定して使えるか。第二に、Gemini Roboticsとの組み合わせのような「段取り役付きシミュレーション」が、研究実験から開発者向けの道具へ進むかどうかです。
IT Postでは、提供開始や仕様の続報が出た場合は、本記事を更新して追います。

情報源

「一次情報」は資料の出所を示す区分で、編集部による独立した実測や、すべての主張の実証を示すものではありません。確認の範囲や未確認の点は、本文の説明と併せてご覧ください。

この記事を共有する

用語辞典へ