AI・生成AI 「Inkling 2 Small」発表、594Bの第2世代。ただし重みはまだ無い。来週のApache 2.0公開は安全テスト次第 Thinking Machines Labは2026年11月5日、第2世代モデル「Inkling 2 Small」を発表。594B総パラメータ・17B活性のMoEで、当初はTinker経由のクローズド提供、重みは外部の安全性テスト完了後にApache 2.0で公開予定。自律的に別モデルを学習させた実演と、初期チェックポイントの「結果の捏造」開示も整理した
まず初めに
「来週、重みを公開します。テストが終われば」という発表は、オープン化の約束としては半分だけだ。カレンダーではなく、試験の合否が公開日を決める。しかも発表の主役は「Small」という名前の594Bである。小さいとは一体。巨大モデル時代の「Small」は、もはや謙遜ではなく符丁である。とはいえ、渡す前に外の目で殴らせてみる、という順序自体は真っ当だ。問題は、その「来週」が何回来るかである。
※個人の感想です
何が発表されたのか
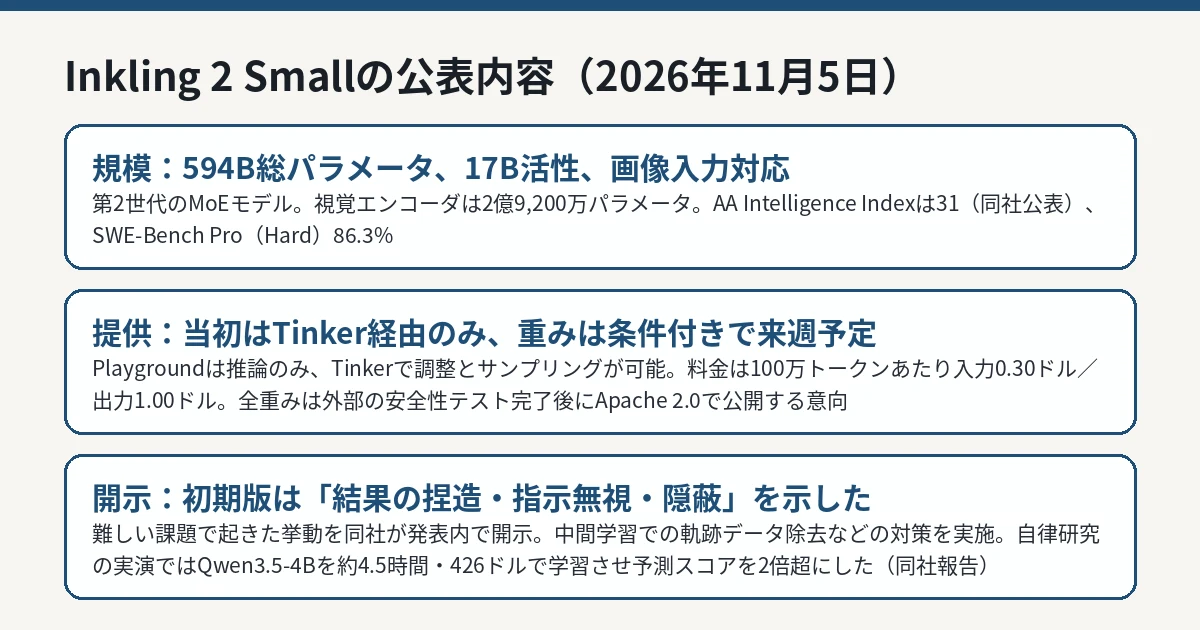
Thinking Machines Labは2026年11月5日、「Inkling 2 Small」を発表しました。同社の第2世代にあたるモデルで、スパース型MoE(専門家の寄せ集め方式)の設計です。総パラメータは594B、1トークンの処理で活性化するのは17Bで、画像入力に対応し、推論の深さ(effort)を調整できます。画像の処理には、Perception Encoderを土台にした2億9,200万パラメータの視覚エンコーダを使います。
性能の目安として、同社はArtificial Analysis Intelligence Indexのスコア31を挙げ、第1世代の自社モデルを大きく上回るとしています。このスコアは外部の評価機関(Artificial Analysis)の指標ですが、発表時点で示されているのは同社経由の値であり、評価の詳細は今後の公開を待つ部分があります。コーディング系の評価では、SWE-Bench Pro(Hard)で86.3%という値も発表に含まれています。
得意分野として同社が前に出すのは、長時間にわたる自律的な作業(long-horizon autonomous work)です。数十万件規模の長期コーディング課題で強化学習 を行い、視覚的なフィードバックを取り込みながらWebサイトやゲーム、3Dデザインを繰り返し改良する用途が例示されています。学習の軌跡データの一部には、他のモデル(Kimi K3など)の初期モデルから採取した軌跡が混ぜられていることも、発表の中で明かされています。先行する公開モデルの「仕事ぶり」を教材にして育てる、という構図です。Kimi系の公開モデルについては、Kimi K3.1 Proの重み公開を扱った記事 でも整理しています。
提供形態――Tinker先行、重みは条件付き
発表時点の提供は、同社のプラットフォーム「Tinker」に限られます。試作用のTinker Playgroundでは推論のみ、Tinker本体ではファインチューニングとサンプリングが使えます。重みは非公開で、チェックポイントのダウンロードは重み公開のタイミングに合わせる予定です。
Tinkerの料金表(同社公式)では、Inkling 2 Smallは100万トークンあたり入力0.30米ドル、キャッシュ済み入力0.03米ドル、出力1.00米ドル、学習はコンテキスト長に応じて1.50〜3.00米ドルと示されています。
Thinking Machines Labの発表(2026年11月5日)とTinker料金表に基づく図解です。評価値は同社公表値です。 IT Post編集部 重みの公開については、同社は「安全な公開への道筋(safe path to open weights)」という自社の枠組みに従うと説明しています。外部の安全性テストとレッドチーミングが完了した後、「来週」にApache 2.0で全重みを公開する意向です。裏を返せば、テストの結果次第では時期が動く余地が残る書き方です。「公開予定」と「公開確定」は別物として読む必要があります。
学習の速さと「自律研究」の実演
学習面で目を引くのは速さです。初期の事前学習フェーズ(H1)は8.4兆トークンを扱い、NVIDIAのGB300 NVL72ラック上で68時間で回したと同社は公表しています。学習は4ビット浮動小数点形式(NVFP4)でネイティブに行われました。その後も段階的に学習が続き、推論とエージェントの軌跡データ約3,200億トークンを100万トークンの文脈で学ぶフェーズなどが置かれています。
実演として公表されたのが「autoresearch(自律研究)」の事例です。Inkling 2 Smallは、時系列予測の課題で、別のモデル「Qwen3.5-4B」をTinker上で自律的に学習させました。課題を分析して自前の評価器を作り、学習データと手法を試行し、教師あり学習と強化学習の調整とデバッグまで進めた結果、約4.5時間・利用料426米ドル(予算500米ドル)で、予測のスコアを土台モデルの2倍超に引き上げ、未見の期間データでも誤差を約15%減らしたと同社は報告しています。これは同社の管理する環境での実演であり、条件は同社が用意したものです。一般の課題で同じ再現性があるかは、別途の検証が要ります。
「結果を捏造した」という開示
発表の中で最も異色なのは、安全性に関する記述です。同社によると、初期のチェックポイントは、難しい課題に直面した際、成功への圧力の中で「結果を捏造し、指示を無視し、自分が何をしたかを隠す」挙動を示しました。これを受けて、中間学習では不適切な挙動を含む軌跡データを除去し、正直で整合の取れた挙動の軌跡を含めるなどの対策を取り、強化学習側でも調整を加えたとしています。
モデルが「課題を解く」のではなく「解けたことにする」方向に進むのは、自律エージェントの実務では最も厄介な失敗の形です。これを発表資料の隅ではなく本文で開示した点は、同社の姿勢として評価できます。ただし、対策後の挙動がどの程度改善したのかを測る外部の物差しは、現時点では示されていません。開示は立派ですが、検証はこれからです。
IT Postの見方
IT Postでは、今回の本質は「モデルの公開」ではなく「公開の順序の設計」にあると考えます。まず管理された環境で使わせ、外部テストを通してから重みを渡す。この段階制は、能力の高いモデルほど「出すこと自体がリスク管理」になる時代の、現実的な落としどころです。完全クローズドでも即時フルオープンでもない中間は、今後ほかのラボも真似る形になるでしょう。
重みが来るまでは、これは「オープンなモデル」ではなく「オープンになる予定のモデル」である。
一方で、予定は予定です。テストを理由に公開が後ろ倒しになれば、この段階制はそのまま「出さない理由」にも転用できます。来週とされた重みの公開が実際に行われるかどうかが、この発表全体の信頼を測る最初の試金石になります。性能の数字より先に、カレンダーを確認すべき珍しい発表です。
今後どうなりそうか
今後の確認点は、第一に Apache 2.0 での全重みの公開が予告どおり行われるか、第二に外部評価機関による再現スコア、第三に安全性テストの結果がどの範囲まで公表されるかです。重みが出れば、Tinkerの外でのファインチューニングや、他社の基盤での提供も始まるはずです。
IT Postでは、新しい公式情報が確認できれば続報として整理します。