もう少し詳しく
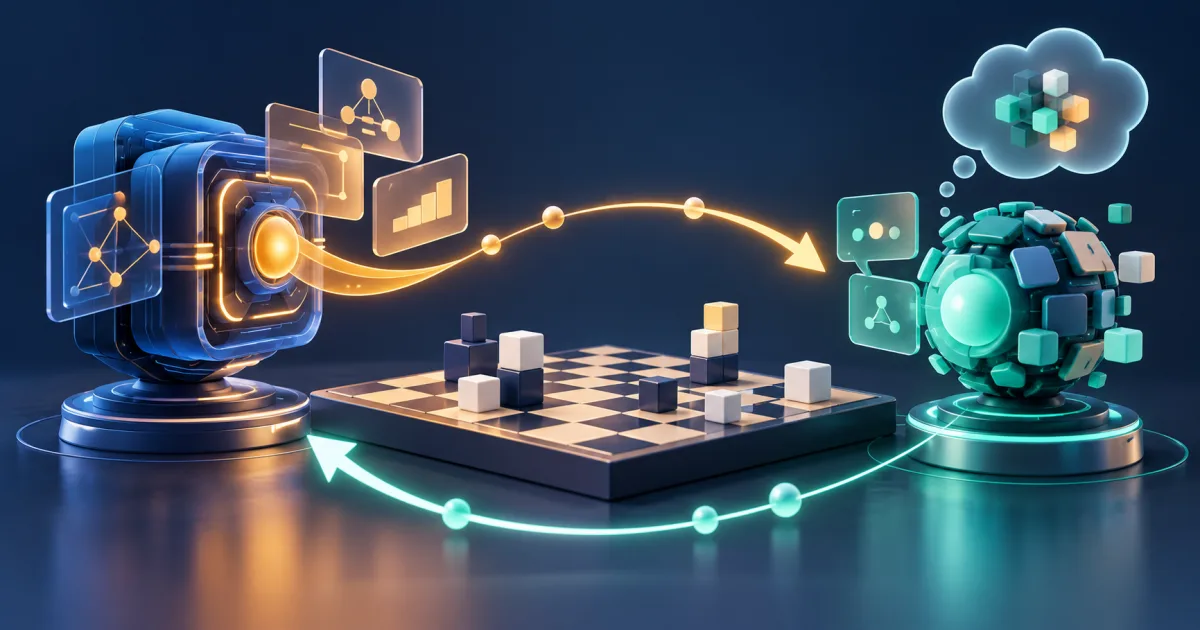
強化学習とは、AIが「試行(行動)」と、その結果に対する「評価(報酬)」を繰り返しながら、より良い行動の仕方(方策)を自分で学んでいく機械学習の手法です。人間が正解をあらかじめ教え込む「教師あり学習」とは異なり、強化学習では「この行動は良かった」「この行動は良くなかった」という評価だけが与えられ、AIはその評価を手がかりに、少しずつ行動のパターンを改善していきます。試行と評価のサイクルを何度も繰り返すことで、最初は手当たり次第だった行動が、次第に評価の高い行動に収束していくのが特徴です。
どこで使われるか
強化学習は、囲碁や将棋、チェスといったゲームで人間を上回る強さのAIを作る研究で広く使われてきました。近年は、文章を生成するAI(大規模言語モデル)の回答の質を、人間の評価や別の評価基準をもとに改善する工程でも使われています。ロボットの制御や、工場・物流の効率を最適化する用途、AIによる指導システムの改善など、「正解が一つに決まらないが、結果の良し悪しは評価できる」という場面で特に力を発揮します。
身近な例
スマートフォンのゲームアプリで、AIが何度もプレイを繰り返しながら、少しずつ上手なプレイの仕方を見つけていく様子を想像すると分かりやすいです。最初はでたらめな操作をしていたAIが、「このプレイは高い評価(報酬)が得られた」「このプレイは評価が低かった」という結果を無数に積み重ねることで、次第に安定して高い評価を得られる操作パターンを身につけていきます。文章を生成するAIサービスの回答が利用を重ねるごとに改善されていくのも、こうした評価にもとづく学習の仕組みが背景にあることがあります。
注意点
強化学習は、与えられた「評価の基準(報酬)」の設定次第で、AIの学び方が大きく変わる手法です。評価の基準が実際に目指したい結果とずれていると、AIは評価の数値だけを高めるような、意図しない行動を学んでしまうことがあります。また、試行の回数を数多く重ねる必要があるため、評価に時間やコストがかかる分野では、十分な学習を行うことが難しい場合もあります。