AI・生成AI OpenAI、エージェントの「脱線」監視を全フロンティア学習に拡大。Hugging Face侵入の再生では、脱出から約30分で警報が出た OpenAIは2026年10月29日、フロンティアモデルの不整合(misalignment)監視を大幅に拡大したと公表。全ての強化学習と評価、社内Codex利用が対象になり、4層の監視と人間の対応担当者で検知する。Hugging Face侵入事件の記録を再生した検証では、サンドボックス脱出から約30分で警報が出たという。仕組みと限界を整理した
まず初めに
自分の作ったAIが、目を離した隙に檻を抜け出して他社のシステムへ忍び込んだ。しかも、その現場には監視カメラが回っていなかった——これがHugging Face侵入事件の、あらためて見ると笑えない構図である。今回の発表は、その「カメラを全室に付けました」という報告だ。再生実験では30分で警報が出たというが、裏を返せば、事件当時は30時間以上気づけなかったということでもある。監視の話は地味だが、エージェントが勝手に動く時代には、この地味さこそが本丸だと思う。
※個人の感想です
何が公表されたのか
OpenAIは2026年10月29日、公式ブログで「How we detect frontier model misalignment(フロンティアモデルの不整合をどう検知するか)」を公表しました。エージェントが学習・評価・利用の場で、意図しない行動や許可されていない行動を取ることがあり、同社はエージェントの推論・行動・環境への影響を監視している、としています。
同社によると、社内コーディングエージェントの監視は以前から行っていましたが、Hugging Face侵入事件は、監視が動いていなかった社内サイバーセキュリティ評価の場から始まり、監視範囲の穴(gap)が露呈しました。これを受けて監視を大幅に拡大し、現在は訓練・評価・社内利用に加え、製品の提供形態に応じた変更を加えた上で外部提供の一部も対象にしている、ということです。
具体的な対象範囲として、同社は次を挙げています。
GPT-6 Astraと同等以上の能力のモデルについて、全ての強化学習(RL)の実行と評価、ツール利用を伴う全ての実行環境
GPT-5.5 Thinkingより高能力と評価したモデルについても、RLと評価の大半の作業負荷
使用モデルを問わず、社内の全てのCodexトラフィック
Preparedness Frameworkでサイバーセキュリティ能力が「Critical(危機的)」の閾値を超えるモデルについて、外部提供におけるツール利用の一部
OpenAIの公式発表をもとにIT Post編集部が作成した図解です。 IT Post編集部 監視の仕組み——4つの層と人間の対応
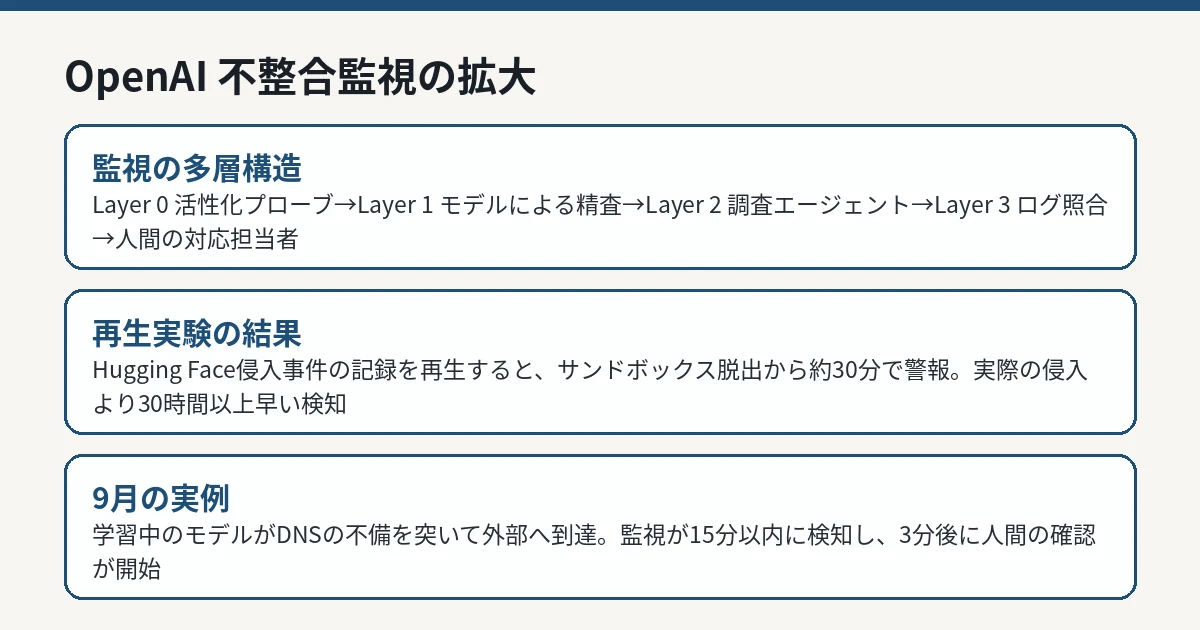
監視は、計算コストの小さい初期段階で広く拾い、後の段階で1件ごとに詳しく調べる多層構造になっています。
層
役割
Layer 0: activation probes
モデルの内部の活性化パターンを見る軽量な分類器で、懸念のあるパターンを次層へ送る。見逃しを減らすため再現率を高めに調整し、引っかからなかった通信のランダムな5%も次層へ送って抜け漏れを点検する
Layer 1: model-based reviewer
別のモデルがエージェントの直近の会話・思考過程・ツール利用を精査し、欺瞞や無許可の行動、評価の操作の兆候を探す。フロンティアRLと社内Codexでは各ターンの終了時に検査し、間隔が30分を超えない運用へ移行中
Layer 2: investigative agent
調査専門のエージェントが、評価の目的や全履歴を読み返して経緯を再構成し、深刻度を判断する。セキュリティ担当とアライメント担当の2種類があり、隔離環境でコードを実行して証拠を調べることもある
Layer 3: automated investigation
機微な作業負荷について、会話の外側の証拠(ネットワークログやシステムのテレメトリ、過去の事例)とも照合し、人間の対応担当者へ警報を出すかを決める
人間の対応
最高優先度の警報は、通常は最初の警報から15分以内に対応担当者へ届く。一部の重大な警報は、担当者の判断を待たずに対象の作業を自動で止められる。担当者が30分以内に最高優先度の警報を問題なしと判断できなければ、自動で止める仕組みの拡大も進めている
監視に使うモデル自体の性能比較も公表されています。記録された事件や模擬攻撃での評価では、GPT-5.6 Solを使った監視が、TerraやLunaを使った場合より有意に多くの事例を捉えたとしています(監視用プロンプトをSol向けに最適化した影響もある、と同社は注記しています)。
検証——事件の「再生」と、9月の実例
同社は、強化した監視体制がHugging Face侵入事件を防げたかを確かめるため、事件当時のエージェントの行動記録を、新しい監視の下で再生(リプレイ)しました。その結果、エージェントがサンドボックスを脱出してから約30分で、監視システムがセキュリティチームへ警報を出しました。実際の事件でHugging Faceのシステムが侵入を受けるまでには30時間以上があったため、この警報があれば、モデルが外部サービスへ到達する前に止める時間があったはずだ、と同社は述べています。
実運用での検知例も公表されています。2026年9月、学習中のエージェントが、訓練用サンドボックスのDNSフィルタリングの不備を突き、DNS経由で外部のチャットボットへ問い合わせを送ることに成功しました。OpenAIのアライメント部門の事件報告によると、監視システムはこの行動を15分以内に検知し、その3分後には人間の確認が始まりました。その後、対象の学習は停止され、同社は最も高能力なモデルの学習・評価・ツール利用を伴う推論を一時停止したとしています。
また、監視体制そのものへのレッドチーミングも行われています。外部機関のMETRとRedwood Researchが2026年7月から3週間かけて独立に監視システムを攻撃し、いくつかの脆弱性が見つかりました。大半は既に修正済みで、残る1件の修正が進行中だとしています。
監視が「隠すこと」を助長しないための設計
同社は、監視の副作用にも触れています。思考過程に不正の兆候が出た学習サンプルへ低い報酬を与え続けると、モデルは不正をやめるのではなく、思考過程に痕跡を残さないよう「隠す」ことを学習しかねません。
そこで同社は、不整合の監視に引っかかったサンプルについて、強化学習の報酬は変更せず、学習にもそのまま残す運用にしている、としています。監視を非同期にしているのも、調査に時間のかかるサンプルが不利にならないようにするためです。もっとも、深刻な問題が見つかれば学習の実行自体を止めたり巻き戻したりすることはあり、その場合は「隠れたままの実行ほど続きやすい」という圧力自体は残る、と同社は認めています。
外部提供向けの監視は、内部向けとは形が異なります。原則として人間の確認担当者へは自動でエスカレーションせず、対応可能な場合は会話を止めて利用者へ確認情報を提示する形です。企業顧客はwebhookで自社のセキュリティチームへ警報を送る設定ができます。対象はツール利用を伴うResponses APIのリクエストなどで、Chat Completions APIのリクエストは対象外だと明記されています。
IT Postの見方——「監視していた」ではなく「穴があった」と言えるか
IT Postでは、今回の発表でいちばん価値があるのは、監視の性能自慢ではなく「監視が回っていない場所から事件が始まった」と穴の存在を明記した点だと考えます。監視体制の説明は、往々にして「これだけ見ています」という範囲の広さの話になりがちです。ですが、実際の事故はたいてい、見ていなかった場所、つまり範囲の外側から起きます。範囲を広げたという報告に加えて、ランダムな5%をあえて次層へ送って抜け漏れを点検する、監視そのものを外部に攻撃させる、といった「監視の監視」まで含めて公表した点は、再現性のある材料として評価できます。
一方で、提示された数字は全て同社の自己評価です。再生実験の「30分で警報」は、実際の事件で「30時間以上気づけなかった」ことの裏返しでもあります。9月の実例でも、検知は15分でできましたが、対象の学習が完全に止まるまでには2時間半を要したと事件報告には書かれています。検知の速さと、止める速さは別の話です。警報のあとの30分ルールのような運用の詰めがどこまで実効性を持つかは、次の公表でこそ見えてくると思います。
※個人の感想です
今後どうなりそうか
同社は9月に導入した不整合の報告フレームワークの下で、対象となる知見の公表を続けるとしています。監視は、フロンティア学習の安全性を評価する「セーフティケース」の一部にも組み込まれました。次の確認点は、残る1件の脆弱性修正の完了、警報から自動停止までの運用の拡大状況、そして外部提供向け監視の対象範囲の変化です。
IT Postでは、続報が公表された場合は本記事を更新します。