IT Post

by Rice Studio Lab


記事を検索
文字サイズ
ふりがな
AI・生成AI

文章を書かないAIが来た。Kakao「Kanana-2-v-decide」は確率・選択・スコアだけを返し、応答0.04秒は同社測定

韓国のKakaoは2026年11月6日、判断専用のマルチモーダルモデル「Kanana-2-v-decide」の重みをHugging Faceで公開。文章を生成せず確率・選択・スコアで答える設計、3.67Bの規模と商用可ライセンス、評価値の読み方を整理した

30秒で分かる結論

  • 韓国のKakaoは2026年11月6日、AIエージェントの「判断」に特化したマルチモーダルモデル「Kanana-2-v-decide」の重みをHugging Faceで公開しました。文章は生成せず、確率・選択・スコアの3形式で答えだけを返す設計です。
  • 規模は全体で3.67B(視覚エンコーダ0.49B+言語モデル3.18B)で、自社の「Kanana-2-v-3b」が土台です。NVIDIA H200 GPU 1枚での平均応答時間は0.04秒以内、GPT-6 Lunaの約43倍速いという数字は、いずれもKakaoの測定による公表値です。
  • ライセンスは研究利用だけでなく商用利用も認める「Kanana Open License」です。まず同社のWeb検索や商品カテゴリの自動分類など、社内プロジェクトへ先行適用する計画が示されています。
この記事の目次 7項目
出典を確認する(2件)
確率やスコアを示す3つの円形メーターと、カードを仕分けるトレーのイラスト
編集部が生成したイラストです。実際の製品画面ではありません。 IT Post編集部

まず初めに

大規模言語モデルに「はい・いいえ」を聞くと、たいてい丁寧な前置きと一緒に答えが返ってくる。判断だけが欲しい現場では、その前置き全部が待ち時間であり、コストである。今回のモデルは、その前置きを設計ごと捨てた。喋らない。頷くか、首を振るか、点数を付けるか、それだけだ。潔いというより、もはや割り切りの境地である。

※個人の感想です

何が公開されたのか

Kakaoは2026年11月6日、自社開発のマルチモーダルな意思決定モデル「Kanana-2-v-decide」を、オープンソースプラットフォームのHugging Faceで公開しました。公開されたモデル名は「kakaocorp/kanana-2-v-decide-3b-2611」で、学習済みの重みがダウンロードできます。

このモデルは、利用者の質問に自然な文章で答える通常の大規模言語モデル(LLM)とは設計が異なります。入力に対して、判断結果だけを規格化された形式で返します。土台になっているのは、同社のマルチモーダル言語モデル「Kanana-2-v-3b」です。テキストと画像を同時に扱えるため、文章だけでなく画像を含む判断にも使えます。

出力は3形式――確率・選択・スコア

モデルカードによると、出力形式は次の3種類から選べます。

  • 確率(noul):特定の条件が正しいかどうかの確率を返す
  • 選択(choice):複数の選択肢ごとに確率を示し、最適なものを選ぶ
  • スコア(score):評価段階ごとの確率を反映した精密なスコアを返す

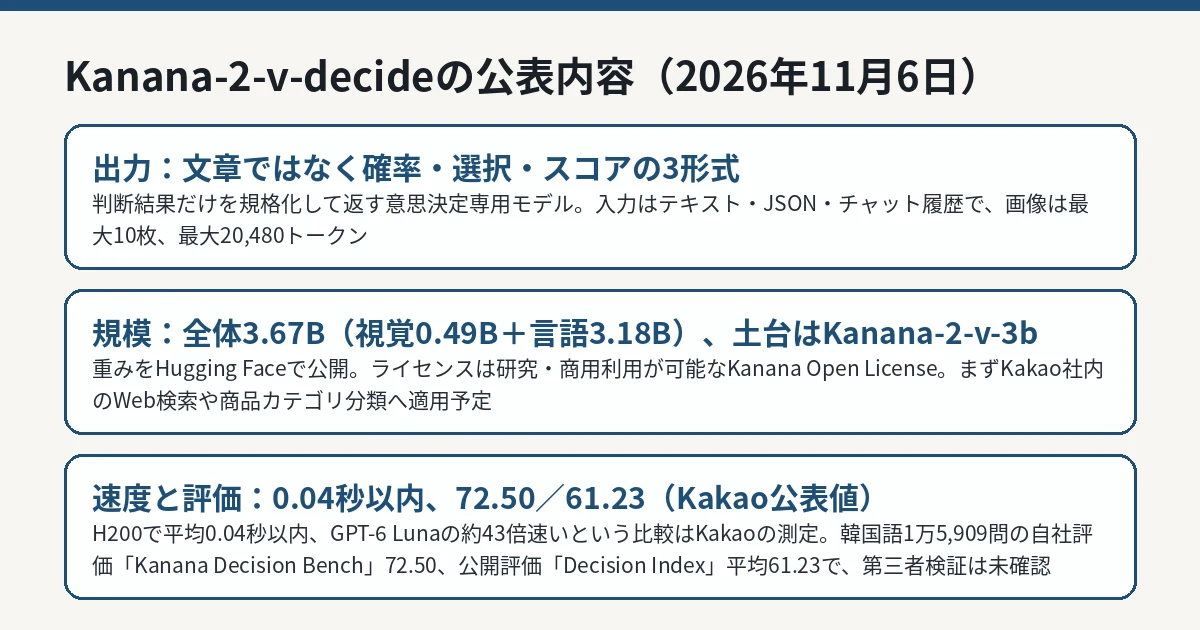
入力はテキスト、JSON形式のデータ、チャットの履歴などで、画像は最大10枚まで、テキストは最大20,480トークンまで扱えます。想定用途として発表で挙げられているのは、破損した商品の写真による交換受付の可否判断、顧客の問い合わせの自動分類、AIエージェントの道具(ツール)選択、商品画像の評価などです。いずれも「長い説明は要らないが、判断は大量にある」種類の仕事です。

Kanana-2-v-decideの公表内容(確率・選択・スコアの3形式、3.67B、H200で平均0.04秒以内はいずれもKakao公表値)
Kakaoのモデルカードと発表に基づく図解です。速度と評価はいずれも同社の公表値です。 IT Post編集部

速度と評価の数字の読み方

Kakaoによると、NVIDIA H200 GPU 1枚の環境で平均応答時間は0.04秒以内で、OpenAIの「GPT-6 Luna」と比べて約43倍速いとしています。判断の精度については、韓国語1万5,909問で構成される同社の自社評価データセット「Kanana Decision Bench」で72.50、公開評価データセット「Decision Index」系では平均61.23と、モデルカードに比較対象の中で最も高い値が示されています。

ただし、これらの速度と評価はいずれもKakao自身の測定・公表によるもので、第三者による検証は確認できていません。特に自社評価データセットは同社が設計した物差しであり、「自社の物差しで自社が1位」という構図は割り引いて読む必要があります。比較対象にはMicrosoftの「Decision-1」、Perplexityの「pplx-decider-v1.1-27B」、Upstageの「Solar Decide」など、同じく判断特化をうたうモデルが並んでいます。

ライセンスと導入の見通し

今回のモデルには、研究目的だけでなく商用利用も可能な「Kanana Open License」が適用されています。重みが公開されているため、自社の環境に置いて動かすこともできます。今朝の記事で紹介したPFNの翻訳モデル「PLaMo 3 Translate」と同じく、「公開された重みを自分の場所で動かす」選択肢が増えている流れの一つです。

Kakaoはまず、Web検索や商品カテゴリの自動分類といった同社の内部プロジェクトにこのモデルを適用し、実サービス環境で性能を磨く計画を示しています。モデルカードでは、標準ライブラリのみで動く推論用サーバーの実装(System One API)も案内されており、重みを自前で抱えて動かす使い方が想定されています。なお、公開資料で前面に出ている評価は韓国語と英語に関するもので、日本語向けの評価は示されていません。日本語の問い合わせ分類などに使う場合は、手元のデータでの検証が前提になります。

同社のAIモデル担当者は、今回の公開について「最新のAI技術を実際のサービスに活用できる基盤を広げることに意味がある」という趣旨のコメントを発表しています。

IT Postの見方

IT Postでは、今回の面白さは性能の数字よりも「文章を生成しない」という設計判断そのものにあると考えます。エージェントが道具を選ぶ、問い合わせを仕分ける、画像を見て可否を決める。こうした判断は1日に何万回も起き、そのたびに文章生成のフルコースを注文していたら、速度も費用も合いません。判断専用の小さなモデルを別に置く、という発想は、巨大モデルの万能さへの静かな反論です。

何でも喋れる部下より、頷き方だけが異常に速い部下が欲しい場面は、実務には確かにある。

一方で、判断の根拠が文章で返ってこない設計は、間違ったときの説明責任と相性がよくありません。確率とスコアだけでは「なぜその分類になったか」を利用者に説明できません。人への影響が大きい判断に使うなら、根拠を残す仕組みは利用側で用意することになります。43倍速いという数字も、物差しは同社製です。割り切りは立派ですが、鵜呑みにする理由にはなりません。

今後どうなりそうか

今後の確認点は、第三者による再現評価が出てくるか、Kakaoの社内プロジェクトへの適用結果が公表されるか、そして日本語を含む他言語への対応が広がるかです。判断特化モデルの比較軸(速度・精度・根拠の残し方)が整理されてくれば、エージェントの部品としての評価もしやすくなります。

IT Postでは、新しい公式情報が確認できれば続報として整理します。

情報源

「一次情報」は資料の出所を示す区分で、編集部による独立した実測や、すべての主張の実証を示すものではありません。確認の範囲や未確認の点は、本文の説明と併せてご覧ください。

この記事を共有する

用語辞典へ