AI・生成AI Salesforceの音声認識「SOV-Transcribe-1」がオープンウェイト首位、WER 2.3%。ただし日本語は対象外 Salesforceは2026年11月12日、音声認識モデル「SOV-Transcribe-1」を公開した。重みはHugging FaceでApache 2.0により配布される。総パラメータ26.6B(アクティブ4.6B)で、音響側にWhisper large-v3のエンコーダ、言語側にGemma 4 26B A4Bを組み合わせる。モデルカードによるとArtificial Analysisの評価でオープンウェイトの非ストリーミング音声認識1位、全体7位で、WERは2.3%。対応言語は英語など7言語で日本語は含まれない
まず初めに
会議の文字起こしは、クラウドに音声を送るのが当たり前の時代である。そこへ「重みを配るから、自分の所で回してほしい」という提案が出てきた。音声は個人情報の塊だ。声そのもの、名前、電話番号、会議の中身。外に出さずに文字化できるなら、それだけで選ぶ理由になる組織は少なくないはずである。
※個人の感想です
何が公開されたのか
Salesforceは2026年11月12日、音声をテキストに変換するモデル「SOV-Transcribe-1」を公開しました。公開先はHugging Faceの同社組織「salesforce-sovereign-intelligence」で、ライセンスはApache 2.0です。あわせて、Hugging Face上に解説ブログ「SOV-Transcribe-1: #1 Open-Weight Model Built for Real-World Speech」も公開されています。
位置づけは、同社の「Sovereign AI」の取り組みの下にあります。二次報道では、政府や企業向けに統制可能なAIを提供する同社のMissionforceの文脈に置かれています。モデルの狙いは、音声データを自社の管理下に置いたまま文字起こしを行うことです。
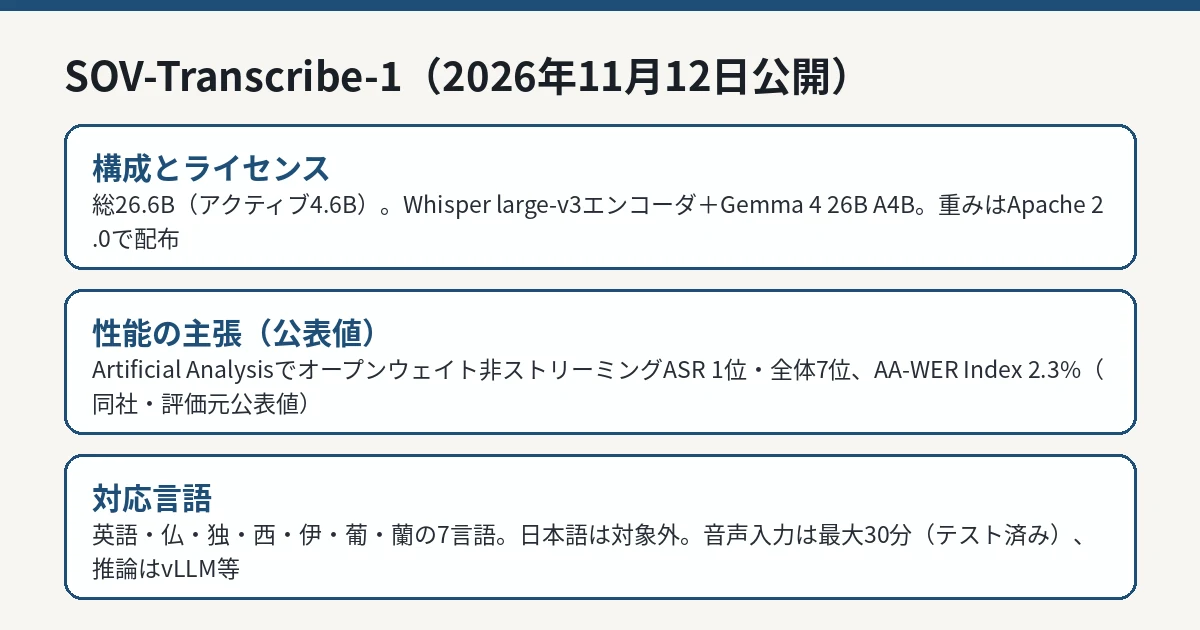
SOV-Transcribe-1の構成、性能の主張、対応言語を整理した図解 IT Post編集部 モデルの中身
モデルカードに記載された仕様は次のとおりです。
項目
内容
総パラメータ
26.6B(アクティブ4.6B、音響エンコーダを含む)
構成
Whisper large-v3の音響エンコーダ+音響プロジェクタ+Gemma 4 26B A4B(MoE)
精度
BF16(MoEルータはFP32)
音声入力
16kHz音声、最大30分まで(テスト済み)
対応言語
英語、フランス語、ドイツ語、スペイン語、イタリア語、ポルトガル語、オランダ語
推論基盤
vLLM、Hugging Face Transformers
ライセンス
Apache 2.0
特徴として同社が挙げるのは、名前や電話番号、メールアドレスといった固有表現の認識精度、アクセントや背景ノイズへの強さ、自然言語の指示で逐語(verbatim)か整形済みかを選べる文字起こしのスタイル制御、そして人名や専門用語などの文脈情報を与えて認識を助ける「コンテキストバイアシング」です。
推論の高速化用には、投機的デコーディングのドラフトモデル「SOV-Transcribe-1-DFlash」が別リポジトリで公開されています。TransformersとvLLMへのネイティブ対応は上流への取り込みが進行中で、それまでは同リポジトリ同梱のコードとvLLMプラグイン(vLLM 0.32.0向け)を使う形です。
性能の主張(公表値)
モデルカードによると、SOV-Transcribe-1は2026年11月12日時点で、Artificial Analysisの評価において、非ストリーミングの音声認識でオープンウェイトモデルの1位、全体7位に位置します。AA-WER Indexでの単語誤り率は2.3%です。テストセット別では、Earnings22で4.1%、VoxPopuliで1.5%と二次報道が伝えています。
もう1つの評価として、besimple AIのVoiceCodeBenchでは、固有表現の正確さとタスク成功率で23システム中2位だとモデルカードに記載されています。英語のアクセント別では、オーストラリア、英国、スコットランド、ウェールズ、アイルランド、インド、メキシコ、シンガポールの8つのアクセントで最良のWERを記録したとブログは説明しています。
これらは同社と評価元による公表値であり、第三者による再現はこれからです。とくに「オープンウェイト1位」は、評価対象の切り方(非ストリーミング限定)を含む順位である点に注意が必要です。モデルカードが想定する用途は会議やメディア、コールセンター等の文字起こしで、逐次(ストリーミング)認識ではなく、録音済み音声をまとめて処理するバッチ型の認識です。
日本語は対象外——国内利用の注意点
国内の利用者にとっての制約は明確です。対応言語に日本語は含まれていません。日本語の会議やコールセンター音声にそのまま使うことはできず、対象は英語を中心とする多言語音声です。
一方で、構成の面では示唆があります。Whisperの音響エンコーダと言語モデルを組み合わせ、指示で文字起こしの形式を制御する設計は、言語を問わず通用する組み立てです。重みがApache 2.0で公開されているため、日本語への適応を試す研究や検証も、ライセンス上は進めやすい形になっています。国内の開発者にとっては、日本語対応の音声モデルを自前で用意する際の設計の参照例として読むのが、現時点では現実的です。
IT Postの見方
IT Postでは、今回の公開の意味は順位そのものよりも、「音声認識の最上位圏に、重みを配るモデルが来た」ことにあると考えます。音声は、テキスト以上に「外のAPIへ送りたくない」データです。政府・防衛向けの文脈(Missionforce)を前面に出す同社の売り方も、その前提に立っています。
ただし、26.6Bという規模は「手元で気軽に回す」大きさではありません。BF16での運用には相応のGPUメモリが要り、恩恵を受けるのは、音声を大量に扱い、かつデータを外に出せない組織に限られます。順位の主張も同社と評価元の公表値の段階です。実務の判断は、自分の音声データでの誤り率を測ってからになります。
今後どうなりそうか
次の確認点は、TransformersとvLLMへのネイティブ対応の取り込み完了、第三者ベンチマークでの再現、そして対応言語の拡張です。日本語が加われば国内での評価は一変しますが、現時点で同社は言語拡張の計画を示していません。
オープンウェイトの音声認識では、MistralのVoxtral SmallやNVIDIAのNemotron 3.5 Transcribeが近い位置にいると二次報道は整理しています。この領域の競争が「クラウドAPIの精度」から「手元で回せる精度」へ移るかどうかが、今後の焦点です。