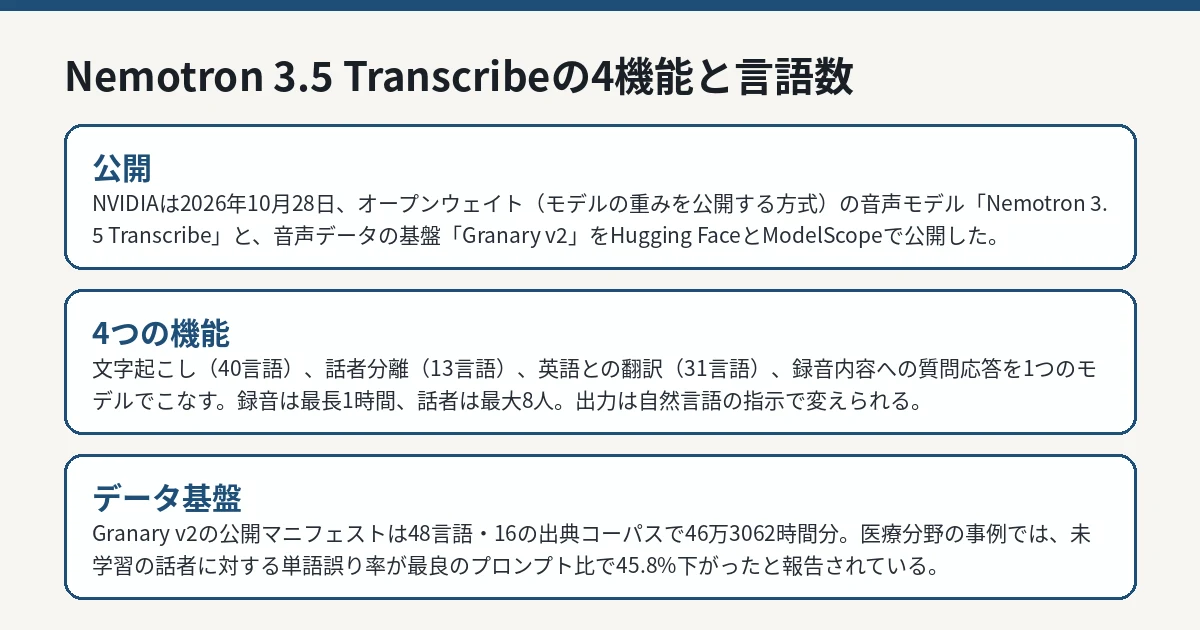
NVIDIAの公表では、Hugging FaceのOpen ASR Leaderboardの英語部門で、オープンウェイトモデルの中で首位(平均単語誤り率5.33%)とされています。多言語部門では7言語平均で4.62%の単語誤り率を記録したとされます。話者分離では、David AIの21言語のベンチマークで最も低いエラー率、VoiceArenaの14システム比較で首位をうたいます。
A. AIモデルの学習済みパラメータ(重み)が公開され、自分の環境にダウンロードして動かしたり、追加学習したりできる公開方式です。サービスとして使うだけのモデルと違い、手元の機械で処理できるため、音声データを外部に送らずに済む構成も選べます。
Q. 話者分離とは何ですか。
A. 録音の中で「誰が、どの区間を話したか」を区別する処理です。会議の議事録で発言者名が付くかどうかは、この処理の精度で決まります。本モデルでは最大8人まで、13言語で対応するとされています。
Q. 日本語の会議でも使えますか。
A. 文字起こしは40言語対応とされていますが、タスクごとの対応言語は異なり、質問応答は英語学習です。日本語でどのタスクまで使えるかは、モデルカードの対応表で確認し、実データで試してから判断するのが確実です。
IT Postの見方——売り物はモデル単体ではなく「データの作り方」まで含めた一式
IT Postでは、今回の公開で実務的に効くのは、モデルそのものよりGranary v2と追加学習の手順まで含めた「一式」を出した点だと考えます。音声認識の現場の困りごとは、汎用性能の数%ではなく、専門用語と自社の表記ルールに合わないことだ。その調整の材料と手順を先回りして配るのは、モデルを「試せる」から「業務に組み込める」に変える動きである。