30秒で分かる結論
- Blandが、音声を聞いて音声で返す「音声対音声」モデル「Tofu-1」を発表しました。文字への変換を挟まず、通話の音そのものを扱う設計が特徴です。
- 聞くことと話すことを同時にこなす全二重の設計で、話しながら調べ物を進めることもできると同社は説明しています。現在は研究プレビューの申し込み受付中で、対象は限られた企業です。
- パラメータ数や料金、一般提供の時期は公表されていません。目玉の事例も、同社自身が「録音されたモデルの出力ではなく概念例」と明記しています。
音声AIのBlandが2026年11月13日、全二重の音声対音声モデル「Tofu-1」を正式に命名し、製品ページを公開。聞くと話すを同時にこなし、通話の音そのものを理解するという設計で、研究プレビューの申し込み受付を開始した。パラメータ数や料金、一般提供の時期は公表されておらず、目玉のTV Testも同社自身が「実演ではなく概念例」と明記している点まで含めて整理した
電話の自動応答が一番やらかすのは、聞き間違いではない。部屋のテレビが「はい」と言ったのを、客の了承だと思い込むような、「誰の声か」を取り違える失敗だ。人間なら一瞬で聞き分けるこの区別が、文字に起こしてから考える機械には一番難しい。Tofu-1という、ずいぶん柔らかい名前のモデルが殴り込んできたのは、まさにその急所である。名前は豆腐でも、狙っている仕事は解約手続きや保険請求みたいな、間違えると高くつく通話ばかりだ。 ※個人の感想です
Blandは2026年11月13日(協定世界時)、公式アカウントで「Tofu-1」を正式に命名し、製品ページを公開しました。同社によれば、Tofu-1は同社の音声対音声モデルの系列の最初のリリースであり、全二重、つまり聞くことと話すことを同時にこなすモデルです。
従来の多くの音声システムは、音声を文字に変換し、その文字を言語モデルに渡し、返答を再び音声に戻すという段階を踏みます。Blandは、この方式では「誰が話しているか」「誰に向けた言葉か」「言いよどんだかどうか」といった、音に含まれている情報が段階ごとに失われると指摘しています。Tofu-1は音そのものを聞くことで、そうした情報を保ったまま扱う設計だと同社は説明しています。
製品ページでBlandが説明する能力は、大きく3つです。
第一に、場面全体を聞き取ることです。話し手同士の区別、言葉が誰に向けられたかの判断、子どもの泣き声やテレビ、車の騒音、病院の放送といった音と発話の分離、そして言いよどみや焦りといった言い方の情報まで扱うとしています。
第二に、話しながら聞くことです。通話では、相づちや、番号の訂正のような割り込みが常時発生します。同社は、短い相づちでは話を続け、訂正では即座に止まるという判断を、話している最中に行う必要があると説明しています。
第三に、話しながら考えることです。身元の確認や請求状況の照会といった実務を、会話と並行して進め、終わっていないことを終わったとは言わない、という設計を掲げています。
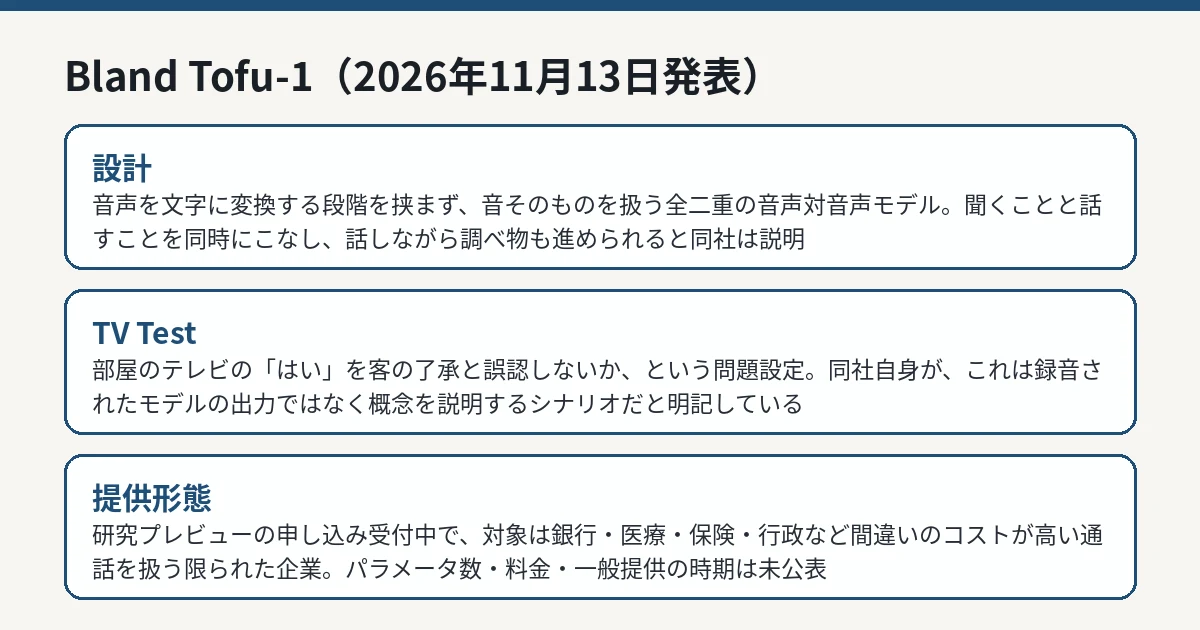
同社が象徴的な例として挙げるのが「TV Test」です。エージェントが「解約でよろしいですか」と確認し、客が政策番号を探して無言でいる間に、部屋のテレビが「Yes!」と音声を流す。このとき文字起こし型のエージェントは、その「はい」を客の返事として解約を進めてしまう可能性がある、という筋書きです。
重要な留保として、Bland自身がこの例について「録音されたモデルの出力ではなく、概念を説明するためのシナリオ」だと明記しています。つまり、これは実測の実演ではなく、同社が解きたい問題の定義です。テレビの音声は雑音ではなく「別の場面の発話」であり、音量では判断できない、という問題設定そのものは鋭いものですが、Tofu-1が実際にどれだけこの試験を通るのかは、現時点では同社の主張の段階にとどまります。
| 項目 | 段階を踏む従来方式(同社の説明) | Tofu-1(同社の説明) |
|---|---|---|
| 入力の扱い | 音声を文字に変換してから言語モデルへ渡す | 音そのものを聞き、話し手の区別や言い方も扱う |
| 発話のタイミング | 応答ができてから音声に戻す | 聞くことと話すことを同時に行う全二重 |
| 実務の処理 | 会話と照会が直列になりやすい | 会話と並行して照会などの作業を進める |
| 周囲の音 | 雑音として除去する対象 | 場面の一部として生成もできる |
製品ページでは、音の生成側についても説明があります。モデルは通話の音自体を扱うため、2人目の話し手や周囲の環境音、回線の音まで含めた音を作り出せるとしており、車内での通話を再現した10秒の生成サンプルが掲載されています。これは、応答音声の合成というより「通話の場面そのものの生成」に近い売り方です。検証用の通話シミュレーションに使うような用途も、同社は視野に入れていると読めます。
研究プレビューに参加する側が確かめるべき点は、同社の問題設定から逆算できます。第一に、背景でテレビや同席者の声が流れる条件で、客でない声を客の返事として処理しないか。第二に、番号や日付の訂正が話の途中で入ったとき、訂正前の内容で実務を進めてしまわないか。第三に、聞き取れない状況で推測に走らず、聞き返しに倒れるか。同社のページ自身が「背景音で客の声が理解できない場合は、その旨を伝えて繰り返しを求めるべきだ」という基準を書いているため、この基準どおりに振る舞うかは格好の採点項目になります。逆に、静かな環境での聞き取り精度だけを測っても、このモデルの主張は1つも検証できません。
Tofu-1は研究プレビューとして、申し込みの受付が開始されています。対象として同社が探しているのは、銀行、医療、保険、行政といった、間違いのコストが高い通話を扱うチームであり、一般の利用者や全顧客向けの提供ではありません。
現時点で公表されていないのは、パラメータ数、学習データの規模、独立したモデルカード、正式なAPIドキュメント、そして一般提供の時期です。製品ページには音声サンプルが掲載されていますが、性能を裏付ける第三者の評価は示されていません。導入を検討する場合は、同社の実演ではなく、自社の通話条件で検証することが前提になります。
IT Postでは、今回の発表の面白さは性能の数字ではなく、問題の切り取り方にあると考えます。「聞き取り精度」ではなく「誰の、誰に向けた発話か」という帰属の問題として音声AIを定義し直した点は、電話という古いインターフェースの実情に合っています。もっとも、主張と実力の間にはまだ距離があります。概念例を実演と誤読させない留保を同社自身が書いているのは誠実ですが、裏を返せば、示せる証拠がまだ概念の段階だということです。研究プレビューで実際の高負荷な通話に耐えたという報告が出てくるかどうかが、このモデルの評価を決めると考えます。
研究プレビューの参加企業での検証が進めば、対応範囲や失敗の傾向が見えてくるはずです。一般提供の時期や料金は未公表のため、現時点では「電話応答の自動化を検討している企業が、検証候補として名前を覚えておく」段階の発表です。本誌では、一般提供や具体的な性能公表が出た時点で続報として扱います。
「一次情報」は資料の出所を示す区分で、編集部による独立した実測や、すべての主張の実証を示すものではありません。確認の範囲や未確認の点は、本文の説明と併せてご覧ください。
価格は6万2800円から、発売は8月20日。血圧や代謝の"傾向"まで追いかける新機能は、今秋の日本投入か
Salesforceは2026年11月12日、音声認識モデル「SOV-Transcribe-1」を公開した。重みはHugging FaceでApache 2.0により配布される。総パラメータ26.6B(アクティブ4.6B)で、音響側にWhisper large-v3のエンコーダ、言語側にGemma 4 26B A4Bを組み合わせる。モデルカードによるとArtificial Analysisの評価でオープンウェイトの非ストリーミング音声認識1位、全体7位で、WERは2.3%。対応言語は英語など7言語で日本語は含まれない
Amazonは2026年10月29日、生成AI搭載のAlexa+のために設計されたスマートクロック「Echo Time」とスマートスピーカー「Echo Dot(第6世代)」を日本で発表した。Echo Timeは35,980円、Echo Dotは17,980円で同日販売開始。Alexa+の早期アクセスプログラムも始まり、終了後もプライム会員は追加料金なく使えるという
NVIDIAは2026年10月28日、オープンウェイトの音声モデル「Nemotron 3.5 Transcribe」とデータ基盤「Granary v2」をHugging Faceで公開した。40言語の文字起こし、31言語と英語の翻訳、13言語の話者分離を1つのモデルでこなし、自然言語の指示で出力形式を変えられる。公開マニフェストは48言語・46万3062時間分に及ぶ
Appleが2026年10月26日、27.2ソフトウェアアップデートの配信を開始し、新しいSiri AIがフランス語・日本語・韓国語・ポルトガル語・スペイン語に対応したと発表した。日本語は英語に次ぐ第1弾の追加言語に含まれ、年末までにさらに4言語が加わる。対象機種やベータ扱い、EUでは使えないなどの条件も含めて整理する
最終・暫定WERはArtificial Analysisの評価でともに2.5%。入力からの表示と発話終了後の遅延、音声2モデルのOpenRouter提供、公開プレビューのSLAなし・本番非推奨を分けて確認する
Bing検索からのクリック数にもとづく(集計期間: 2026年9月26日〜2026年10月23日)