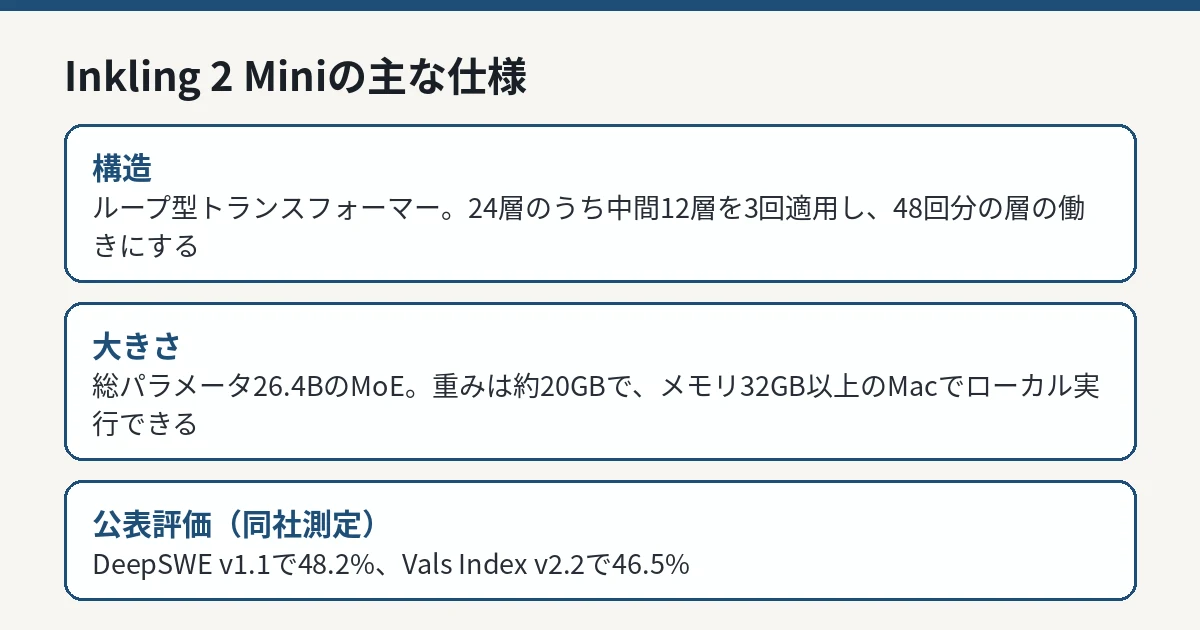
AI・生成AI Thinking Machines、ノートPCで動くオープンな新モデル「Inkling 2 Mini」を公開。中間層を3回繰り返す「ループ」構造で、小さいまま推論を深くした Thinking Machines Labは2026年11月20日、オープンウェイトの新モデル「Inkling 2 Mini」を公開した。総パラメータ26.4BのMoEモデルで、中間層を1トークンあたり3回繰り返し適用する「ループ型トランスフォーマー」を採用する。重みの大半をNVFP4、最後の4層をMXFP8で保持し、メモリ使用量は約20GB。Mac(メモリ32GB以上)ではOllama経由でローカル実行でき、重みはHugging Faceで公開された。同社公表の評価では、DeepSWE v1.1で48.2%、Vals Index v2.2で46.5%を記録し、総パラメータ100B未満のオープンウェイトモデルの中で首位だとしている。評価値はいずれも同社公表のものである。
まず初めに
モデルを賢くする方法は、長らく「大きくする」の一択に近かった。今回の答えは逆である。層を増やすのではなく、同じ層を3回通す。24層しかないのに、仕事ぶりは48層分。同じ社員に3周働いてもらうようなもので、給料明細(パラメータ数)は増えていないのに残業時間(計算量)だけが増えている。しかも重みは約20GBで、飛行機の中のMacBook Proでオフラインで動き、フライトシミュレータまで作ってみせた。派手な旗艦モデルがデータセンターで唸っている時代に、膝の上で回る側が「推論の深さ」で勝負を仕掛けてきた構図が、実に小気味いい。
※個人の感想です
どんなモデルか――26.4Bパラメータ、約20GB、画像も読める
Inkling 2 Miniは、テキストと画像を入力し、テキストを出力する汎用のマルチモーダルモデルです。構造はMoE (Mixture-of-Experts)で、総パラメータは26.4B、1トークンあたり有効化されるパラメータは3.4Bです。ループによる重みの適用を数えると、1トークンあたり5.4B分の重みが使われる計算になる、と同社は説明しています。
重みの精度は、大半がNVFP4で、最後の4層がMXFP8です。学習時と同じ精度のまま配布されるため、変換による精度の劣化がない、としています。チェックポイント全体のメモリ使用量は約20GBで、一般向けノートPCやデスクトップ級のAIコンピュータで動かせる大きさです。
同社の研究者は、飛行中の機内でMacBook Pro(M5 Pro、メモリ48GB)上でオフライン実行し、数分で遊べるフライトシミュレータを生成した事例を紹介しています。また、20人の住民全員を1台のオフラインのMacBook上のInkling 2 Miniで動かす小さな町「Thinkyville」の事例も公開されています。
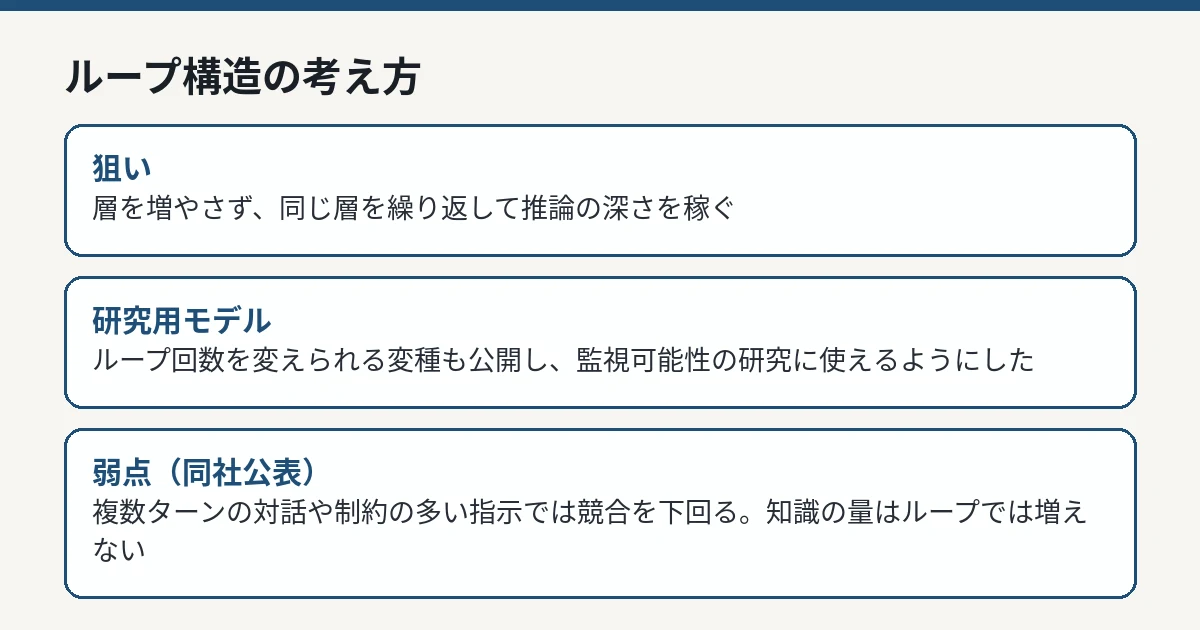
ループ構造の考え方を示す図解 編集部作成 ループ構造の中身――24層を48回分働かせる
Inkling 2 Miniは24層のモデルで、層は6層ずつ4つのブロックに分かれています。このうち中間の2ブロック(12層)を3回繰り返し、最初と最後のブロックは1回だけ通します。これにより、保存されている層は24層のまま、1トークンあたり48回分の層の適用が行われます。
同社は、中間層を繰り返すほうが、最後の層を繰り返すより効果が大きかったとしています。学習途中の比較では、中間層のループは計算量換算で1.51〜1.91倍の利得があり、最後の層のループの1.24〜1.36倍を上回りました。ループなしのモデルと比べると、学習計算は7.5%少なく済んだ一方で、同じ損失に到達するために必要な推論計算は、ループなし側が140%多く必要だった、としています。
設計の狙いは、思考過程(chain-of-thought)を文章として書き出さなくても、モデルの内部でより長く推論できるようにすることです。あわせて同社は、ループ回数を1〜5回に変えられる研究用モデル「TML-d24-varloop-research」もHugging Faceで公開し、ループが推論の監視可能性に与える影響を調べられるようにしました。実験では、文章なしで答えられる課題の長さの目安は1回で16秒、3回で37秒に伸び、思考過程の文章は短くなったものの読みやすさは保たれ、エージェントの妨害行為のテストで悪化の傾向は見られなかった、としています。
公表された評価結果
同社が公表した主な評価結果は次のとおりです。いずれも同社の測定によるもので、評価の設定はモデルごとに異なります。
評価
Inkling 2 Mini
比較(Qwen3.8-27B)
DeepSWE v1.1
48.2%
42.2%
SWE-bench Pro v2 Hard(51課題)
77.9%
73.8%
Vals Index v2.2
46.5%
(比較表に値なし)
Artificial Analysis Index(v5.0)
20.1
20.1
同社は、DeepSWE v1.1とVals Index v2.2では、総パラメータ100B未満の全てのオープンウェイトモデルを上回ったとしています。一方で、弱点も公表しています。複数ターンの対話(MultiChallenge 50.0%)や、制約の多い指示への追従(ComplexConstraints v1.1で33.4%)ではQwen3.8-27Bを下回り、知識の量そのものはループでは増えないため、知識集約型の評価は同規模のモデルと同程度にとどまる、としています。その不足は、検索やツールの利用で補う設計で、BrowseComp(79.0%)やDeepSearchQA(85.3%)、MCP Atlas(82.7%)では同規模のオープンウェイトモデルを上回った、と公表しています。
先行する大型版「Inkling 2 Small」の重み公開については、既存記事(https://itpostjp.com/ai/inkling-2-small-open-weights-hugging-face-apache-2/)で整理しています。Miniは、その系統をローカル実行できる大きさまで絞ったモデルという位置づけです。
どうやって小さくしたか――専門家の3分の2を間引く
Inkling 2 Miniは、学習の途中で専門家の数を間引く手法で小型化されました。当初は384の専門家から8つを選ぶ構成で学習し、中間の時点で使用頻度の高い128の専門家を残して3分の2を削除しました。その後、より大きな内部モデルから蒸留した1Tトークンで学習し、削除前の性能を回復させた、としています。さらに、Inkling 2 Smallと似たデータ構成での教師あり学習と、2,000ステップ・合計2.2Tトークンの強化学習が行われました。
重みの学習自体も4ビット精度(NVFP4)で進められています。学習と配布で精度を揃えることで、後から量子化する際に起きる劣化を避ける狙いです。
提供形態――Tinker、Ollama、vLLMなど
提供形態は次のとおりです。
重み:Hugging FaceでInkling 2 Miniと研究用変種の両方を公開
ローカル実行:Mac(メモリ32GB以上)ではOllama経由で対応。Unslothとllama.cpp経由の量子化GGUF版も利用できる
推論基盤:SGLang、vLLM 、Ollama、Unsloth、NVIDIA Dynamo、TokenSpeed、Llama Appなどに対応
托管サービス:同社のTinkerで推論とファインチューニングが可能で、Tinker Playgroundでのチャットも提供
IT Postの見方
IT Postでは、今回の公開で見るべきは、ベンチマークの順位よりも「深さの作り方」を変えた点だと考えます。層を積み増すのではなく、同じ層を繰り返すことで、保存する重みの量と1トークンあたりの計算を切り離した。約20GBという大きさは、メモリ32GB級のMacにそのまま載る水準であり、ローカルでエージェントを常駐させる使い方と相性がいい設計です。
もう一つは、弱点の公表の仕方です。対話と制約追従では競合に負けること、知識はループでは増えないことを、発売側が自分で表にして出しています。勝った表だけを出すのがこの業界の作法になりつつある中で、負けた表を同じページに置くのは、実に珍しく、実に健全です。もっとも、勝った表も負けた表も出所は同社の測定です。第三者の再測定が出てくるまでは、順位は「同社調べ」として読むのが妥当だと考えます。
今後どうなりそうか
焦点は、第三者による再測定で公表値がどこまで再現されるかと、ループ構造が他の小型モデルにも広がるかどうかです。研究用の可変ループ版まで同時に公開されたため、ループ回数と性能・監視可能性の関係は、外部の研究者によっても検証が進む見込みです。
実務面では、メモリ32GB以上のMacやDGX Spark級のデスクトップで、オフラインのままエージェント型のコーディング作業を回せるかどうかが試しどころになります。クラウドの利用料金を気にせず常時稼働させられる小型モデルは、個人開発者や小規模なチームにとって選択肢が増える話です。まずは手元の環境で動かし、自分の作業で公表値に近い挙動になるかを確認するのが確実です。