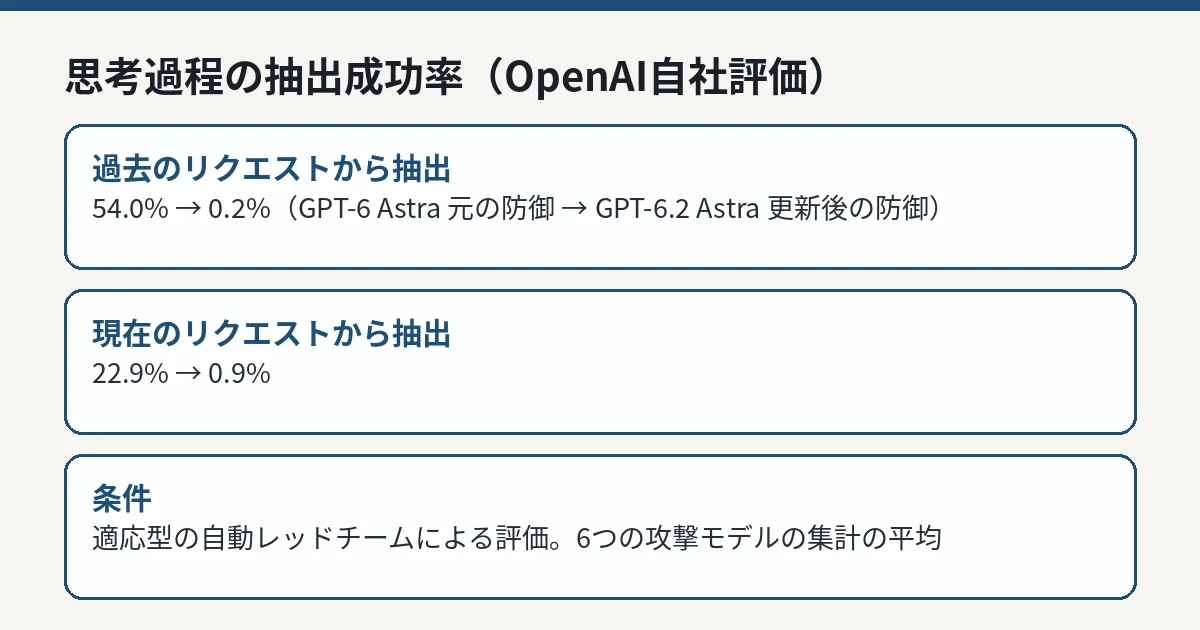
AI・生成AI OpenAI、モデルの思考過程を盗む「敵対的蒸留」への多層防御を公開。抽出の成功率は54%から0.2%へ下がった OpenAIは2026年11月20日、フロンティアモデルの出力や思考過程を無断で集めて別のモデルを訓練する「敵対的蒸留」への防御策を公開した。中心は、モデルが答えに至る途中の思考過程(chain-of-thought)の保護で、GPT-6.2 AstraとGPT-6.2 Solで防御を強化。内部の適応型評価では、過去のリクエストで生成された思考過程を取り出す攻撃の平均成功率が、GPT-6 Astra(元の防御)54.0%からGPT-6.2 Astra(更新後の防御)0.2%へ下がった。防御はモデル訓練、分類器、API制御と、キャンペーン単位の調査・執行を組み合わせる。
まず初めに
今どきのカンニングは、答案を写すところでは終わらない。解いている途中の下書きまで欲しがる。OpenAIの発表は、その下書き――モデルの思考過程――を門外不出にするための工事報告である。率直に言って、54.0%という元の成功率のほうがニュースである。半分以上の確率で抜けた仕組みを、0.2%まで締め直した。順序としては「まず半分抜けていました」と白状してから直したわけで、この手の発表にしては、実に正直な書き出しである。格好つけずに弱点の数字から出すあたり、嫌いではない。
※個人の感想です
蒸留とは何か、なぜ「敵対的」なのか
蒸留は、あるモデルが作ったデータから別のモデルが学ぶ、一般的な機械学習の手法です。データを出す側は「教師」、学ぶ側は「生徒」と呼ばれます。手法そのものは正当な技術ですが、OpenAIは、フロンティアモデルの出力を無断で使って同等の能力を持つモデルを作り、元のモデルのような安全対策なしに運用する使い方を「敵対的蒸留」と呼んで問題にしています。
同社によると、特に問題になるのが、モデルが答えに至るまでの内部の思考過程(chain-of-thought)です。思考過程には、最終的な答えには残らない情報が含まれているため、別のモデルにとって特に価値の高い訓練データになる、としています。
リスクが分かりやすいのは、サイバーセキュリティや生物学のような、使い方次第で攻守が入れ替わる領域です。防御側の作業を助ける能力が、安全対策の弱いモデルへ移れば、元のモデルなら断ったはずの手伝いをしてしまう可能性がある、というのが同社の説明です。
なぜ思考過程が狙われるのか――サイバー能力の移転実験
同社は、思考過程の保護がなぜ重要かを確かめるため、サイバー能力が蒸留でどう移るかを内部で実験しています。同じ事前学習済みの生徒モデルから訓練を始め、利用者に見える内容(最終回答、思考の要約、ツールのやり取り)を基準として、教師の正確な思考過程に触れた場合に、どれだけ追加の能力が移るかを比べました。
教師のデータは、コーディングと防御的なサイバーセキュリティの作業に取り組むAstra級モデルの軌跡で、各手順、ツールのやり取り、最終回答を含みます。教師あり微調整の後では、正確な思考過程で訓練した生徒が、要約で訓練した生徒を概ね上回りました。強化学習の後でも、評価時の推論予算が最大の条件では、正確な思考過程で訓練した生徒のほうが両方のベンチマークで高いスコアだった、としています。
同社はこの結果から、思考過程を守ることで、元の作業自体が利用規約上許される内容であっても、サイバー能力の移転を抑えられる可能性がある、と結論づけています。GPT-6.2の提供形態や価格は、GPT-6.2 AstraとSolの発表記事(https://itpostjp.com/ai/openai-gpt-6-2-astra-sol-work-codex-api/)で整理しています。
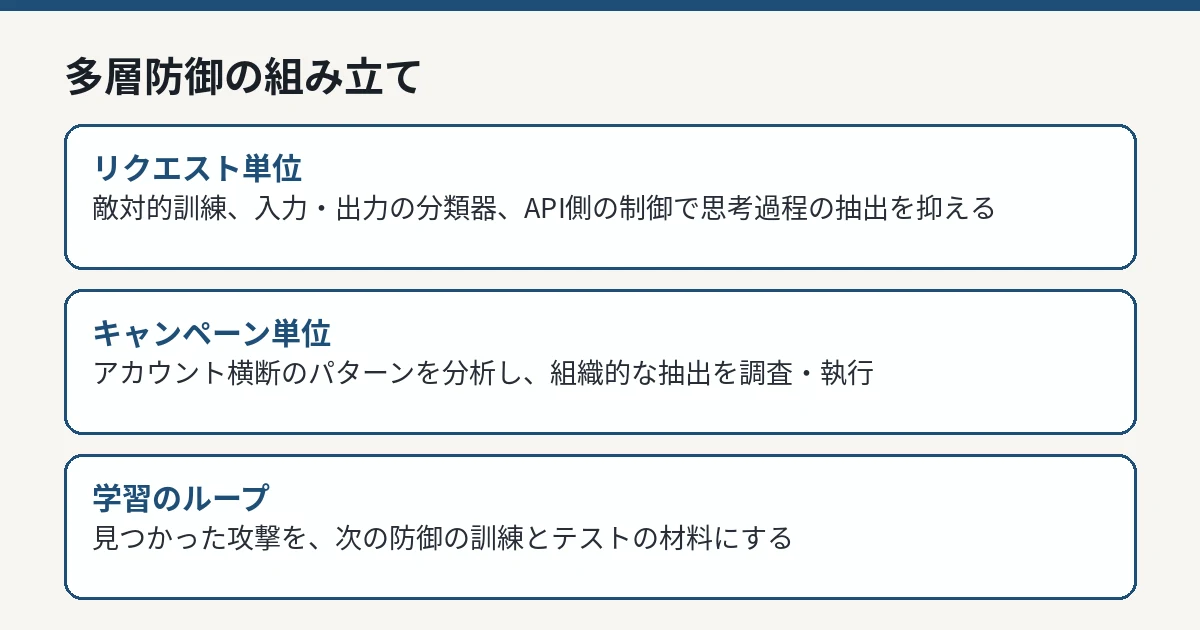
OpenAIが公表した多層防御の組み立てを整理した図解 編集部作成 防御の仕組み――リクエスト単位とキャンペーン単位
防御は、個々のリクエストへの対策と、組織的な抽出キャンペーンへの対策の2層で組み立てられています。
リクエスト単位では、まず敵対的訓練により、モデルが思考過程の抽出の試みを見分けて開示を断るよう教えつつ、正当な説明や手伝いの求めには答えられるようにしています。訓練例には、内部の自動レッドチーム、調査、外部の研究者や業界パートナーからの責任ある開示で見つかった、成功した攻撃が使われます。
次に分類器です。入力側の分類器が抽出の試みを検出し、出力側の分類器が、助手のメッセージとツール呼び出しの引数の中に思考過程の漏えいがないかを調べます。ストリーミングと非ストリーミングの両方の応答が対象です。同社は、最終回答に含まれなくても、ツールの引数の中で思考過程が露出することがあるため、この範囲が重要だ、としています。
さらにAPI側の制御があります。GPT-6.2 AstraとGPT-6.2 Solでは、思考過程を、それを生んだ会話の履歴に結びつけています。途中のメッセージが書き換えられると、それ以降の思考過程はAPIが破棄します。また、防御の弱い旧モデル系列からは、新しいモデルの思考過程を読めないようにしています。9月に公表された、暗号化された思考過程を別の会話へ移して読ませる手口への対策も、この層に含まれます。
キャンペーン単位では、リクエストとアカウントの信号から組織的な抽出のパターンを探し、規約違反が確認されれば、アカウントのネットワークに対して執行します。調査で見つかった攻撃は、次の防御の訓練とテストの材料にもなります。同社は、侵害の指標を他のモデル提供者とも共有している、としています。
実測値と、その読み方
同社の適応型評価は、自動化されたAIのレッドチームが、システムの応答を見ながら手口を変えていく方式です。テストする側が見られるのは、外部の利用者と同じ範囲に限るブラックボックス条件で行われました。結果は、6つの攻撃モデルにわたる集計の平均です。
過去のリクエストで生成された思考過程を取り出す攻撃では、平均成功率はGPT-6 Astra(元の防御)の54.0%から、GPT-6.2 Astra(更新後の防御)の0.2%へ下がりました。現在のリクエストの思考過程を取り出す攻撃では、22.9%から0.9%へ下がっています。同社は、選んだ改善策をGPT-6 Astraにも適用し始めている、としています。
キャンペーンへの執行については、今年の週ごとの執行規模が数千件から数万件のアカウントの範囲で推移し、この夏に大幅に増えた、としています。
読み方には注意が要ります。これらは同社自身の評価で、独立した第三者が同じ条件で確かめた数字ではありません。攻撃に使ったプロンプトの数や多様性、正当なリクエストを誤って止める割合などは、今回の公表では示されていません。成功率の低下は「抽出のしにくさ」の測定であり、抽出されたデータで訓練した生徒モデルの能力そのものを測ったものではない点も、同社の公表範囲を読み解くうえで押さえておく必要があります。
IT Postの見方
IT Postでは、この発表の実務的な価値は、派手な成功率の数字よりも、防御の置き場所の示し方だと考えます。思考過程は、最終回答だけでなくツール呼び出しの引数からも漏れ得る。会話を書き換えたら後続の思考過程を捨てる。旧モデルには新モデルの思考過程を読ませない。どれも、APIを提供する側が今日から点検できる形の話です。自社のモデルを外部に出している開発者にとっては、そのまま点検表になります。
一方で、54.0%という出発点は重く受け止めるべきです。思考過程の保護は、フロンティアモデル各社が競う新しい守りの領域であり、今回の数字は1社の自社評価にすぎません。各社が同じ物差しで測って比べられるようになるまでは、「0.2%」を業界全体の安全の証明として読むのは早いと考えます。
今後どうなりそうか
同社は、最近妨害したキャンペーンについて、近くさらに共有する予定だ、としています。9月には、協調した蒸留キャンペーンを妨害した経緯を公表しており、今回の発表はその防御側の続編にあたります。
開発者側の関心は、防御の強化が正当な利用にどこまで影響するかです。説明を求める正当なリクエストと、抽出の試みの線引きは分類器とモデルの判断に委ねられており、誤判定の割合が示されていない以上、提供形態の変更やAPIの挙動の変化として表れたときに、各社の公表を比べることが重要になります。思考過程を「見せないこと」自体が競争力になる時代に入ったのは確かです。