AI・生成AI Google、TPUを1年で4システムに増やす。新しいチップではなく「組み方」で勝負する時代の話 Googleは2026年11月9日、第8世代TPUの新システム「TPU 8tx」と「TPU 8i Max」を発表。機密推論向けと大規模コンテキスト向けの2構成で、1年に4システムは初。公式発表の内容と、価格・提供時期が未公表である点を整理する
まず初めに
AIチップの発表というと、毎回「何ナノメートルで、何倍速くなったか」の殴り合いだった。それが今回は「チップは同じです。組み方を変えました」が堂々と看板に載る。料理で言えば、新しい食材ではなく新しいコース構成の発表である。地味に聞こえるが、客が本当に困っているのは食材の産地ではなく、機密データを外に出せないことと、長い文脈を入れると詰まることだ。その2つに絞ってきたあたり、売り場の空気は確実に変わっている。
※個人の感想です
何が発表されたのか
Googleは2026年11月9日、公式ブログで第8世代TPUのラインアップ拡張を発表しました。
第8世代は、2026年4月のGoogle Cloud Nextで発表された2システムから始まっています。大規模な学習向けの「TPU 8t」(前世代比で最大2.7倍の学習性能)と、リアルタイム推論向けの「TPU 8i」(前世代比で推論の価格性能が80%向上、チップ間の通信遅延を最大で半減)です。
今回追加されたのは、次の2システムです。
システム
位置づけ
構成
TPU 8tx
安全で機密性の高い推論、小規模な学習にも対応
8tと同じシリコン+第5世代AMD EPYCホスト
TPU 8i Max
大規模コンテキスト、ラックあたり最高の計算密度
8iチップを2個、1パッケージに統合
Googleは「新しいチップと新しいシステムは違う」と明言しています。チップの設計は数年単位の工程ですが、システムはチップの周りの計算・ネットワーク・ストレージの組み合わせであり、顧客の要請に合わせて数か月単位で新しい構成を出せる、というのが同社の説明です。TPUの顧客は現在ほぼ100社で、フロンティアモデル開発企業、金融取引会社、小売、大学などが含まれ、顧客の自社データセンターへTPUを設置する提供形態も始まっている、としています。
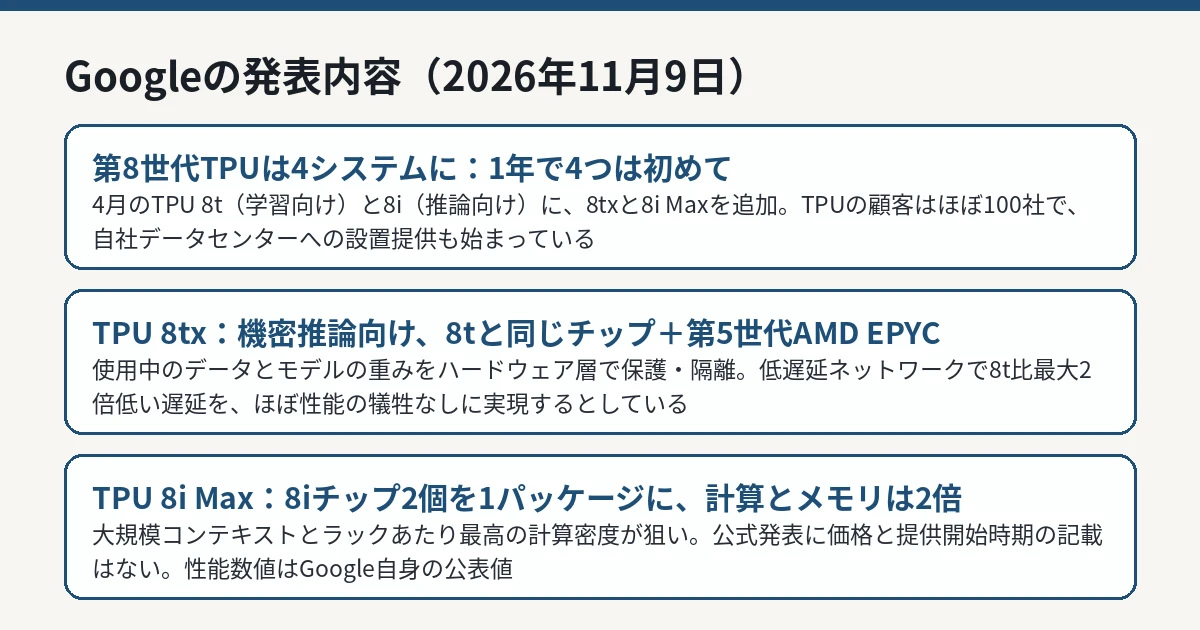
第8世代TPUの4システム構成を整理した図解 IT Post編集部 TPU 8tx——使用中のデータを守る機密推論
TPU 8txは、規制の厳しい企業や政府機関が、 最先端モデルや自社モデルと、最も機密性の高いデータを一緒に扱う用途を想定しています。
データは通常、保存時と転送時は暗号化されますが、計算のためにメモリ上では解かれます。8txは、8tと同じシリコンに第5世代AMD EPYCのホストを組み合わせ、セキュリティをハードウェア層に組み込むことで、使用中のデータとモデルの重み(学習済みパラメーター)を保護・隔離する、としています。推論ネットワークには8i向けに開発した低遅延のBoardflyネットワークを採用し、8tと比べて最大で2倍低い遅延を、ほぼ性能の犠牲なしに実現する、というのが同社の主張です。
あわせて、同じシステム上でモデルの実行とカスタマイズ(私用データでの追加学習、大規模モデルの蒸留、エージェントの強化学習)を完結でき、機密データを別のクラスターへ移す必要がない点も、売りとして挙げています。TorchTPUの文脈では、GoogleとMetaによるPyTorch対応の動き も報じられています。
TPU 8i Max——チップ2個を1つに束ねてメモリの壁を越える
TPU 8i Maxは、複数のエージェントがコードベース全体や長時間の動画を一度に扱う場面で、メモリ帯域が詰まる問題への回答です。
低遅延の8iチップを2個、1つのパッケージに統合することで、8iと比べて計算性能、オンチップメモリ(SRAM)、高帯域メモリ(HBM)の帯域をそれぞれ2倍にしました。既存のラックの設置面積のまま2倍のシリコンが入るため、面積あたり・電力あたりの計算量も増える、としています。
ソフトウェア側の発表も同時に行われた
今回の発表はハードウェアだけではありません。Googleは、TPUを汎用ハードウェア並みに使いやすくする取り組みとして、次の公開・提供開始も併せて示しました。
TorchTPU(オープンソース化済み)により、PyTorchのコードやHugging Faceのモデルが書き換えなしにTPU上で動き、vLLMやSGLangといった推論エンジン向けのバックエンドも用意される
TPUの導入診断や最適化を自動化する「TPU agent suite」(プレビュー)が、Claude CodeやCursor、Google Antigravityといったコーディングツールに接続できる
モデル状態を管理する層「TPU Sync」をオープンソース化し、KVキャッシュの退避や文脈の受け渡しで、遅延を90%超削減するとしている
Google Kubernetes Engine(GKE)上の「Cloud Pathways」と「GKE dynamic slicing」が正式提供になり、作業開始までの時間を最大5倍、障害復旧を最大4.5倍速くするとしている
性能に関する数値はいずれもGoogle自身の公表値で、第三者による検証結果ではありません。また、公式発表には8txと8i Maxの価格と提供開始時期は記載されていません。二次報道では、Bloombergが両システムの提供を2027年と伝えたとされていますが、Google自身の日付公表ではない点には注意が必要です。
IT Postの見方
IT Postでは、今回の発表の読みどころは性能表ではなく、「チップではなくシステムで出す」という宣言そのものだと考えます。AI計算の需要は、学習一色から、機密推論、長い文脈、エージェントの大量実行へと割れてきました。割れた需要に、数年かかる新チップでは間に合いません。既存チップの組み替えで数か月単位で答える。この速度の出し方は、NVIDIAのGPU 一強に対して「総力戦」ではなく「用途別の細かい当て方」で挑む構図です。
ただし、買い手の立場で冷静に見れば、価格も時期も出ていない発表は、まだ調達計画には入れられません。2027年という時期が二次報道経由でしか示されていない以上、今回の発表は「来年の選択肢が増えるかもしれない」という予約票の段階です。数字が出そろった時点で、改めてGPUとの価格性能を比べる。それまでは、ソフトウェア側の開放(PyTorch対応の進展)のほうが、今日の開発者にとっては実のある話だと考えます。
※個人の感想です
今後どうなりそうか
次の確認点は、両システムの提供開始時期と価格、対象リージョン、そして機密計算 の仕組みに対する第三者の評価です。Google Cloudの公式ドキュメントに具体的な仕様が載り始めた段階で、本記事を更新します。