AI・生成AI Meta、最小モデル「Muse Ember」を発表。単価は据え置き、トークンの使い方で「3分の1のコスト」を作る勝負だった Metaは2026年11月9日、最小・最高効率モデル「Muse Ember」を発表。入力100万トークン0.10ドル/出力0.50ドルで、Artificial Analysisの知能指数ではClaude Haiku 5.5の最高値と並び、タスクあたりコストは約3分の1と説明。1Mトークンの文脈と提供条件を整理する
まず初めに
「最小で、最も効率的」。派手な知能自慢ではなく、地味な経費の話が看板になった。それもそのはずで、エージェント時代の請求書を膨らませるのは、たまに来る難問ではなく、1日に何百回も走る小さな作業の積み重ねだからだ。主役の大型モデルが脚光を浴びる裏で、実際に現場を回すのは下働きの小型モデルである。今回Metaが売りに来たのは、その下働きの「単価」ではなく「仕事の速さと無駄のなさ」のほうだった。地味だが、財布には一番効く種類の話である。
※個人の感想です
何が発表されたのか
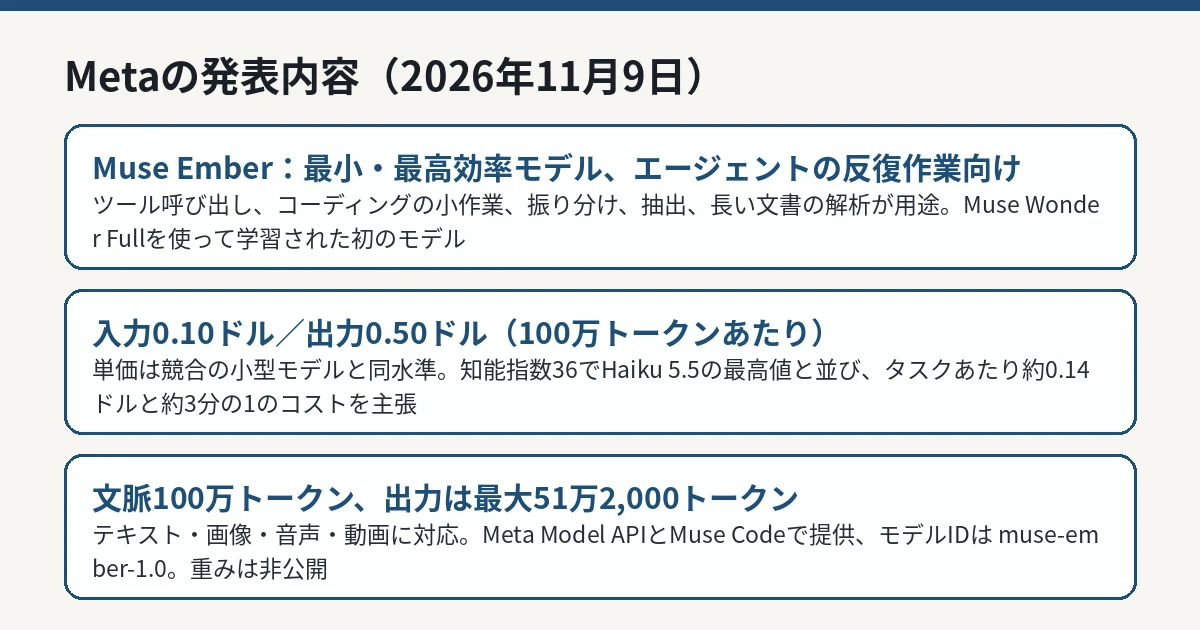
Metaは2026年11月9日、公式ブログで「Muse Ember」を発表しました。同社はEmberを「複雑な推論の実行と、エージェントが毎日繰り返す作業のために設計された、最小で最も効率的なモデル」と位置づけています。想定する作業は、ツール呼び出し、コーディングの細かな作業、リクエストの振り分け(ルーティング)、情報の抽出、長い文書の解析です。
仕様と提供条件は、次のとおりです。
項目
内容
料金
入力100万トークンあたり0.10ドル、キャッシュ済み入力0.004ドル、出力100万トークンあたり0.50ドル
文脈ウィンドウ
100万トークン
最大出力
51万2,000トークン
入力の種類
テキスト、画像、音声、動画
提供先
Meta Model API、Muse Code(モデルID: muse-ember-1.0)。Responses APIに対応
重みの公開
なし(API提供のみ)
Emberは、Metaの最大モデル「Muse Wonder Full」を使って学習された初のモデルだ、と同社は説明しています。モデル群の役割分担は、最も難しい問題を担うMuse Wonder、コーディングとエージェント作業を担うMuse Spark、そして反復作業を量でこなすMuse Emberという3層です。「Muse Wonderが計画し、Muse Emberが量をさばく」という組み合わせを、同社は前面に出しています。同日には、AnthropicのClaude Fable 5.2とMythos 5.2 も発表されており、大型モデルの更新と小型モデルの効率競争が同じ日に並ぶ形になりました。
Muse Emberの料金・仕様・位置づけを整理した図解 IT Post編集部 評価結果——指数では並び、勝敗は項目ごとに割れる
Metaが公表した評価(最大の推論設定、Artificial Analysisおよび同社内部評価)では、Emberは知能指数(Intelligence Index)で36を記録し、Claude Haiku 5.5の最高値36と並びました。1タスクあたりのコストはEmberが約0.14ドル、Haiku 5.5が約0.41ドルで、Metaは「約3分の1」と説明しています。GPT-6 Lunaの指数は28です。
項目別では勝敗が割れます。
評価
Muse Ember
Claude Haiku 5.5
GPT-6 Luna
AutomationBench-AA(業務ワークフロー)
37.8
13.9
20.2
Terminal-Bench 4.0(端末コーディング)
40.9
39.2
16.4
OSWorld 2.1(コンピューター操作、部分点)
69.5
68.9
50.5
FrontierCode 2.0-AA(実装可能性で判定する実務コーディング)
27.2
34.9
25.2
Artificial Analysis Index
36
36
28
業務ワークフローや端末コーディングではEmberが大きくリードする一方、実際の開発作業の「マージできるかどうか」で判定するFrontierCode 2.0-AAではHaiku 5.5に明確に負けています。「Haiku級」という看板は指数の平均値の話であって、全項目で互角という意味ではありません。なお、一部の指標(Personal Superintelligence Indexなど)はMetaの内部評価であり、第三者が検証した数値ではない点にも注意が必要です。
上位のMuse Spark 1.3との比較では、指数は37対36で1点差にとどまり、タスクあたりコストは2.39ドル対0.14ドルと大きく開きます。Meta自身の価格表の中で見ても、Emberの売りは知能の絶対値より「知能あたりの値段」です。
早期利用企業の声と、安全性の扱い
早期テストに参加した企業として、Box、Cline、Oracle、Cloudflare、You.comが挙げられています。Boxは契約書の審査のような企業コンテンツ作業での精度と速度を、Clineはコーディングや文書解析の「サブエージェント作業」に目的特化している点を、Cloudflareは処理速度を、それぞれ評価したと紹介されています。これらはMetaの発表に載った提携先のコメントであり、独立した検証ではありません。
安全性については、公開前に同社の枠組み(Meta Superintelligence Scaling Framework)で化学・生物、サイバーセキュリティ、制御喪失のリスクを評価し、評価した区分では高リスクの閾値を下回った、としています。小型モデルでも、大型モデルと同じ中核的な安全学習とテストを受けた、というのが同社の説明です。また、Muse Ember、Muse Spark、Muse WonderはGoogle CloudとOracle Cloudでも提供される、としています。
IT Postの見方
IT Postでは、今回の発表の勘所は「単価据え置き」という点にあると考えます。入力0.10ドル・出力0.50ドルは、Haiku 5.5やGPT-6 Lunaとほぼ同じ土俵です。値下げ合戦ではなく、「同じ単価で、終わるまでのトークンが少ないから請求が3分の1になる」という効率の売り方に寄せてきた。これは、エージェントの利用量が増えるほど効いてくる主張で、逆に言えば、単発の質問応答が中心の使い方では差は見えにくい。自分の使い方が「大量の小さな呼び出し」かどうかで、このモデルの価値は大きく変わります。
もう1つ、読み飛ばしてはいけないのはFrontierCodeでの敗北です。指数の平均で並んでも、「実際にマージできるコードを書く力」では既存の小型モデルに届いていない。サブエージェントとして「読む・調べる・整える」を任せる設計と、「書いて直す」まで任せる設計は、別物として考えるべきです。Meta自身がWonderとの分業を掲げる以上、Ember単体での万能選手扱いは、同社の意図ともずれます。
※個人の感想です
今後どうなりそうか
次の確認点は、Artificial Analysis以外の第三者評価での再現性、Muse Code経由での実作業の費用感、そして対象地域の広がりです。Metaは「さらに効率的なモデルを学習中」とも述べており、小型モデルの効率競争は続きそうです。
IT Postでは、独立した評価結果や提供条件の変更が公表された場合は本記事を更新します。