AI・生成AI Qwen4-Max Previewが登場、コンテキスト1Mトークンで最大出力は393,216。ただしToken Plan専用で、11月25日に消えるモデルだ AlibabaのQwenは2026年11月11日、Qwen4世代初のモデル「Qwen4-Max-Preview」をQwenCloudの公式ドキュメントで公開。テキスト・画像・動画入力に対応するマルチモーダルモデルで、コンテキストは1Mトークン、最大出力は393,216トークン。アクセスはToken Plan専用で従量課金はなく、プレビューは11月25日24時(UTC+8)までで期間中は凍結され、終了後に廃止される。ベンチマークやパラメータ数、重みは未公表であり、分かっていることと分からないことを分けて整理した
まず初めに
新世代の看板モデルが、派手な発表会ではなく開発者ドキュメントの更新でひっそり現れた。しかも寿命は2週間。11月25日が来れば消える。ベンチマークもパラメータ数も無し。数字の自慢で殴り合うのが常のこの業界で、「まず触ってみて、ただし期限付きで」という出し方は、なかなか潔い。潔すぎて、評価のしようがない部分まで潔いのが玉に瑕だが。
※個人の感想です
公開された内容
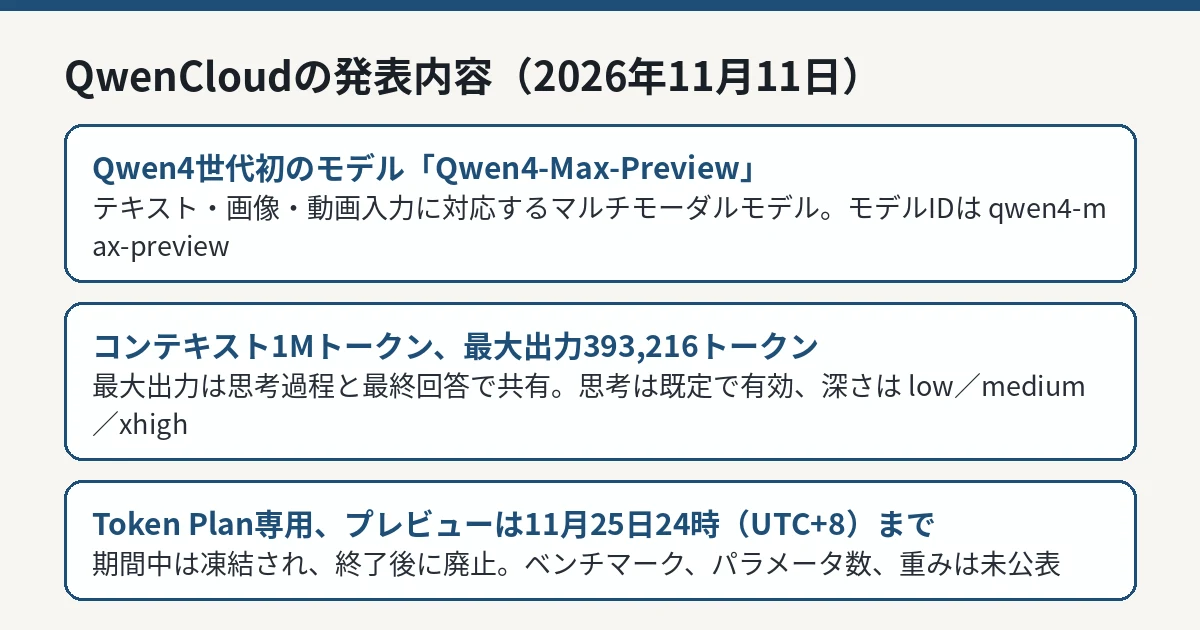
QwenCloudの公式ドキュメント「Latest model」ページによると、Qwen4-Max-Preview は「Qwenファミリーの次世代フラッグシップ・マルチモーダルモデル」と位置づけられています。主な仕様は次のとおりです。
項目
内容
モデルID
qwen4-max-preview
入力
テキスト、画像、動画
コンテキスト長
1Mトークン
最大出力
393,216トークン(思考過程と最終回答で共有)
思考モード
既定で有効。深さは low/medium/xhigh(既定)
提供形態
Token Plan専用(従量課金なし)
プレビュー期間
2026年11月11日10時〜11月25日24時(UTC+8)。期間中は凍結、終了後に廃止
接続には専用のBase URL(https://token-plan.maas.qwencloudapi.com)を使い、OpenAIのChat Completions/Responses形式と、AnthropicのMessages形式の両方に対応します。既存のアプリケーションからは、接続先とモデルIDの差し替えで試せる形です。
Qwen4-Max Previewの仕様と提供条件を整理した図解 IT Post編集部 Token Plan専用という提供形態
このモデルの変わっている点は、提供の形にもあります。通常、APIモデルは従量課金(使ったトークン数に応じた課金)で提供されますが、Qwen4-Max-Preview はToken Plan(定額のトークンプラン)専用で、従量課金での提供自体がありません。試すには、まずQwenCloudのToken Plan側の契約と、専用のBase URLへの接続が必要です。評価したい開発者にとっては、「少しだけ試して従量で払う」ができない分、2週間の間に集中的に触る設計に寄せる必要があります。プレビュー終了後はモデル自体が廃止されるため、検証結果は「正式版への期待値」として持ち越すしかありません。恒常的な組み込み先として設計しないことが、このモデルとの正しい付き合い方です。
分かっていないこと
一方で、モデルを評価するうえで肝心な情報は、現時点では出ていません。
ベンチマーク結果(性能の比較指標)は未公表
パラメータ数やモデル構成は未公表
オープンウェイトの公開やライセンスは未公表
Token Plan以外の料金(従量単価)は設定自体が無い
つまり現時点では、「Qwen4世代の最大級モデルが、2週間だけ、定額プラン経由で試せる」という事実までが確定情報です。性能については、利用者の実測が各所に出始めてから判断するのが安全です。文章を書かず判定だけを返すモデルを同日に出した例(GoogleのGemini Decision 1 )とは対照的に、こちらは通常の対話・生成を行う汎用モデルです。
2週間のプレビューで確認すべきポイント
期間が限られるため、試す側は「何を確かめるか」を先に決めておく必要があります。公式情報から読み取れる確認ポイントは、次のとおりです。
長文脈の実効性: 1Mトークンの入力枠を使い、長い資料を入れたときに、末尾まで踏まえた回答が返るか
出力の長さ: 最大出力393,216トークンは思考過程と共有のため、思考を深くする設定(xhigh)では、最終回答に残る枠がどれだけか
マルチモーダルの扱い: 画像と動画の入力が、既存の業務フロー(画面の読み取り、動画の要約等)にそのまま差し込めるか
API互換の実効性: OpenAI形式とAnthropic形式の両対応がうたわれているため、既存コードの接続先とモデルIDの差し替えだけで動くか
なお、Qwen4世代については、9月時点でプレビュー版アーキテクチャの話題が報じられており、今回のMax Previewはその流れの先行実装と位置づけられます。正式版でコンテキスト長や最大出力の仕様が維持されるかは、現時点では分かりません。
IT Postの見方——2週間の「味見」に込めた自信と、評価の置き場
IT Postでは、この出し方は「正式版の前の味見」として割り切った設計だと考えます。期間中はモデルを凍結する、と明言している点が重要で、試した人の評価が、後からこっそり別物にすり替わる心配がない。逆に言えば、11月25日を過ぎれば同じモデルには二度と触れない。本番の業務を載せる相手ではなく、「次のQwen4がどの方向を向いているか」を測る物差しとして使うのが正しい。1Mトークンのコンテキストと、約39万トークンという大きな最大出力は、長大な資料と長い出力を1回で扱う用途への意識の表れで、正式版でこの仕様が残るかどうかが、次の注目点になる。
今後どうなりそうか
確認点は、プレビュー期間中の利用者の実測評価、正式版(Qwen4-Max)の発表時期と仕様、そしてオープンウェイト版の有無です。Qwenはこれまで、APIモデルの後にオープンウェイト版を出す流れを作ってきました。新しい公式発表が確認できれば、本記事を更新します。試す場合は、11月25日の終了を前提に、評価用の検証だけに閉じて使うのが安全です。検証の記録は、モデルの応答例と設定(思考の深さ、入出力のトークン数)をセットで残しておくと、正式版が出たときの比較にそのまま使えます。