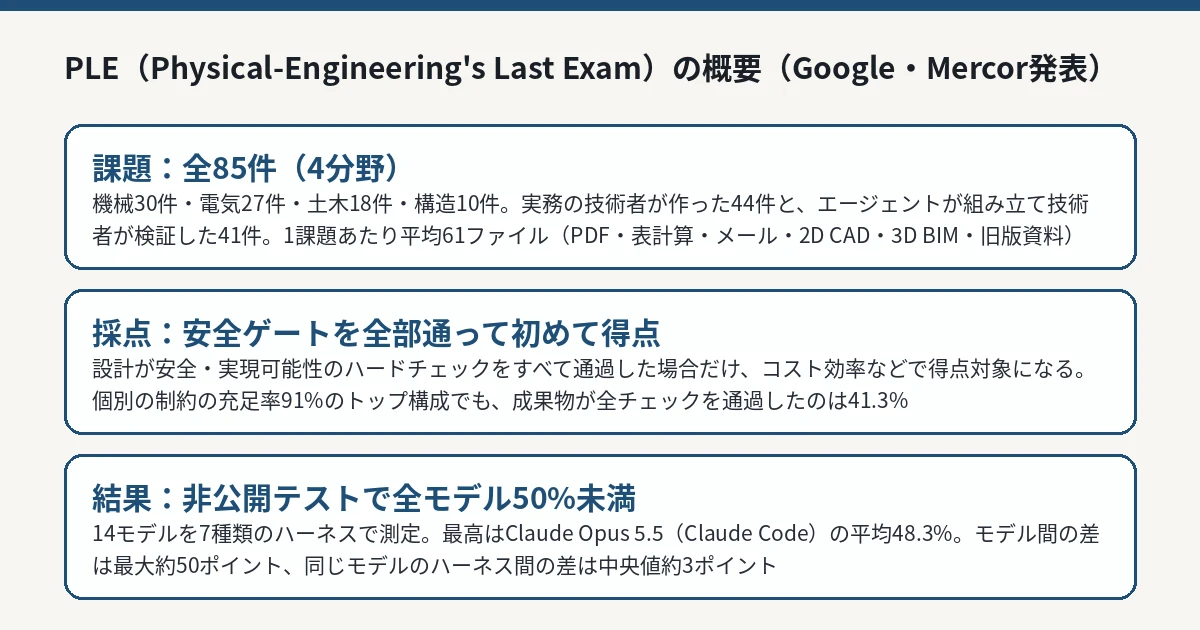
GoogleのAI・インフラチームとMercorは2026年11月3日、機械・電気・土木・構造の実務課題85件でAIエージェントを測るベンチマーク「Physical-Engineering’s Last Exam(PLE)」と公開コンペティションを発表した。非公開のテストセットでは14のフロンティアモデルすべてが50%未満にとどまり、最高でも平均48.3%だった。課題29件と採点ツールが公開されており、設計が安全チェックをすべて通過した場合だけ得点になる採点方式を、公式発表の範囲で整理した
GoogleのAI・インフラチームとMercorは2026年11月3日、機械・電気・土木・構造の4分野の実務課題85件でAIエージェントを測るベンチマーク「Physical-Engineering’s Last Exam(PLE)」を発表し、課題29件と採点ツール、公開コンペティションを公開しました。
14のフロンティアモデルを7種類のエージェント実行環境(ハーネス)で測ったところ、非公開のテストセットでは全モデルが50%未満にとどまり、最高でも平均48.3%でした。Mercorの発表によると、首位はClaude Codeで動くClaude Opus 5.5です。
モデルとハーネスの影響の違いも示されました。モデル間のスコア差は最大で約50ポイントに広がる一方、同じモデルを別のハーネスで動かした場合の差は中央値で約3ポイントでした。ハーネスの選択は主に実行コストに効く、とGoogleは説明しています。ハーネスの1つであるAntigravityを含むGoogleのエージェント環境の動向は、Claude Opus 5.5とあわせて扱った記事でも整理しています。
IT Postでは、PLEの面白さは「AIの弱点を、知識ではなく実務の作法の側に見つけた」点にあると考えます。旧版の図面を最新と取り違える、規範の版を確認しない、制約を1つ落として全体を通らなくなる——どれも人間の新人技術者がやる失敗とよく似ています。逆に言えば、この種の失敗は、モデルの賢さだけでなく、渡すフォルダの整理や検証の段取りといった、使う側の実務設計で減らせる部分でもあります。