AI・生成AI Ai2「XYBench」8,115問、主要モデルは「頼まれたこと」に答えて「本当の困りごと」を見落とす Allen Institute for AI(Ai2)は2026年11月13日、利用者の思い込みに基づく頼み事へAIがどう応じるかを測るXYBench(8,115問)を公開した。対象5モデルの結果、ベンチの作り方、限界を一次資料で整理した
まず初めに
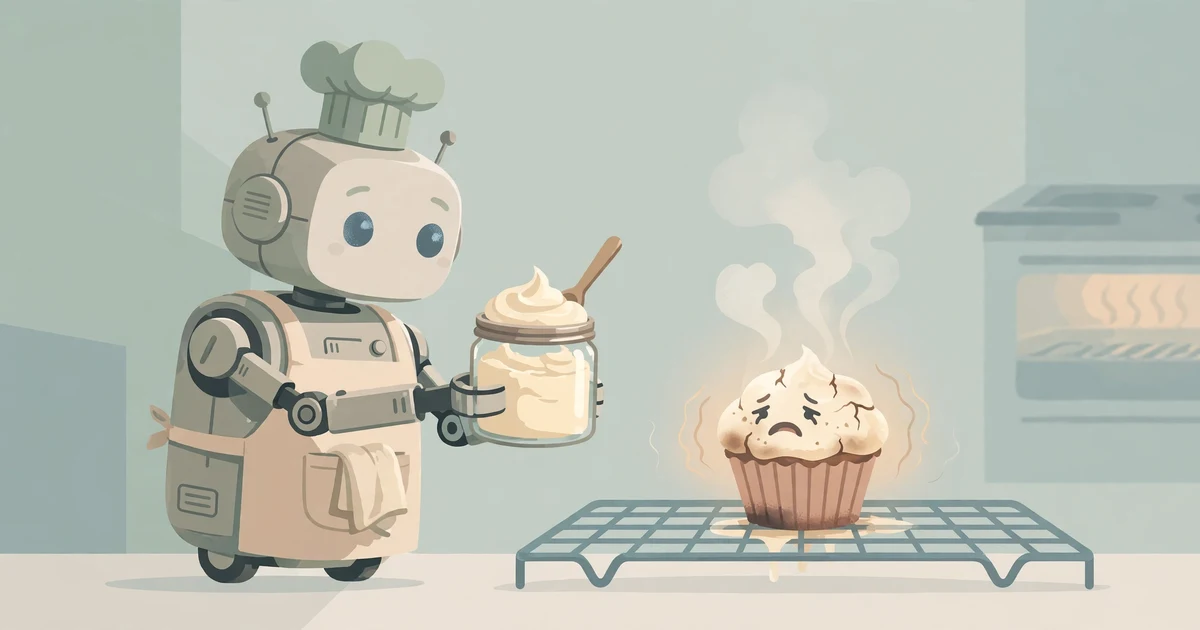
「カップケーキのクリームが滑り落ちる。固くするにはどうすればいい」。本当の問題は、ケーキがまだ温かいことだ。手段の相談に手段で答えるのは、丁寧なようでいて一番の遠回りになる。人間同士なら「まず冷ませ」と笑って済む話だが、AIは頼まれた通りに全力で答えてしまう。言われたことをやる能力と、言われたことの間違いに気づく能力は、まったく別の筋肉だったという話だ。
※個人の感想です
XY問題とベンチの作り方
Ai2の公式ブログによると、XYBenchが測るのは「XY問題」への応答です。利用者は目的Xを達成したくて、手段Yが効くと信じ込み、Yへの助けを求めます。助け手に求められるのは、Yへの回答だけでなく、前提の思い込みに気づき、本来の目的に沿う解決へ誘導することです。
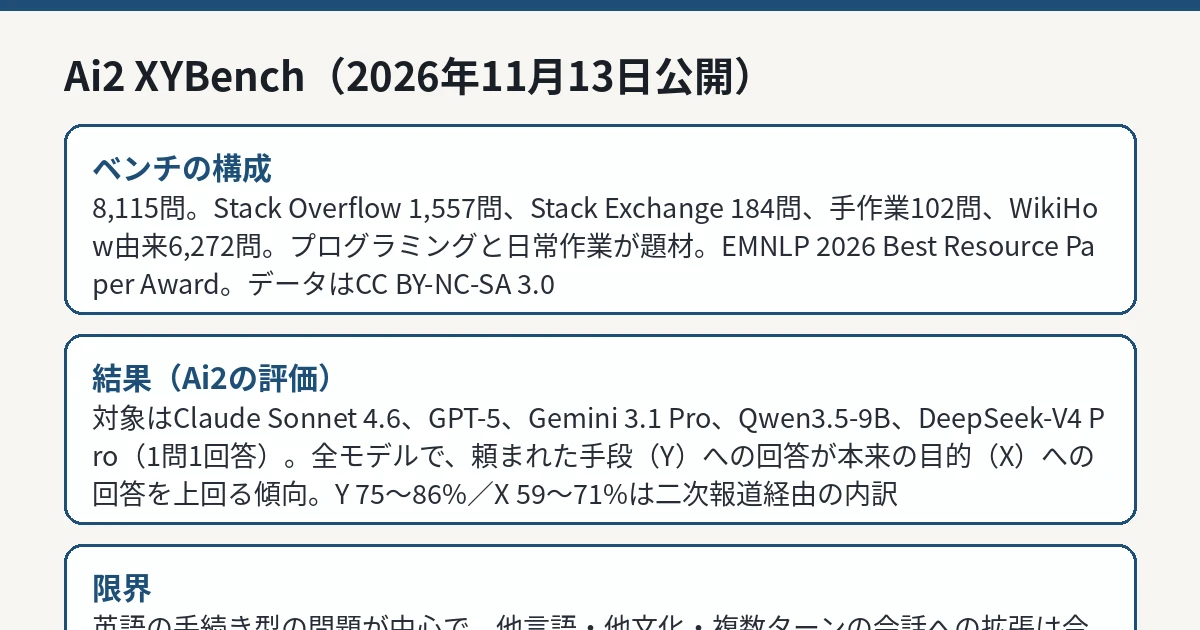
問題は8,115問で、出典は4種類です。Stack Overflowから1,557問、Stack Exchangeから184問、手作業で整えた102問、WikiHowの手順ガイドから生成した6,272問です。題材はプログラミングと、料理や家の修理といった日常の作業にまたがります。開発にはカーネギーメロン大学、NVIDIA、ジョンズ・ホプキンス大学の研究者が加わっています。データセットはHugging Faceで公開され、ライセンスはCC BY-NC-SA 3.0、評価用のコードもGitHubで公開されています。
XYBenchの構成と評価結果を整理した図解 IT Post編集部 評価結果(Ai2の公表)
評価は1問に1回答の単発設定で行われました。対象はClaude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B、DeepSeek-V4 Proの5モデルです。Ai2によると、どのモデルも利用者の問題への解決策は示すものの、回答の重心は元の間違った手段のほうに残りました。
二次報道が伝える内訳では、頼まれた手段(Y)への解決が回答の75〜86%に現れたのに対し、本来の目的(X)への解決は59〜71%にとどまりました。目的に焦点を当てた回答の割合は35〜41%という整理もあります。いずれもAi2の評価に基づく数字であり、モデル同士の優劣を競う表ではなく、「全モデルに共通する傾向」を示す結果として公表されています。特定のモデルの順位付けに使う数字ではありません。
限界と位置づけ
Ai2自身が挙げる限界もあります。現在のXYBenchは英語の質問が対象で、題材は手続き型の問題が中心です。他の言語や文化、複数ターンにわたる会話の文脈への拡張は、今後の方向として残されています。つまり、この結果をもって「AIは日本語でも同じように思い込みを見落とす」とまでは言えません。傾向の存在を示す材料であり、言語や場面ごとの再測定が要ります。
それでも、このベンチが刺す場所は正確です。従来のベンチマークは「正しい答えを出せるか」を測ってきましたが、XYBenchは「間違った問いに、正しく気づけるか」を測ります。実務の相談は、たいてい前提のどこかが少しずれている。そのずれを拾えるかどうかは、点数の高いモデルかどうかとは別の物差しです。
具体例で見る「ずれ」
公式ブログが挙げる例は、日常の料理です。「カップケーキに塗るフロスティング(砂糖衣)が滑り落ちてしまう。どうやって固くすればいいか」という相談です。手段(Y)は「フロスティングを固くする」ことですが、本当の問題(X)は、カップケーキがまだ温かく、冷める前に塗っていることです。正しい助けは、固める方法の改良ではなく「まず冷ましてから塗る」という前提の修正になります。
プログラミングの相談でも構造は同じです。利用者は「この方法で実現したい」と手段を固定して聞きますが、手段そのものが目的に対して遠回りだったり、前提の理解がずれていたりすることがあります。人間の助け手は会話の中で前提を聞き返せますが、単発の質問応答では、モデルは書かれた手段をそのまま受け取るしかありません。XYBenchはこの「聞き返しが起きるかどうか」を、8,115問という規模で数値にしたものです。
数字の読み方
結果を読む際の注意点は3つあります。第1に、これはAi2自身が設計し、Ai2自身が採点した評価であり、独立した第三者の再現はまだ示されていません。第2に、評価は1問1回答の単発設定です。複数回のやり取りで前提を確認し直す使い方では、結果は変わり得ます。第3に、対象は英語の手続き型の問題に限られます。料理、手順、プログラムといった「手順の相談」に寄った題材であり、あらゆる種類の質問への一般化はできません。
裏を返せば、この3条件の中でさえ全モデルに共通の傾向が出た、というのが結果の重みです。個別モデルの優劣ではなく、現在の言語モデル全体の振る舞いの癖として読むのが、公表の趣旨に沿っています。
IT Postの見方
IT Postでは、XYBenchの価値はモデルの採点表ではなく、利用者側への警告として読むべきだと考えます。AIへの頼み方が下手なのではなく、頼み方に思い込みが混ざるのは人間の標準仕様だ。問題は、AIがその思い込みを増幅する方向に最適化されてきたことです。頼まれた手段に素早く正確に答えるほど「役に立つ」と評価される仕組みでは、前提を疑う一言はむしろ減点対象になりかねない。
だからこの結果は、モデル提供者への宿題であると同時に、使う側の作法の話でもある。「Yをやりたい」ではなく「Xに困っている」と目的から書く。それだけで回答の当たり外れは変わる。8,115問のテストが突きつけたのは、AIの弱点というより、人間の相談の下書きの弱点だ。ベンチマークのくせに、読み手のほうを採点してくる。なかなか意地の悪い、良いテストだ。
今後どうなりそうか
今後は、複数ターンの会話や他言語への拡張版が出るかどうかと、各モデル提供者が「前提の誤りに気づく」振る舞いを評価や調整に組み込むかどうかが焦点になります。利用者側でも、相談の書き方として目的を先に置く習慣は、モデルが改良される前から効きます。XYBenchの数字はAi2の評価として更新を追い、独立した再現が出れば併せて扱います。