AI・生成AI Google /teamwork、2013年の予想を証明しヴェイユ予想を機械検証。AIの成果発表としては桁が違う Google Researchは2026年11月13日、Antigravityの/teamworkによる研究成果を公表した。Courtade–Kumar予想の証明とLean 4での5,000万行の形式化、ヴェイユ予想の約180万行の自律的な形式化、分子構造の同定結果などを、同社の公表として整理した
まず初めに
AIの成果発表は、ベンチマークの点数が数ポイント上がった、という話が相場だ。ところが今回は、未解決予想の証明だの、証明を機械に読ませるためのコードが5,000万行だの、スケールの単位からして会話が噛み合わない。桁違いの成果を桁違いの物量で押し切る。美しいかどうかは別として、こういう力押しを「研究の相方」と呼ぶ時代になったことだけは確かだ。
※個人の感想です
/teamworkの設計(Googleの説明)
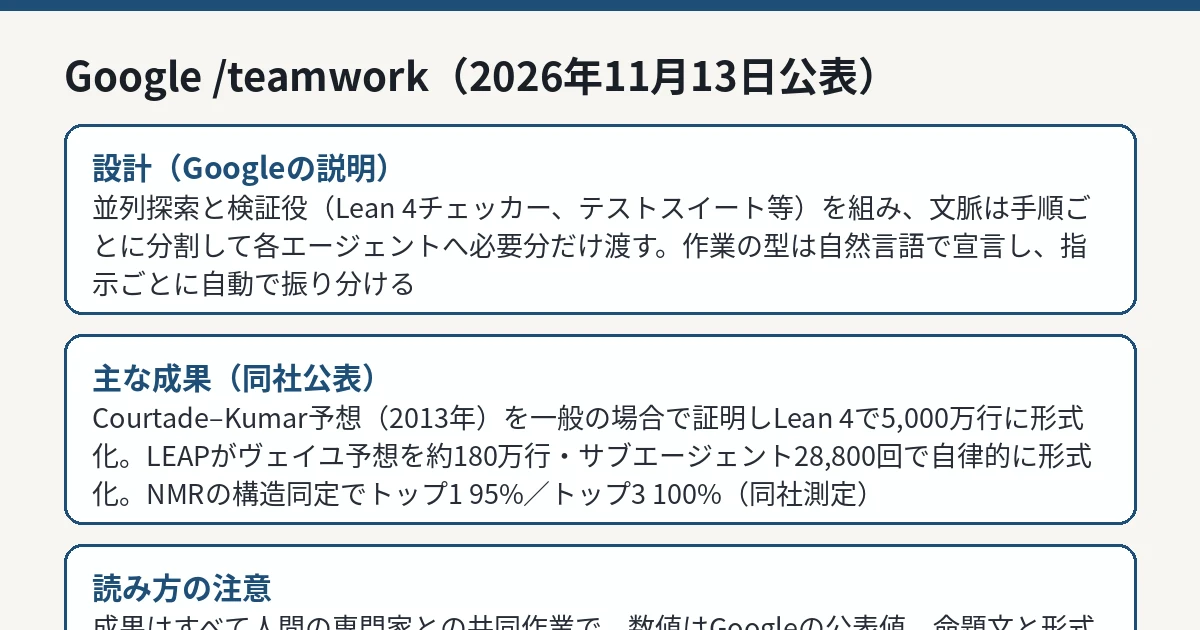
Google Researchの公式ブログによると、/teamworkはAntigravityの中で動くマルチエージェントの仕組みです。同社は現在の言語モデルの限界を2つ挙げています。1つは、生成が不安定で1回の試行と正解の間に開きがあることへの対処で、並列に探索させ、Lean 4の証明チェッカーや改変していないソフトウェアのテストスイート、実行シミュレータなどの検証役(falsifier)と組ませて、どの候補が実際に通るかを自動で確かめます。
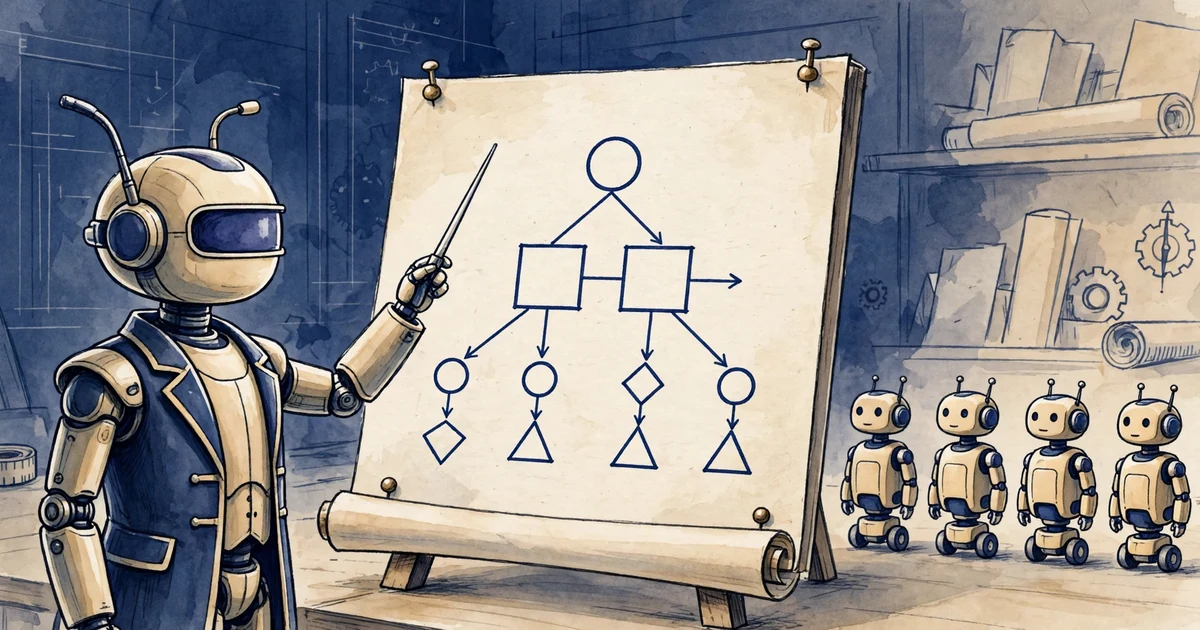
もう1つは、数日に及ぶ作業でモデルが細部を見失うことへの対処です。/teamworkは文脈を最初から分割し、各専門エージェントには、その手順に必要なファイルとツールだけを渡します。調整役は新しい後継者に仕事を引き継ぎ、批判役と監査役は元の作成者の推論を持たない清潔な文脈から結果を検証します。作業の型は自然言語で宣言的に記述され、利用者の指示ごとに適した型へ自動で振り分けられます。多くの機能はAntigravityで既に使え、今後数週間で外部利用者向けの更新を続ける、としています。
/teamworkの検証の仕組みと主な成果を整理した図解 IT Post編集部 数学での成果(Googleの公表)
最も大きな成果として挙げられているのが、情報理論のCourtade–Kumar予想(2013年)の証明です。Google、中国香港中文大学(CUHK)、南カリフォルニア大学(USC)、カーネギーメロン大学(CMU)の研究者が、/teamworkのLong Proofパターンを使い、一般の場合で証明したとしています。経緯も具体的で、まずGeminiが一般化した予想への反例を見つけ、CUHK側が新しい候補関数を提案して14変数の最適化問題へ帰着させ、Gemini 4 Argon等がパラメータ空間の分割や解析的な評価の多くを担い、証明全体をLean 4で形式化したコードは5,000万行に上る、としています。
形式化の規模は他の成果でも桁違いです。Google Cloud AIと開発した枠組みLEAPは、有限体上の多項式方程式の解の数え上げに関するヴェイユ予想について、約180万行のLeanによる機械検証可能な形式化を完全に自律的に生み出したとされています。サブエージェントの呼び出しは28,800回です。ヒルベルトの第10問題の最近の証明の初の形式化は919,000行超、1927年以来未解決だったBirkhoff予想の初の形式化、50年以上未解決の3次元Bochner–Riesz予想の形式化では、最近公表された非形式的な証明の隙間を見つけて直した、とも述べられています。
このほか、2014年以来の開きを閉じた適応的データ解析の標本境界、量子クエリ計算量の2014年の未解決問題の決着など、最適化・統計・アルゴリズムの複数分野での結果が並んでいます。いずれも「著者が検証し、簡略化し、公表用に編集した」という位置づけで、Googleの公表として読む必要があります。
化学と査読支援への展開
実験科学への応用として、核磁気共鳴(NMR)データから分子構造を決める課題が挙げられています。30の専門エージェントを自己修正ループに組み、物理を踏まえたスペクトルシミュレータと組ませた結果、複雑なベンチマーク分子でトップ1の完全一致が95%、トップ3では100%に達し、単一エージェントの性能をほぼ2倍にしたとしています。これも同社の測定です。
原稿の査読支援「Deep Review」も/teamworkの文書レビューの型として提供されます。コンピュータサイエンスの会議STOC 2027では、投稿578件(全体の3分の1超)の著者がフィードバックを希望しました。回答者70名のアンケートでは、90%がフィードバックは概ね事実に沿っていると答え、90%が再利用したいと答え、30%超が実質的な証明の誤りや数学的に重要なタイプミスを指摘された、としています。標本は小さく自己選択的である点は、二次報道も指摘しています。利用者は週2回まで無料で使えるとされています。
IT Postの見方
IT Postでは、今回の発表で一番重いのは「証明した」ことではなく「検証できる形で出した」ことだと考えます。AIの研究成果は、主張の検証コストが読み手に転嫁されがちだ。その点、Leanで形式化された証明は、命題文の対応さえ人間が確認すれば、あとは機械が1行ずつ検算する。5,000万行という物量は笑ってしまうほどだが、検証可能性という意味では、短い主張よりよほど誠実な出し方だ。
ただし、割り引くべき部分もはっきりしている。成果はすべてGoogleの自己申告で、使われたモデルは自社のGemini 4世代、土俵も自社のAntigravityだ。「人間の専門家との共同作業」という但し書きが示すとおり、AI単独の成果として切り取るのは公表文自身の趣旨に反する。外部の研究者が同じ土俵で何を再現できるか。ツールの外部開放と、研究者向けのアクセスプログラムの行方こそが、この発表の本当の検証になる。
今後どうなりそうか
今後は、外部研究者による/teamworkの利用事例と、公表された証明・形式化への第三者の検証が焦点になります。Dynamic Workflowsのような開発向けの並列実行 と同じ週に研究向けの成果が並んだことで、Antigravityは「エージェントを束ねる場所」としての性格を強めています。成果の再現報告が出てくるまでは、各数値をGoogleの公表値として扱い、誇張も過小評価もしないで待つのが妥当です。