AI・生成AI Nex-N2.6公開、321Bのエージェント特化モデルが「同じ推論の繰り返し」を16%から1.6%へ Nex-AGIがHugging FaceでNex-N2.6を公開。GLM-5.3-Flashを土台にした約321Bパラメータのマルチモーダルなエージェント向けモデルで、FP8量子化の重みとApache 2.0ライセンスで配布される。OSWorld 83.0などの公表スコアはチーム自身の報告であること、AutomationBenchでは土台モデルを下回る項目もあることまで、モデルカードの数字をそのまま整理した
まず初めに
エージェント向けモデルが陥る一番みっともない失敗は、間違えることではない。同じことをぐるぐると繰り返して、永遠に終わらないことだ。利用者から見れば、賢さの不足より「止まれない」方がよほど怖い。Nex-N2.6が真っ先に掲げたのが、その繰り返し率の削減だったのは分かっている。ベンチマークの王座争いより先に、「ちゃんと仕事を終える」ことを直しに来たわけだ。
※個人の感想です
モデルカードの内容
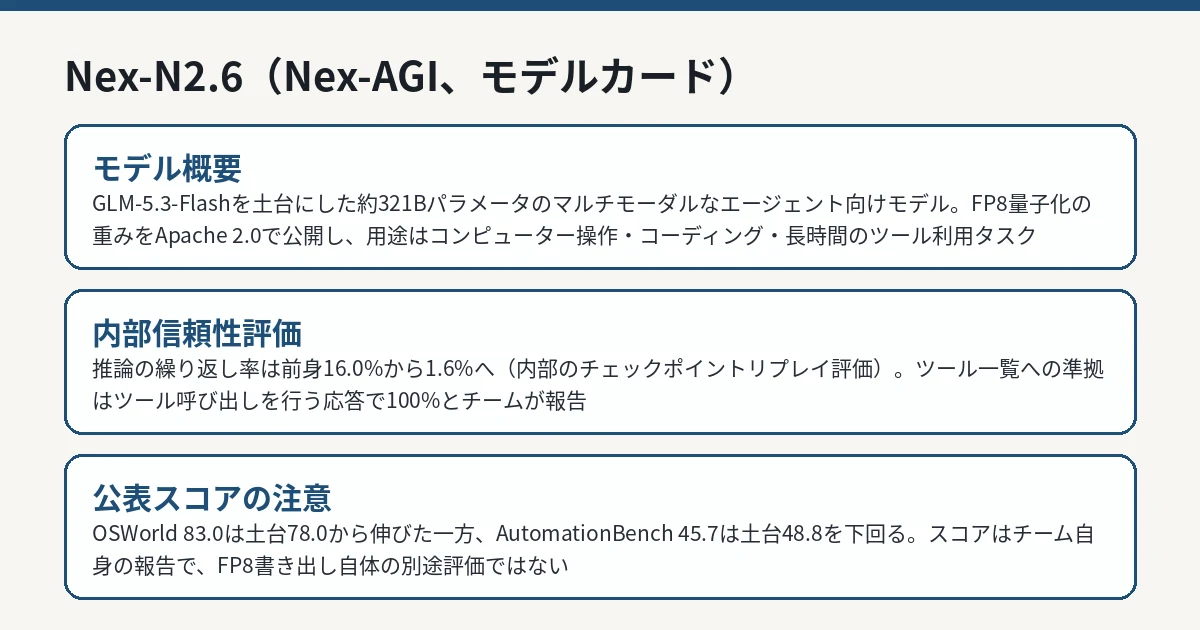
Hugging Faceのモデルカードによれば、Nex-N2.6はNex-AGIによるマルチモーダルなエージェント向けモデルで、GLM-5.3-Flashを土台に構築されています。用途として想定されているのは、コンピューターの操作、コーディング、そして道具を伴う長時間のタスクです。このリポジトリには、約321BパラメータのFP8量子化された重みが収められています。モデルカードのメタデータでは、ライセンスはApache 2.0とされています。
前身のNex-N2.5-Proからの焦点は、反復的な推論を減らすことと、現在の環境で使える道具の一覧への準拠を改善することだと説明されています。
公表されているスコア
モデルカードに掲載された、Nex-AGIチーム自身による報告値は次のとおりです。チーム自身が注意書きしているとおり、これらは評価の設定に依存するモデルレベルの結果であり、このFP8書き出し自体を別途評価したものではありません。
ベンチマーク
GLM-5.3-Flash(土台)
Nex-N2.5-Pro
Nex-N2.6
OSWorld
78.0
82.2
83.0
Terminal-Bench 2.1
84.3
82.7
84.1
AutomationBench
48.8
44.2
45.7
Nex-N2.6の公表スコアと内部信頼性評価を整理した図解 IT Post編集部 内部の信頼性評価として、チームは次の数字も公表しています。既知の問題を再生する形の内部評価(チェックポイントリプレイ)で、推論の繰り返し率はNex-N2.5-Proの16.0%から1.6%へ減り、相対で90%の削減だったとしています。また、ツール呼び出しを行う応答におけるツール一覧への準拠は100%だったと報告しています。いずれも内部評価であり、第三者による再現評価ではない点には注意が必要です。
正直に書いておくべきなのは、AutomationBenchではNex-N2.6(45.7)が土台のGLM-5.3-Flash(48.8)も、DeepSeek-V4.1-Flash(54.8)も下回っていることです。OSWorldの伸びと並べて読むと、「コンピューター操作は伸びたが、自動化タスク全般で勝ったわけではない」というのが、カードの数字が実際に語っている内容です。
内部評価の読み方
モデルカードの内部信頼性評価は、チームやパートナーの実際のタスクで遭遇した問題を基に作られていると説明されています。手法は、直前の会話とツールの出力を固定したうえで、モデルの次の応答を試す「既知問題のリプレイ」と、生成されたツール呼び出しがリクエストで宣言されたツールだけを使っているかを調べる「ツール一覧準拠」の2つです。公表されている関連指標は次のとおりです。
指標
Nex-N2.5-Pro
Nex-N2.6
推論の繰り返し率(低いほど良い)
16.0%
1.6%
非繰り返し率(全体)
91.0%
97.8%
有効なツール選択率(全体)
82.2%
100.0%
有効なツール選択率(ツール使用時)
80.5%
100.0%
数字の並びは見事ですが、読み方には注意が要ります。これは「実際に起きた失敗」を材料にした身内の試験であり、出題範囲が自分たちの弱点に寄っています。弱点を直した結果が良くなるのは当然で、未知のタスクでも同じ率が出る保証にはなりません。それでも、失敗の種類を名指しして、その再発率を測るという方法自体は、総合スコアの平均点よりも運用現場には役立つ情報です。100%という数字は「この試験の範囲では」という限定付きで読むのが正確です。
検証するならどこを見るか
導入を検討する側が自分の環境で確かめるべきなのは、公開ベンチマークの再現よりも先に、次の3点です。第一に、長時間のタスクで同じ推論や同じツール呼び出しを繰り返して止まらなくなる頻度。第二に、宣言していないツールを勝手に呼び出そうとする頻度。第三に、コンピューター操作の途中で画面の変化を取り違えて、誤った対象を操作する頻度です。いずれも、カードが掲げる改善点にそのまま対応する項目であり、数十件程度の自社タスクでも傾向は掴めます。逆に、これらを測らずにOSWorldの83.0だけを見て乗り換えると、カードの一番の主張を検証しないまま買い物することになります。
使い方と導入の現実
モデルカードでは、GLM-5.3-Flashに対応した推論ランタイムを使うことが案内されており、セルフホストの場合はSGLangの公式デプロイガイドに従い、FP8対応の構成を選ぶよう書かれています。同梱のチャットテンプレートは、推論の強さを表す値としてlow、high、maxをサポートし、既定はmaxです。
約321BパラメータのFP8重みは、一般的な個人向けマシンで気軽に動かせる規模ではありません。ローカル実行の現実味は、複数GPUや大容量メモリを持つ環境に限られます。API経由の提供については、モデルカードからOpenRouterへの導線が案内されています。
IT Postの見方
IT Postでは、今回の発表で評価できるのは、派手な総合スコアではなく「繰り返し率」と「ツール準拠」という、エージェントの実務の急所を数字で出した点だと考えます。エージェントが現場で信用を失うのは、難しい問題に答えられないときではなく、簡単な作業で暴走したときです。もっとも、その数字が内部評価のままでは、買い手は検証のしようがありません。次の焦点は、第三者の評価や、実際の運用報告でこの1.6%が再現されるかどうかです。AutomationBenchの下げをカードにそのまま載せている点は、少なくとも数字の出し方としては誠実な部類だと考えます。
今後どうなりそうか
オープンな重みが公開されているため、量子化版の派生や、推論基盤側の対応が進むとみられます。利用を検討する場合は、まず自分のタスクで「繰り返し」と「ツールの誤用」が実際に減るかを、小さな検証で確かめるのが現実的です。公表スコアだけで導入を決める段階のモデルではありません。