AI・生成AI Google、文章を書かないAI「Gemini Decision 1」を発表。1,000問の判定を1回の処理で返し、料金は100万トークン0.10ドル、出力は無料だった Googleは2026年11月11日、文章を生成しない判定専用モデル「Gemini Decision 1」とDecisions APIを発表した。テキストや画像などの共有入力に対し、最大1,000件のyes/no・選択式・ルーブリック採点を単一の処理で評価し、確率と信頼度を返す。応答は150〜250ミリ秒、料金は入力100万トークンあたり0.10ドルで出力トークンは課金されない
まず初めに
AIモデルというと、文章を書くのが仕事だった。ところが現場のAIの仕事の半分くらいは、実は判定である。この画像は規約違反か、この書類は条件を満たすか、この回答は何点か。いちいち長文で「理由はですね」と返されても、プログラムからすれば困る。欲しいのは数字と確率だけだ。そこへGoogleが、作文を一切やめて判定だけに振り切ったモデルを持ってきた。賢さの競争の隣で、いつの間にか「安く、速く、黙って判を押す」競争が始まっていた、という話である。
※個人の感想です
何が発表されたのか
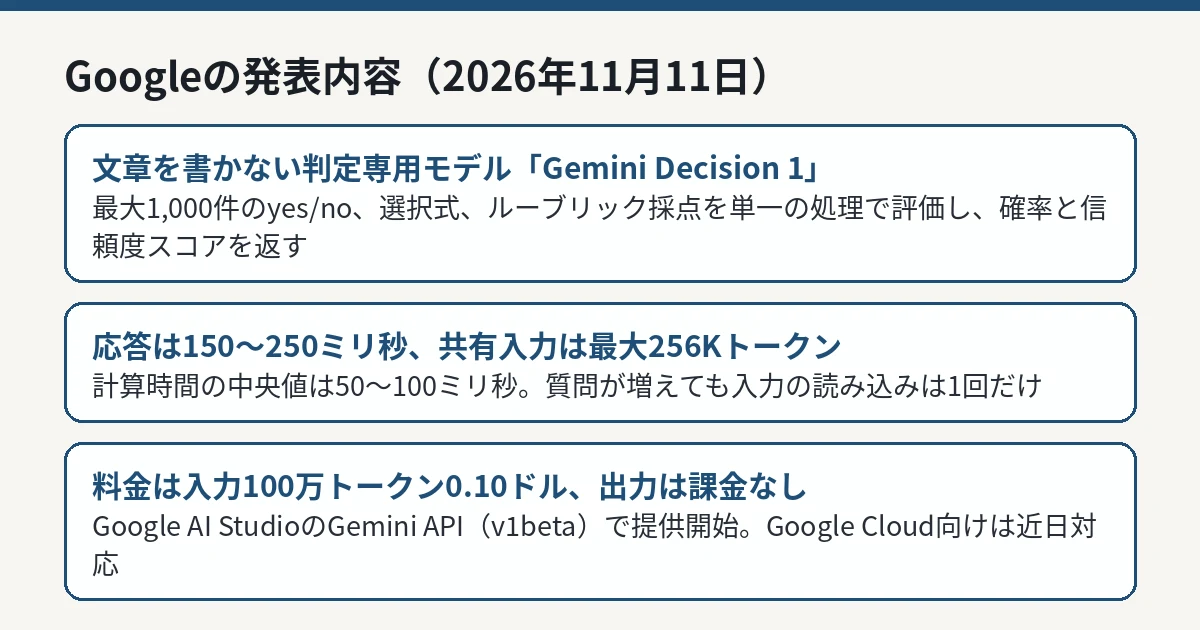
Googleが2026年11月11日に公式ブログで発表した「Gemini Decision 1」は、同社の言う「判断のために作られたモデル」です。通常の大規模言語モデル が文章を生成するのに対し、このモデルは入力を評価して、構造化された判定結果だけを返します。
判定の型は3種類あります。一つ目は「noul」で、yes/noの条件が成り立つ確率を推定します。二つ目は「choice」で、2〜255択の中から選びます。三つ目は「score」で、順序のあるルーブリック(採点基準)に基づいてスコアを付けます。いずれも、答えと一緒に確率と信頼度スコア(0〜1)が返るため、受け取る側のプログラムは「信頼度が低いものだけ人間が確認する」という振り分けができます。
Gemini Decision 1の判定の仕組みと料金、応答時間を整理した図解 IT Post編集部 仕組みの肝は、入力を一度だけ読み込む点です。共有入力は最大256Kトークンまで受け付け、そこへ最大1,000件までの独立した質問をぶら下げられます。質問ごとにモデルを呼び直すのではなく、1回のフォワードパスでまとめて評価するため、質問が増えても入力の読み込みコストは増えません。Googleの発表では、モデル自体の計算時間の中央値は50〜100ミリ秒、端から端までは150〜250ミリ秒で、16Kトークンまでのマルチモーダル入力と文脈では、質問が1件から100件に増えてもほぼ横ばいだとされています。
料金と提供形態
料金は、入力100万トークンあたり0.10ドル、出力トークンは0ドルです。無料枠も用意されています。判定結果は短い構造化データなので、出力に課金しない設計は判定専用ならではです。Googleは比較対象として、Gemini 3.5 Flash-LiteをInteractions APIで使う場合を挙げ、Decisions APIは約5倍安いとしています。
提供は、Google AI StudioのGemini API(v1beta)から始まります。Gemini in Google Cloud向けは「近日対応」とされています。また、OpenRouter、LangChain、Vercelなどへの展開も進められていると発表されています。
項目
内容(Googleの発表)
モデルID
gemini-decision-1
判定の型
noul(yes/no)、choice(2〜255択)、score(ルーブリック採点)
共有入力
最大256Kトークン、テキスト/画像/音声/動画/PDF
1リクエストの質問数
最大1,000件
応答時間
計算の中央値50〜100ミリ秒、全体で150〜250ミリ秒
料金
入力100万トークン0.10ドル、出力は課金なし、無料枠あり
なお、性能や速度の数値はGoogleの発表に基づくもので、第三者による独立した検証結果は、この発表には含まれていません。
Google自身の使い方と、判定モデルの系譜
Googleは社内利用の例として、Gemini Notebookでのルーターとしての利用を挙げています。問い合わせの振り分けにこのモデルを使うことで、深い推論が要るものだけを大きなモデルへ回し、全体の応答時間を最大で40%短縮したとしています。判定役を安いモデルに任せ、考える仕事を高いモデルに残す、という分業の形です。
判定専用モデルは、Googleが初めてというわけではありません。本誌でも、KakaoのKanana decide やOpenAIのDecisions API を取り上げてきました。各社が同じ場所に集まってきたのは、生成モデルの呼び出し回数の中で、実は「判定」が大きな割合を占めているからだとみられます。コンテンツの審査、書類の確認、回答の採点、振り分け。派手さはないが、回数の多い仕事です。
IT Postの見方
IT Postでは、この発表の意味は「AIのコスト構造の主戦場が、考えることから判定することへ広がった」点にあると考えます。これまでの価格競争は、賢い文章をどれだけ安く書けるかだった。しかし実務の呼び出しを分解すれば、文章生成そのものより、その前後の判定、振り分け、採点の方が回数は多い。そこに専用モデルと「出力無料」という料金表を持ち込むのは、単なる値下げではなく、仕事の取り方の変更である。
もう一つ面白いのは、返ってくるのが文章ではなく確率と信頼度だという点だ。生成モデルの出力をプログラムで処理しようとすると、文章を解釈し直す手間が必ず付いてくる。判定専用モデルはその手間を最初から捨てている。派手な知性の話ではない。だが、AIを業務の部品として組み込む側からすれば、こういう「黙って判を押す部品」の方が、賢い作文家より先に現場へ広がる可能性が高い。
安さと速さの数値はGoogleの自己申告であり、判定の正確さが用途に足りるかは、使う側が自分のデータで確かめる話です。その検証の手間まで含めて、この料金が本当に割に合うかはこれから分かります。
今後どうなりそうか
注目点は二つあります。一つは、Google Cloud向けの提供が始まる時期と、その際の料金と制限です。もう一つは、OpenRouterやLangChainなどへの展開が進み、他社の生成モデルと組み合わせた「判定だけGoogle」という構成がどれだけ広がるかです。
判定専用のモデルやAPIは各社から出そろい始めています。今後は、判定の正確さのベンチマーク と、信頼度スコアの校正(スコアと実際の正しさの一致具合)が競争の軸になっていくはずです。文章の上手さではなく、判の押し方の正確さで比べられるモデルの時代が、静かに始まっています。