AI・生成AIOpenAI、ChatGPTの性能劣化をCodexエージェントが自動調査・修正する「Performance Factory」を公開。3か月で調査1,700件超、人間の仕事はPRの承認になった
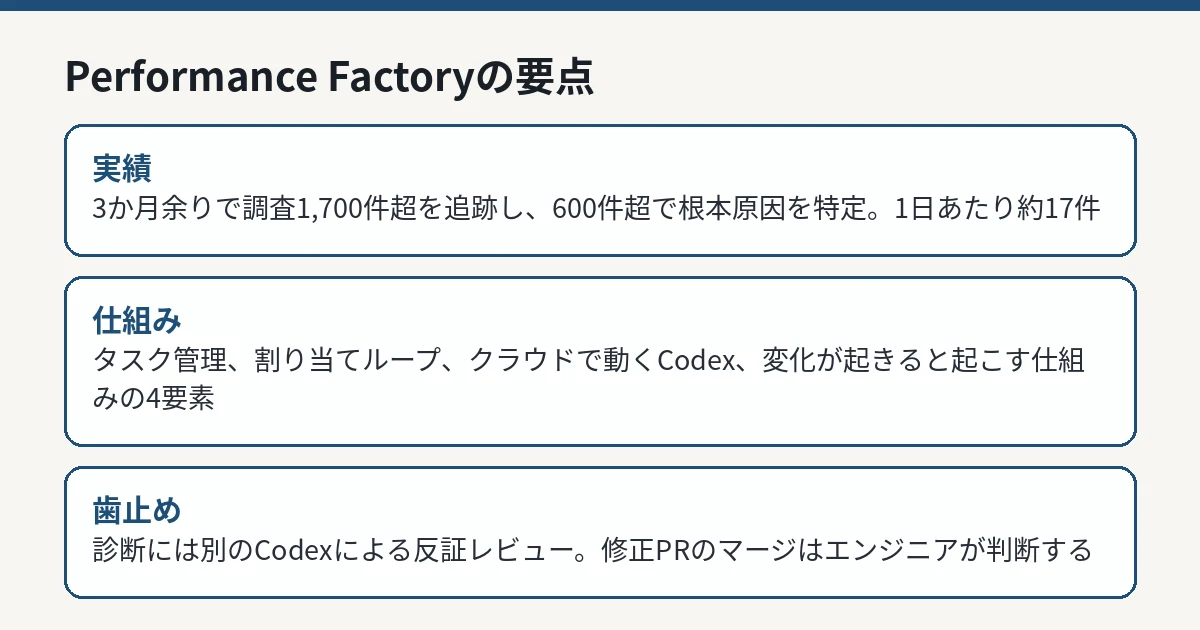
OpenAIは2026年11月19日、ChatGPTの性能劣化をAIエージェントが自動で調査し修正まで進める社内システム「Performance Factory」の詳細を公開した。中心のRegression Workflowは3か月余りで1,700件超の調査を追跡し、600件超で根本原因を特定。1日あたり約17件の調査が自動で回っている。診断には別のCodexセッションによる「反証レビュー」が組み込まれ、修正のPRはエンジニアがレビューしてマージを決める。
まず初めに
AIが遅い。なぜ遅いかを調べるのもAI、直す案を出すのもAI、その案にケチをつけるのもAIである。Performance Factoryという仰々しい名前の工場で作られているのは、製品ではなく「言い訳のつかない調査結果」と「承認待ちのプルリクエスト」だ。人間のエンジニアはラインの末端に立ち、判を押す係になった。
笑い事ではないのが、この工場が3か月で1,700件も調査を回している点だ。1日17件。人間の性能チームが同じ数をこなそうとすれば、まず会議が増え、次に燃え尽きる。機械は疲れない代わりに、疲れた人間のように「だいたいこれでしょう」で手を打つ癖があったらしい。だから反証専門のもう1台を横に置いた。実に英国議会のような仕組みで、野党の仕事は与党の診断を疑うことである。
※個人の感想です
システムの構成——4つの部品と状態を持つタスク
OpenAIの説明によると、Performance Factoryは4つの要素で構成されます。設定可能なワークフローを持つタスク管理サービス、準備のできた仕事をエージェントへ割り当てるディスパッチループ、クラウドでCodexを実行するAPI、そしてGitHubのレビューコメントやデプロイ完了といった変化が起きたときにエージェントを起こすサブスクリプションです。各タスクは状態と調査結果を保持し、コードレビューやデプロイを挟んでも、エージェントとエンジニアの間で仕事を引き継いで再開できる設計です。
ここに至るまでの経緯も公開されています。当初はCPUプロファイラなどの性能ツールが30以上蓄積され、エンジニアがCodexに「なぜ遅くなったのか」と相談する段階を経て、調査手順を「perf-forensics」のような再利用可能なスキルとして切り出しました。やがてエンジニアはアラートをCodexへ貼り付け、結果をSlackへ戻す「人間のプロキシ」になり、その非効率さから、調査の自動起動、さらには調査から復旧確認までを通す現在の工場形態に至った、という流れです。
診断への「敵対的レビュー」——70%の正確さ
エージェントは当初、もっともらしい最初の説明で止まってしまうことがあり、その診断の一部は誤りでした。対策として導入されたのが敵対的レビューで、別のCodexセッションが提案された診断の反証を試みます。前提を再確認し、「その変更が原因なら、影響を受けていない同種のリクエストは正常なはずだ」「原因とされる変更を戻したなら、指標は回復したはずだ」といった反実仮想を検証します。
実例として、ChatGPTの会話失敗を画像ダウンロードのエラーと診断した調査では、レビュー側が、ファイルを探す内部サービスは既に復旧しているのに画像リクエストは失敗し続けていることに気づき、診断では継続する失敗を説明できないとして調査を差し戻しました。
精度の自己申告も率直です。
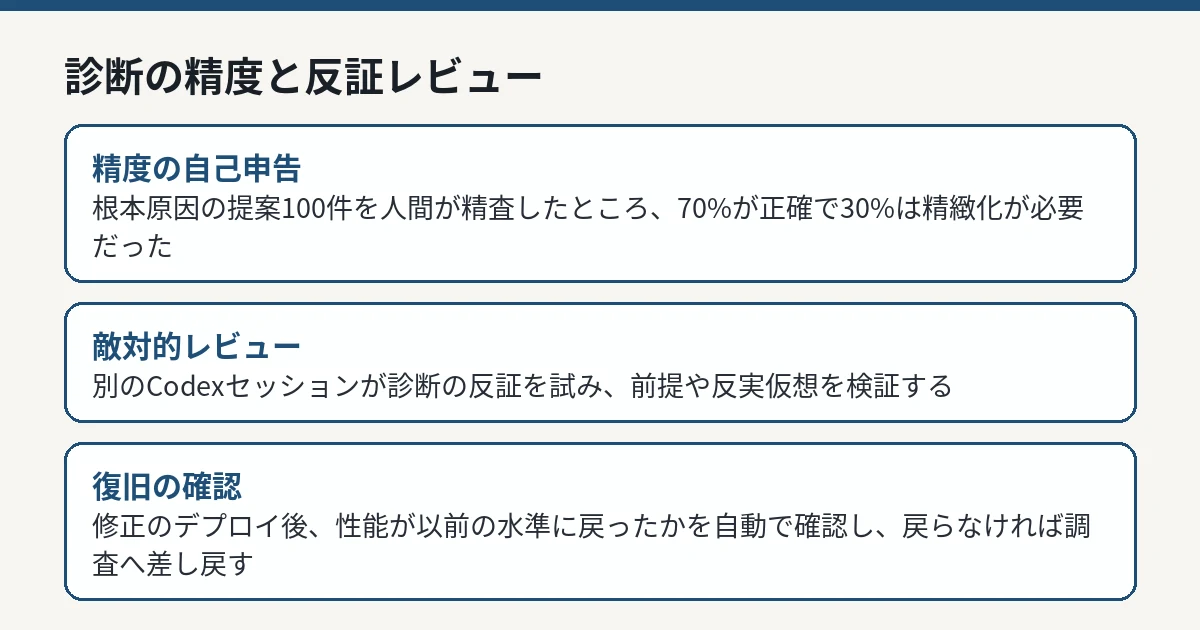 根本原因の提案100件を人間が手作業で精査したところ、70%が正確で、30%はさらなる精緻化が必要か、因果関係を完全には立証できていませんでした。
修正はPRで、人間がマージを決める
診断が敵対的レビューを通過すると、ワークフローはCodexに修正の実装とプルリクエストの作成を求めます。マージするかどうかはエンジニアがレビューして決めます。各タスクには、劣化の概要と影響、根本原因、提案する修正をまとめた自動生成のレポートが付き、指標の時系列やCPUフレームグラフ、トレースといった証拠も添えられます。エンジニアがPRにコメントすると、エージェントが起きて対応します。
修正をデプロイした後も、エージェントが性能が以前の水準に戻ったかを確認します。戻ればタスクは解決済みになり、一部だけ回復した場合は元の劣化を解決済みにして残りの遅さについて新しいタスクを開き、改善がなければ記録を残して調査へ差し戻します。
OpenAIは、原因の特定より修正のほうが難しい、としています。エージェントの提案する変更が必要以上に複雑だったり、新しい問題を持ち込んだりする例があり、修正案にも敵対的レビューを入れています。キャッシュの追加のように、速くなる代わりに古いデータを返す恐れがある変更は、サービスを理解するエンジニアの判断が要る領域として残されています。
得た教訓と、次の一手
教訓として挙げられたのは、エンジニアの注意を守ることです。1件の劣化が複数のアラートやチャネルに散らばるため、ワークフローは関連するインシデントを結びつけ、重要視される指標でグループ化し、推定影響の大きい順に並べます。もう1つは、エージェントの変更を評価することです。調査スキルやモデルを更新すると良くなる調査と悪くなる調査が出るため、過去の本番インシデントをテストケース化してバックテストを行い、その際、調査役のエージェントには過去の調査メモやインシデントの報告書、前回の結果を見せない、といった条件管理まで行っているとしています。繰り返し起きるツール側の不具合については、エージェント自身が修正タスクを作る自己修復の仕組みも入っています。
今後は、アラートが鳴る前に性能データを能動的に調べて劣化や最適化の余地を見つける方向や、過剰なレプリカ設定を見つけるサービス適正化スキルのような既知パターンのワークフロー化を進める、としています。OpenAI自身、現在のボトルネックはエンジニアによる修正のレビューとマージ待ちかもしれない、と書いています。
IT Postの見方
IT Postでは、この公開の価値は「AIがコードを書いた」という話ではなく、検証の仕組みをここまで具体的に出した点にあると考えます。診断に反証役を付け、精度を70%と数字で認め、修正の最終判断は人間に残す。派手さはないが、エージェントを本番運用に載せるための部品が一通りそろっています。特に、バックテストで調査役に答えを見せないという条件管理は、地味ながら一番実務的な知見です。評価が甘いエージェントは、賢いのではなく、ただ採点が緩いだけですから。
一方で、「現在のボトルネックは人間のレビューかもしれない」という一節は重い。調査が1日17件自動で流れてくる組織では、承認する側の処理能力がシステム全体の上限になります。判を押す係、というのは冗談のようでいて、実は一番責任の重い席です。その席の設計——何を根拠に、どこまで機械を信じて判を押すのか——が、次の競争領域になるはずです。
今後どうなりそうか
Performance Factory型の「状態を持つタスク+専任の反証役+人間の最終承認」という構成は、性能調査に限らず、障害対応やセキュリティ調査のような「原因を外すと高くつく仕事」へ広がっていくはずです。OpenAIは他のワークフローへの横展開を明言しており、アラートなしで劣化を探す能動監視が実働すれば、検知から修正PRまでの時間はさらに縮みます。
ただし、広がるほど「70%の正確さ」をどう扱うかが問われます。残り30%を人間のレビューで確実に止められる間は工場は回りますが、件数がさらに桁を変えたとき、同じ品質を保てるかは別の問題です。工場の生産量ではなく、不良品の流出率で評価される段階が、エージェント運用にも必ず来ます。