AI・生成AI NVIDIA Rubin HPC、CUDAコアは5万超で提供は2028年。エージェントが実験を回す時代の、計算の蛇口はでかくするしかない NVIDIAは2026年11月16日、科学・工学・解析向けの新しいGPU「Rubin HPC」をSC26で発表した。1基のGPUに5万を超えるCUDAコアを搭載し、疎データの加速と第7世代NVLinkを備える。AIエージェントが候補を大量に試す時代に、シミュレーションの速度がそのまま発見の速度になるという設計で、提供開始は2028年の見込み
まず初めに
コア数5万超。数字だけ見れば、またいつもの「盛った発表」である。だが今回の主語はゲームでも生成AIの学習でもなく、シミュレーションだ。エージェントが「これも試して」「あれも試して」と候補を無限に増やす時代に、試す側の計算が追いつかなければ、賢い提案はただの紙の束になる。蛇口を太くするのは正しい。問題は、その蛇口が届くのが2028年だという一点だけだ
※個人の感想です
何が発表されたのか
NVIDIAの発表によれば、Rubin HPCは、科学、工学、解析のワークフローにおけるシミュレーションとデータ処理を加速するために設計されたGPUです。舞台は、11月15日から20日までシカゴで開かれているスーパーコンピューティングの国際会議SC26です。
背景として同社が挙げるのは、研究の進め方の変化です。科学者や技術者はエージェントと協働し、より多くの材料、分子、設計の候補を探索するようになっています。候補が増えれば、それを評価するためのGPUシミュレーションの需要も増えます。Rubin HPCは、そのシミュレーションを速くし、探索から科学的発見や産業設計までの道のりを短くするための製品だという位置づけです。
同社のハイパースケール・HPC担当副社長イアン・バック氏は、「科学と工学に取り組むエージェントにとって、シミュレーションが速いことは発見が速いことだ」という趣旨を述べ、Rubin HPCがエージェントの使うシミュレーションを加速し、より多くの可能性の探索を助けるとしています。
Rubin HPCの要点 IT Post編集部 仕様の要点——コア数よりも「データ供給」の設計
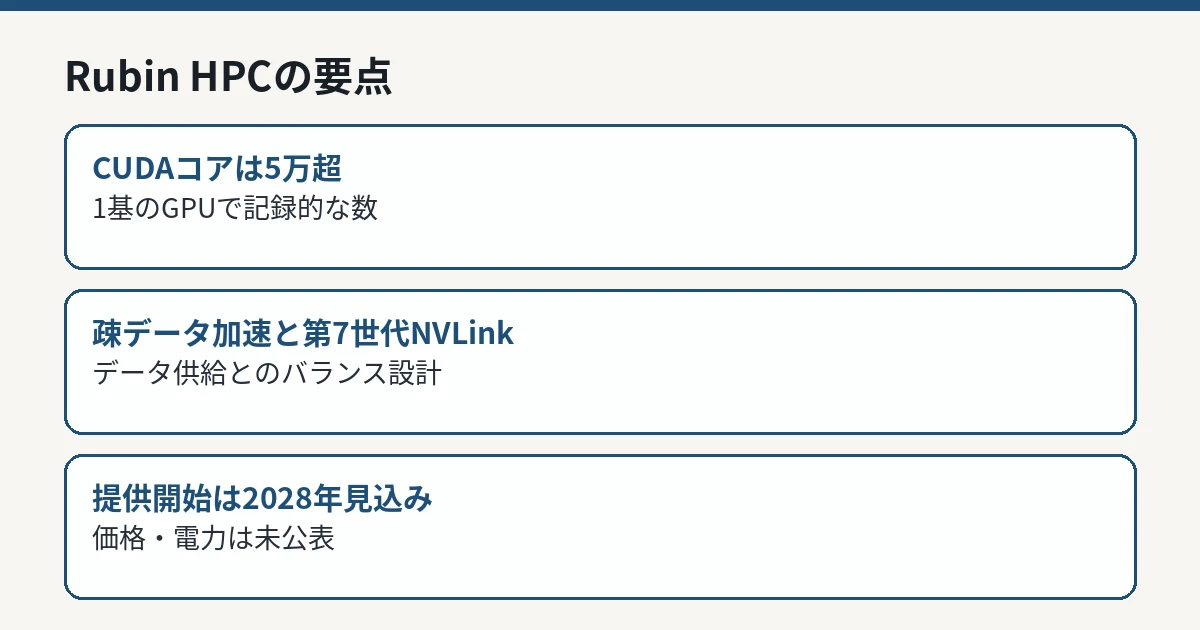
発表で示された仕様の要点は3つです。第一に、1基のGPUに5万を超えるCUDAコアという、記録的なコア数。第二に、そのコアへデータを供給し続けるための疎(スパース)データ加速の仕組み。第三に、GPU同士の接続を加速する第7世代NVLinkです。
同社が強調するのは、コア数そのものよりもバランスです。気候モデル、工学シミュレーション、ゲノム解析、金融リスクといった科学計算のワークロードは共通して、巨大なデータセットの中から散らばった少数の値を集め、計算し、それを膨大な回数繰り返す形を取ります。計算能力だけを上げても、データが届かなければコアは待ち時間ばかりになります。Rubin HPCは、データ移動と計算を一緒にスケールさせるバランス設計で、疎行列演算、ステンシル計算、ソート、リダクションといった、シミュレーションに頻出するパターンを広く加速するとしています。
ソフトウェア側では、複雑なアルゴリズムの最適化実装を集めたCUDA-Xライブラリ群が、エージェントが使える道具として用意されます。仮説、シミュレーション、改良のループが速く回れば、研究者は次の一手を早く選べ、実験の対象を有望な候補へ絞り込めます。
なお、今回の発表では、価格、消費電力、メモリ容量などの詳細な仕様は示されていません。「Blackwell比で何倍」といった性能の倍率も、公式ブログの本文には記載がありません。5万超というコア数と、2028年という時期だけが、現時点で確定している数字です。
対象ワークロードの整理
発表内容を整理すると、次のとおりです。
項目
内容
製品
NVIDIA Rubin HPC(Vera Rubinプラットフォーム)
発表
2026年11月16日、SC26(シカゴ、11月15〜20日)
CUDAコア
1基で5万超(記録的な数と説明)
データ供給
疎データ加速、第7世代NVLink
主な対象
気候モデル、工学シミュレーション、ゲノム解析、金融リスク
頻出パターン
疎行列演算、ステンシル計算、ソート、リダクション
提供開始
2028年の見込み
同じSC26では、机の上に置ける4ノード構成のDGX Spark HPC Developer Kitも発表されています。2028年の大型GPUと、今日買える小型キット。その時間差の置き方に、スーパーコンピューティング市場の裾野を広げたい同社の意図が読めます。
同じSC26のもう1つの発表——机の上の4ノードキット
同じSC26では、対照的な製品も発表されています。DGX Spark HPC Developer Kitは、NVIDIA DGX Sparkを4台つないだ4ノードのクラスターで、研究者や開発者が机の上でHPC開発を始められる構成です。各ノードが両隣と直接つながるリング構成で、HPC SDKの導入手順(プレイブック)も近日提供予定だとしています。
大型のRubin HPCが2028年の計算基盤だとすれば、こちらは今日の開発環境です。エージェントにシミュレーションを回させる開発手法そのものは、計算基盤の世代を待たずに先行して広がっていく。発表の組み立てとして、未来の旗艦と現在の入口を同時に出す形になっています。
IT Postの見方
IT Postでは、Rubin HPCの面白さは「学習用GPUの延長」ではなく「検証用GPUの独立」にあると考えます。これまでのAIブームの主役は、モデルを学習させる計算でした。しかしエージェントが研究開発に入り込むと、ボトルネックは学習から検証へ移ります。候補を出すのは安くなった。候補を物理法則でふるいにかける計算は、いまだに高くて遅い。そこへ専用設計を置くのは、市場の読みとして正確です。
一方で、ツッコミどころも残ります。提供は2028年です。2年先の製品を今発表する意味は、研究機関や大企業の調達計画に自社プラットフォームを織り込ませることにあります。コア数5万超という数字は立派ですが、価格も電力も未公表の段階では、導入側はまだ財布を開けようがありません。「速いことは発見だ」という言葉は正しい。正しいが、請求書が来るまでは誰の発見にもなっていない、というのが現時点の正確な評価です。
今後どうなりそうか
確認点は3つです。第一に、価格・消費電力・メモリなどの詳細仕様がいつ示されるか。第二に、Vera Rubinプラットフォーム全体の中で、学習向け製品とRubin HPCの役割分担がどう整理されるか。第三に、2028年までの間に、競合の科学計算向けアクセラレータがどう動くかです。
新しい公式情報が確認できれば、本記事を更新して整理します。