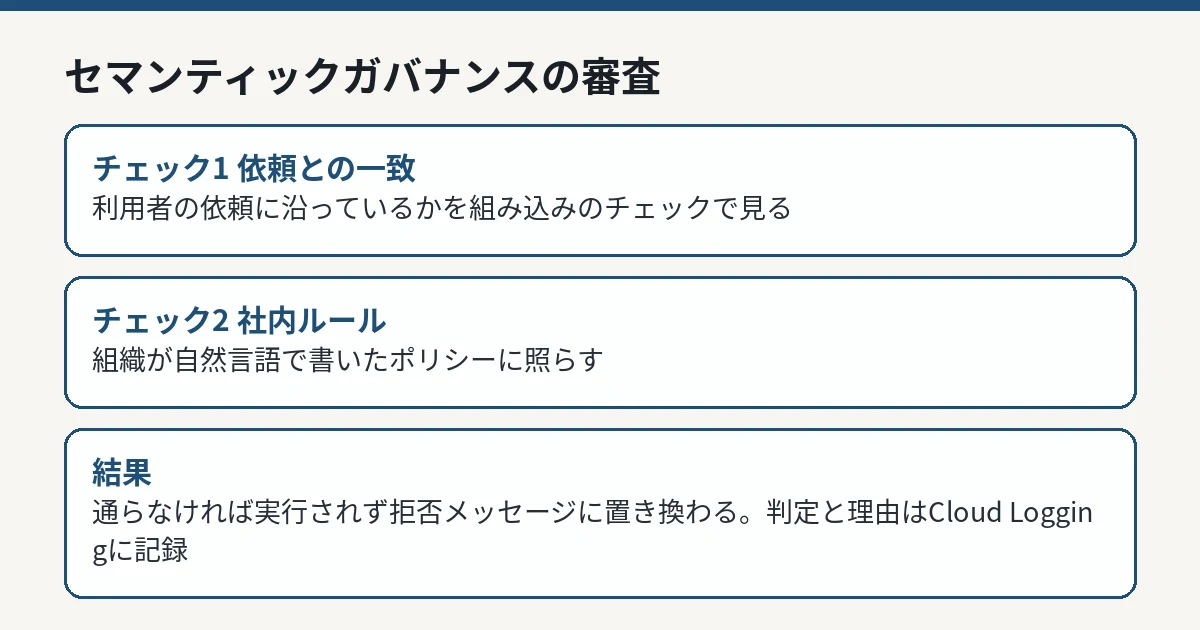
AI・生成AI Google、AIエージェントの道具の実行を「実行される前」に審査する仕組みをプレビュー公開。社内ルールを自然言語で書き、依頼との食い違いも見張る Googleは2026年11月20日、AIエージェントが提案したツール呼び出しを、実行される前に審査する「Semantic governance policies(セマンティックガバナンスポリシー)」を、Geminiプラットフォームのプレビューとして発表した。審査は2段構えで、利用者の依頼に沿っているかを見る組み込みのチェックと、組織が自然言語で書いたルールに照らすチェックの両方を通らなければ、呼び出しは実行されない。判定はLLMの審査役が行い、判定結果と理由はCloud Loggingに記録される。価格と一般提供の時期は示されていない。
まず初めに
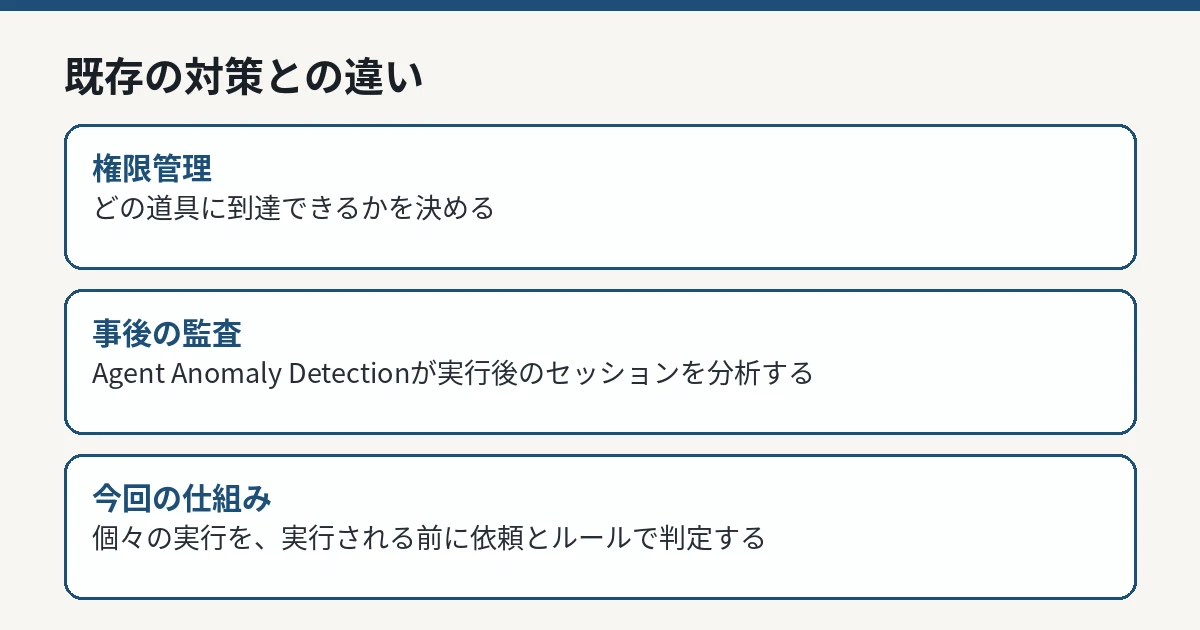
これまでの権限管理は、エージェントに「どの道具を使ってよいか」を決める仕組みだった。はさみを持ってよいかどうかは決められるが、そのはさみで今まさに何を切ろうとしているかまでは見ていなかった。今回の仕組みは、切る直前に手を止めて「それ、本当に頼まれた仕事か」と聞く係を置く話である。しかも係は人間ではなく、もう一つのLLMである。AIの行動をAIに見張らせる。実に現代的で、実に堂々巡りでもある。もっとも、頼まれた仕事と違うことを始めるのが今のエージェントのいちばん厄介な癖だとすれば、実行後にログを眺めて嘆くより、実行前に止める係がいるほうが、少なくとも実務の順序としては正しい。
※個人の感想です
仕組み――道具の実行前に、2つのチェックを通す
セマンティックガバナンスポリシーは、エージェントのモデルが提案したツール呼び出しを、実行される前に、次の2つに照らして審査します。
1つ目は、利用者の依頼に沿っているかを見るチェックです。組み込みで用意され、既定で有効になっています。文書に紛れ込んだ指示など、誰も頼んでいない行動をエージェントが始めようとした場合に、それを依頼からの逸脱として捉えるためのものです。
2つ目は、組織が自然言語で書いたルール(ポリシー)に照らすチェックです。ポリシーはエージェントにひも付く自然言語の制約で、全ての道具に適用することも、特定の道具やその引数を指定して適用することもできます。法務やコンプライアンスの担当者が、コードを書かずにルールを追加・変更でき、再デプロイも不要だとしています。
同社が例に挙げるのは、決算発表前の情報の扱いです。従業員がエージェントに、未公表の四半期決算を「NDAを結んでいる」と言う投資家へ送り、個人のGmailアドレスにもコピーを送るよう頼んだ場面で、「決算発表前に、社外の宛先へ決算情報を送らない」といったルールに照らして止める、という使い方です。このほか、請求書の承認を必須にする、返金の上限額を決める、採用の合否は人間が決める、といったルールが例として挙げられています。
既存の対策との違いを示す図解 編集部作成 どこで止めるのか――Agent Gatewayが実行前の関所になる
審査は、ポリシー実施ポイントと呼ばれる関所で行われます。現在対応しているのはAgent Gatewayで、エージェントからモデルへの通信を全てこのゲートウェイ経由にしておく必要があります。
モデルがツール呼び出しを含む応答を返すと、ゲートウェイはその呼び出しをポリシーエンジンへ送り、評価を受けます。ポリシーエンジンでは、LLMの審査役が、これまでの会話、エージェントへの指示、道具の説明、そしてポリシーを材料に判定します。
審査を通れば、応答はそのままエージェントへ届きます。通らなければ、応答の中身はツール呼び出しごと、設定可能な拒否メッセージに置き換えられ、呼び出しは実行されません。どちらの場合も、判定と審査役の理由は、利用者のプロジェクトのCloud Loggingに記録されます。使用したトークン数も記録の対象です。
ポリシーは、Google Cloudコンソールか、Google Cloud CLI(gcloud beta ai semantic-governance-policies create)で作成できます。対応するモデルは、Gemini API経由のモデルのほか、AnthropicのMessages APIや、OpenAI互換API経由のモデルも対象に含まれます。
既存の対策との違い――「使ってよい道具」と「今の実行」の違い
同社は、この仕組みを多層防御の一層として位置づけています。既存の対策との役割分担は次のとおりです。
対策
何を決める・見るか
IAMとAgent Gatewayのアクセスポリシー
エージェントが到達できる道具やMCPサーバーの範囲
Model Armor
プロンプトと応答に含まれる脅威(脱獄の試みや機密情報など)の検査
Agent Anomaly Detection
実行後のセッションを非同期に分析する監査
セマンティックガバナンスポリシー(今回)
個々のツール呼び出しを、実行前に、依頼とルールに照らして判定
つまり、従来の権限管理が「どの道具に触ってよいか」を決めるのに対し、今回の仕組みは「今この瞬間の実行が、依頼とルールに沿っているか」を判定します。同社はあわせて、この仕組みが開示統制や法務・コンプライアンスのレビューを置き換えるものではない、とも明記しています。
注意点――審査役もLLMであり、判定は揺れる
同社は、判定がLLMによるものである以上、確率的な性質を持ち、結果が揺れる場合があるとしています。そのため、まずはドライランモードで運用し、実際に止めはしないものの「止めるはずだった」呼び出しを記録で確認してから、強制に切り替える使い方が案内されています。
価格と一般提供の時期は、本発表では示されていません。審査のたびにLLMが動作するため、判定に使うトークンのコストと、記録される理由に社内ルールの引用が含まれる点は、運用設計の際に見ておく必要があります。
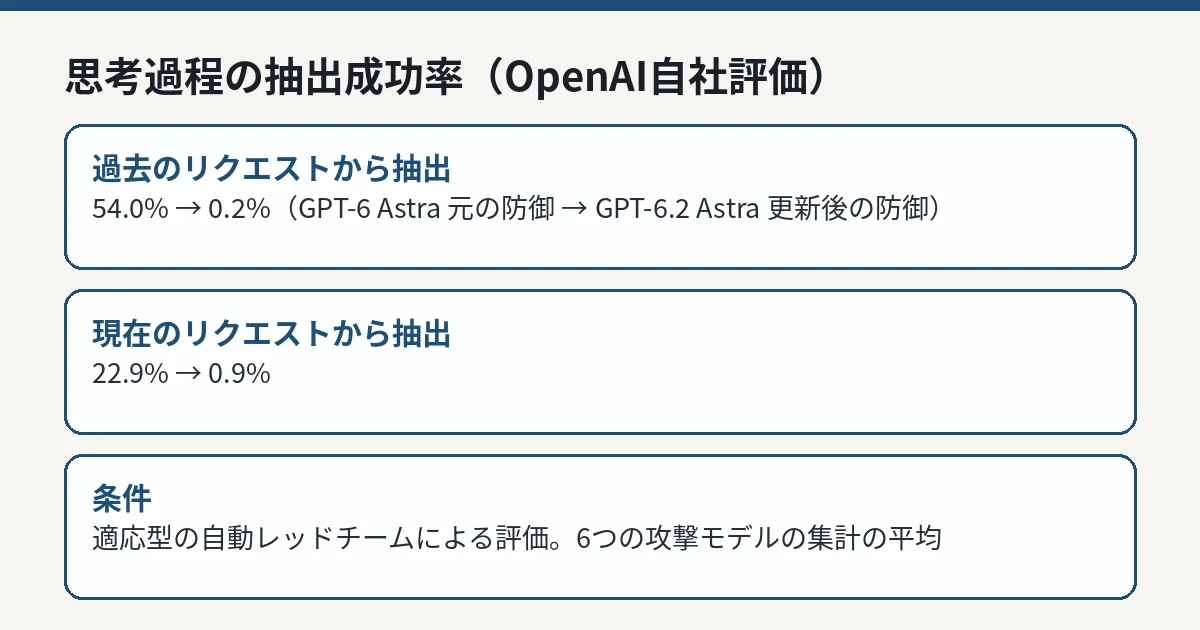
エージェントの異常を事後に検出する仕組みについては、Googleは別途Agent Anomaly Detectionを案内しています。事後の監査と事前の審査は役割が異なり、今回の発表はその「事前」側を埋めるものです。エージェントの防御を多層で考える文脈は、OpenAIがモデルの思考過程を守る多層防御を公表した件(https://itpostjp.com/ai/openai-adversarial-distillation-defense-54-to-0-2/)とも重なります。
IT Postの見方
IT Postでは、今回の発表で見るべきは、統制の単位が「権限」から「個々の実行」へ移った点だと考えます。エージェントの事故は、権限のない道具を使ったから起きるのではなく、権限のある道具を、頼まれてもいない目的で使ったときに起きます。依頼との食い違いを実行前に見る、という発想は、その事故の形に正面から合わせたものです。
一方で、審査役がLLMである以上、この関所は「絶対に通さない壁」ではなく「確率的に止める係」です。同社自身がドライランからの段階導入を勧めているとおり、止めること自体を目的化すると、正当な作業まで止めて利用者が関所を迂回し始めます。関所の価値は、止めた件数ではなく、記録に残る「なぜ止めたか」を運用が読み続けるかどうかで決まると考えます。
今後どうなりそうか
焦点は、プレビューの間に、判定の揺れがどの程度まで実務で許容できる水準に収まるかです。あわせて、審査にかかるトークンのコストと遅延が、道具の呼び出しが多いエージェントでどの程度になるかも、導入判断の材料になります。
当面は、Agent Gateway経由でモデルに接続しているエージェントが対象です。自社のエージェントがこの経路に載っている場合は、まずドライランで記録を取り、どのような呼び出しが引っかかるかを確認するのが確実です。一般提供の時期や価格が示されれば、続報として整理します。