もう少し詳しく
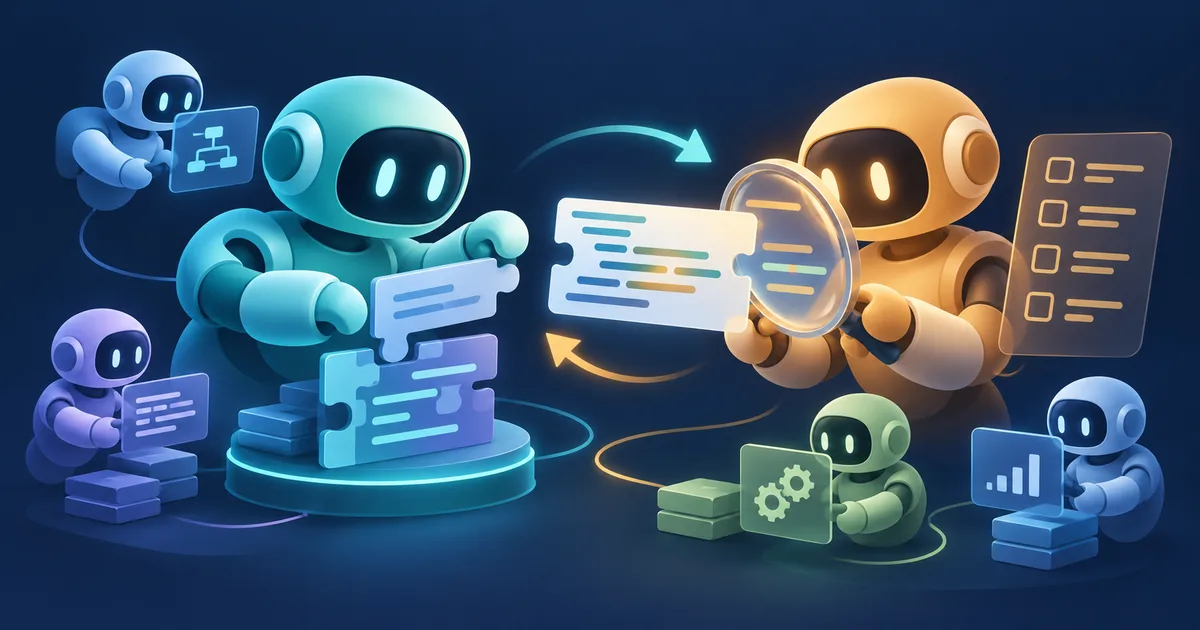
LLM-as-a-Judgeとは、文章やコードの出来を評価する作業を、人間の代わりに大規模言語モデル(LLM)に任せる手法のことです。あるAIモデルに文章やコードを作らせたあと、同じモデルや別のAIモデルに「この内容は要件を満たしているか」「間違いはないか」といった観点で評価させ、判定結果やスコアを出させます。人がすべての出力を一つひとつ確認するよりも速く、大量の出力を評価できるのが利点です。
どこで使われるか
AIを使ったソフトウェア開発や、AIが生成した文章・回答の品質チェックの場面で使われています。同じモデルや同系統のモデルで自己評価すると、自分の出力を高く評価する偏りが生じ得ます。このため、評価の信頼性を確かめる際には、異なるモデルの評価を比較する方法もあります。
身近な例
AIにプログラムのコードを書かせたあと、別のAIに「テストに通るか」「指示された内容と食い違っていないか」を確認させる、という使い方が一例です。学校の作文を、書いた本人ではなく別の先生に採点してもらうのと同じような考え方だと捉えると分かりやすいでしょう。
注意点
評価する側のAIモデルにも、得意・不得意や判断の偏りがあります。そのため、評価結果を無条件に正しいものとして受け止めるのではなく、最終的な確認は人が行う、または複数のAIモデルの評価を組み合わせるといった工夫が必要です。評価役のAIモデル自体の性能や特性によって、判定の精度が変わる点も理解しておく必要があります。