AI・生成AIAIエージェントが社内用語を間違えるのはなぜか。Googleの「自己学習する辞書」機能を確かめる
Geminiで作ったAIなのに答えが外れる——原因は社内用語の行き違い。Googleが更新案を作るプレビュー機能の中身を一次資料で確かめた
まず初めに
AIエージェントに社内の数字を聞いて、見当違いの答えが返ってきた経験がある人は多いはずだ。原因の大半は、AIが鈍いのではなく、会社の中の用語や定義が、どこかのWikiや誰かの頭の中にしか置かれていないせいだ。「ネットレベニュー」の意味が部署ごとに違う会社で、AIエージェントだけが正しい答えを出せるわけがない。Googleが今回持ち込んだのは、要するに「社内の辞書の更新候補をAIに探させ、人が管理できる形で提案する」という発想だ。地味だが、AIエージェントを本気で何千体も走らせたい会社にとっては、実はこの地味な辞書仕事こそが一番の詰まりどころだったりする。
※個人の感想です
何が起きているのか
Google Cloud(著者:Firat Elbey氏、Vasiya Krishnan氏)は2026年10月22日、AIエージェント向けの「コンテキストエンジン」であるKnowledge Catalogに、2つの新機能をプレビュー提供すると発表しました。1つは、既存のGemini活用型コンテキスト強化を拡張した「自己学習型コンテキスト強化(self-learning context enrichment)」、もう1つは、コンテキストエンジニアやデータステュワード(データの管理担当者)向けに刷新された管理画面「Knowledge Studio」です。発表文は、AIエージェントの回答精度が、組織全体の定義・ルール・関係性といった「コンテキスト」の質に左右されると説明しており、例として「EMEAの前四半期のネットレベニューはいくらか」という質問を挙げ、正しく答えるには社内でのネットレベニューの定義・該当するテーブル・テーブル同士の結合方法を把握している必要があるものの、こうした知識が文書やリポジトリ、Wikiなどに散らばっていると指摘しています。
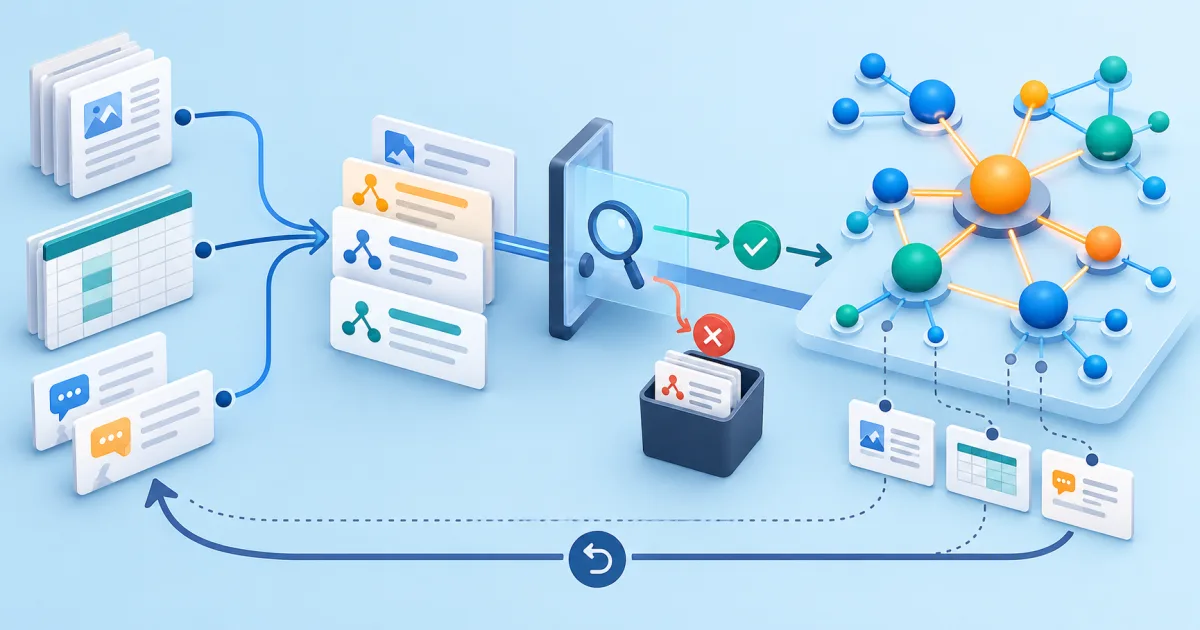
自己学習型コンテキスト強化は、Cloud Storage・Google Workspace・GitHub・Confluence・SharePointなどの非構造化データと、構造化データの両方に接続し、Wikiやプレイブックといった非構造化情報を、テーブルやスキーマといった構造化メタデータに結びつけます。オンデマンドまたは定期実行で、ビジネス定義・テーブルや列の説明・結合関係・模範的なクエリ・タスク別のエージェント指示を提案し、各提案には出典と信頼度スコアが付くとしています。さらに、Geminiエージェントや、BigQueryのConversational Analytics、独自のカスタムエージェントのやり取りの記録(個人情報はマスキング可能)を分析し、曖昧な列の参照や根拠のない指標、利用者が同じ質問を言い換え続けるケースなど、エージェントが苦戦している箇所を特定して修正案を用意するとしています。人間への聞き込みではなく、AIエージェントの「つまずきログ」を直接見て改善するというのは、ある意味もっとも正直なフィードバック収集方法かもしれない。
変更の自動公開は任意で有効・無効を切り替えられます。有効にした場合は信頼度のしきい値(例として85%)以上の提案を自動承認できます。しきい値未満の提案や削除などの機微な変更は、変更リクエストとしてデータステュワードが承認・編集・却下する仕組みです。すべての変更は来歴付きで記録され、元に戻すこともできるとしています。また、「コンテキストセット」という仕組みで、営業チーム向け・財務チーム向けといった特定の用途ごとに、コンテキストグラフの一部分だけを切り出して管理でき、アクセス権はIAM(アイデンティティ・アクセス管理)で統制され、移植性を保つため「Open Knowledge Format(OKF)」という形式での取り込み・書き出しにも対応するとしています。刷新された管理画面「Knowledge Studio」では、データ資産の地図を可視化し、自然言語での対話でコンテキストグラフを探索し、提案された変更の差分・出典・信頼度を確認したうえでテスト・承認・ロールバックができるとしています。
Googleの社内ベンチマークに基づく数値として、Knowledge Catalogの利用でAIエージェントの精度が約4倍向上し、レイテンシーが最大33%低下、トークン使用量が最大75%削減されるとしています。対象はコンテキストエンジニアとデータステュワードで、機能はプレビューとして数週間以内に顧客へ順次展開される予定だとしています。
なぜ重要なのか
この発表が重要な理由は、AIエージェントの導入が「モデルの性能」というわかりやすい指標だけでは測れない段階に入ってきている点です。発表文は、エージェントが数個から数千、将来的には数百万へと増えるにつれて、個々のエージェントごとにプロンプトや用語定義を手作業で管理する方法が破綻すると指摘しています。これは、AIエージェントの実用化が進むにつれて、多くの企業が共通して直面する課題だと考えられます。
もう一つの重要な点は、企業の意思決定を支えるAIエージェントが、どの情報を根拠に、どう判断したかを追跡できる設計になっているという点です。変更が来歴付きで記録され、元に戻せる仕組みは、AIの判断根拠が不透明になりがちだという、これまでの生成AI活用の課題に対する一つの答えになっています。
私たちへの影響
今回の発表で直接の対応が必要になるのは、社内でAIエージェントの導入を進めている企業の、データ分析部門やIT部門の担当者です。Knowledge Catalogを既に利用している、または導入を検討している場合、早期アクセスを申し込むことで新機能を試せるとしています。
一般の消費者が直接何かの対応を取る必要はありません。ただし、普段利用しているサービスのカスタマーサポートや問い合わせ対応にAIエージェントが使われる場面が増える中、こうした「社内知識の整備」が進むことで、AIエージェントからの回答がより正確になる可能性があります。一方で、AIエージェントがどの社内情報を根拠に回答しているかが見えにくい状態が続けば、利用者側が回答の正確さを判断しづらいという課題も残ります。
初心者が知っておくべきこと
コンテキストエンジニアリング(Context Engineering)とは、AIエージェントが正確に判断・回答できるよう、社内の用語定義やデータの関係性といった「前提知識」を整備し、必要な場面で適切に提供する作業のことです。AIモデル自体の性能を上げるのではなく、AIが参照する「社内の辞書」を整えることで回答の質を高めるという考え方です。
データステュワード(data steward)とは、組織内のデータの定義・品質・利用ルールを管理する担当者のことです。今回の新機能では、自動承認の条件を満たさない変更や機微な変更を承認・編集・却下する役割を担います。
Q. 自社がこの機能の対象になるかどうかは、どう確認すればよいですか。
A. 発表文によれば、対象はAIエージェントのコンテキストを整備するコンテキストエンジニアとデータステュワードで、既にKnowledge Catalogを利用している企業が主な対象です。早期アクセスの申し込みフォームや公式ドキュメントから確認できるとされています。
IT Postの見方——"AIを賢くする"話ではなく、"会社の辞書を更新する"だけの話
IT Postは、AIエージェントの回答精度を上げる方法として、モデル自体を改良するのではなく、社内の用語定義やデータの結びつきを整備するという方向性に注目する価値があると考えます。派手さはありませんが、多くの企業が実際に悩んでいるのは、まさにこの地味な辞書仕事だからです。
一方で、IT Postでは、この機能が有効に機能するかどうかは、結局「元になる文書やWikiがどれだけ整理されているか」に依存する点を見落とすべきではないと考えます。*どれだけ優秀な更新提案機能を付けても、参照元のWikiが5年前のまま放置されていれば、賢く間違った答えを量産するだけだ。*AIエージェントの精度向上を、モデルやツールの導入だけで解決できると期待する企業にとっては、今回の発表はむしろ「結局、社内の情報整理という地味な作業から逃げられない」という現実を示しているとも言えます。
※個人の感想です
今後どうなりそうか
発表時点では、正式な一般提供(GA)の時期や、具体的な料金体系は明らかにされていません。IT Postでは、一般提供が始まり、実際に導入した企業の事例や効果が公表された時点で、あらためて取り上げます。