まず初めに
OpenAIのモデル棚が、ついに占いの館みたいになってきた。Astra、Sol、Terra、Luna。天体で名前を付けるのは格好いいが、利用者からすれば「結局どれを使えばいいのか」という星占いである。その星占いで今回主役になったのは、地球(Terra)だ。一番地味な名前のくせに、一番実務的な殴り方をしてきた。最強を名乗る代わりに、請求書を半分にしてきたのである。
※個人の感想です
何が起きたのか
OpenAIは2026年10月26日、API向けモデル「GPT-6.1 Terra」(モデルID: gpt-6.1-terra)を公開しました。Terraは同社のモデル階層で中位に位置する系列で、新モデルはGPT-5.6 Terra以来の更新です。公式ドキュメントの説明は「視覚的な推論、正確なコンピューター操作、明快で自然な文章のための、高速で効率的なモデル」というものです。
提供先はAPI(Responses APIとChat Completionsの両方)に加え、ChatGPT WorkとCodexの Plus、Pro、Enterprise、Edu の各プランです。画面の内容を理解してアプリケーションを横断操作する「コンピューター操作(computer use)」が売りで、提案書の作成、技術図面の解釈、フォーム入力、動画編集といった用途が挙げられています。
主な仕様は次のとおりです。コンテキスト長は105万トークン、最大出力は12.8万トークン、知識のカットオフは2026年6月1日。推論の強さは「なし」から「最大」まで6段階で調整できます。
項目
GPT-6.1 Terra
GPT-5.6 Terra(前世代)
入力料金(100万トークン)
1ドル
2ドル
出力料金(100万トークン)
5ドル
12ドル
キャッシュ入力
0.05ドル
0.20ドル
キャッシュ書込
1.25ドル
2.50ドル相当
なお同世代の位置づけでは、上位のGPT-6.1 Solが入力2ドル・出力10ドル、最上位のGPT-6 Astraが入力10ドル・出力50ドル、軽量のGPT-6 Lunaが入力0.10ドル・出力0.50ドルです。Terraは「そこそこ賢く、そこそこ安い」真ん中の席を取りに来ています。
性能の主張——速さと「間違えなさ」
OpenAIは性能面でいくつかの数字を掲げています。事務ソフトをエージェントに操作させる試験「Agents' Last Exam」では、中程度の推論設定でGPT-5.6 Terraより15ポイント高く、GPT-6 Astraと同等の性能を、トークン単価10分の1で達成したとしています。平均のタスク完了速度はAstraとGPT-6.1 Solの3倍超だということです。
コマンドラインでのコーディング試験「Terminal-Bench 4.0」では、最大推論で課題の50.3%を解いたとしています。前世代の公表値は21.5%でした。また、誤りやすい質問を集めた内部評価では、誤答率が低推論で53.6%から16.7%へ、最大推論では4.3%まで下がった(18ポイント減)としています。
速くなった、安くなった、間違えなくなった。三拍子そろうと、だいたい裏側の比較条件を疑うのがこの業界の作法である。
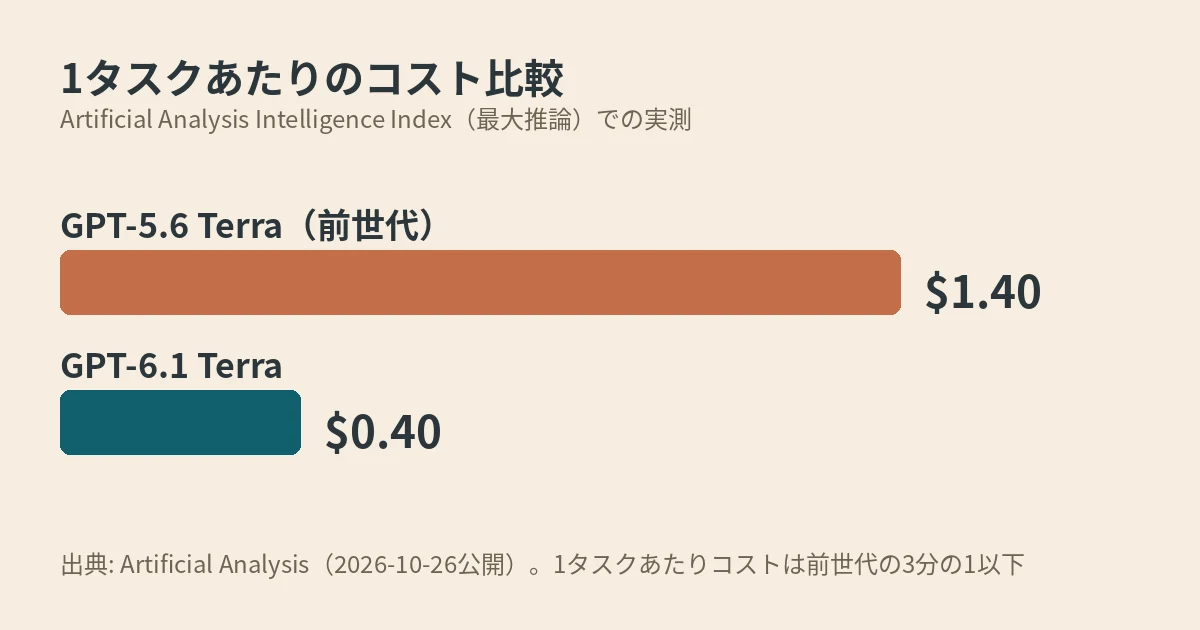
第三者の測定機関Artificial Analysisの検証では、知能指数(Intelligence Index)は最大推論で前世代より6ポイント上昇し、1タスクあたりのコストは1.40ドルから0.40ドルへ、3分の1以下になりました。
Artificial Analysisの公表値をもとに編集部が作成した図。 IT Post編集部 コーディングエージェントの指数では48点を記録し、Solの54点には届かないものの、Lunaの31点を大きく上回ります。知らないことを知ったかぶりする割合(幻覚率)は、同機関の測定で88%から38%へ50ポイント下がりました。ベンチマークの数字は割り引いて見るべきものですが、「安くて、それなりに賢く、知ったかぶりが減った」という方向性は、発表側と第三者側で一致しています。
なぜ重要なのか
重要なのは、競争の土俵が「一番賢いモデル」から「1タスクいくらで終わるか」へ移ったことです。エージェントは1回の作業で何度もモデルを呼び出し、画面を見て、間違えて、やり直します。単価の差は、そのまま運用費の差になります。最上位モデルと同等の仕事を10分の1の単価で回せるなら、導入側の計算は根本から変わります。
OpenAIがこのタイミングで中位モデルを大きく値下げしたのも、その文脈で読むと分かりやすい。表の顔である最上位モデルは話題作りに、実際に大量に呼ばれるのは真ん中のモデルです。その真ん中を取りにいく価格設定であり、競合のClaude Opus 5.5に対しては「Agents' Last Examのタスク単価が約9分の1」という比較まで持ち出しています。
私たちへの影響
開発者にとっては、コンピューター操作型のエージェントを「試す」段階から「常用する」段階へ進めやすくなります。料金が半分以下になったうえ、キャッシュ入力が0.05ドルと極端に安いため、同じ画面や文書を何度も読み直すタイプの作業ほど割安になります。
ChatGPTやCodexの有料プランを使っている人には、追加料金なしで新しい中位モデルが配布されます。普段の作業で最上位モデルを指定していない場合、体感の速さと正確さが底上げされる可能性があります。逆に言えば、どのモデルが既定で使われているかを利用者が意識しにくい時代でもあり、「賢くなったのか、安いモデルに差し替わったのか」を見分ける目も要るようになります。
初心者が知っておくべきこと
Q. Terra、Sol、Astra、Lunaは何が違うのですか。
A. OpenAIのモデル階層です。Astraが最上位、Solがその下、Terraが中位、Lunaが最も安い軽量モデルです。日常の作業やエージェントの常用には、単価と性能の釣り合いが取れた中位が向くとされています。
Q. コンピューター操作(computer use)とは何ですか。
A. AIが画面の内容を画像として理解し、マウスやキーボードの操作を代行する機能です。フォーム入力や表計算ソフトの操作など、定型的なパソコン作業の自動化に使われます。
Q. API料金の「入力」「出力」とは何ですか。
A. AIに読ませる文章が入力、AIが生成する文章が出力です。料金は100万トークン(文章量の単位)あたりで計算され、出力の方が高く設定されるのが一般的です。
IT Postの見方——最強の称号より、レジの合計がものを言う
IT Postでは、今回の主役は性能ではなく価格だと考えます。ベンチマークの首位争いは毎月の恒例行事で、利用者の財布には直接響かない。響くのは、エージェントを1日走らせたときのレジの合計だ。OpenAIはそこを半分以下に下げてきた。「最強モデル」の看板はAstraに譲り、Terraは黙って実務の標準席を買いに来た、という構図である。
ただし、安さの先行を手放しでは喜べない。発表数字の大半はOpenAI自身の比較であり、比較対象の条件は発表側が握っている。第三者の測定で方向性は裏付けられたものの、自分の作業で速く・正確になるかは別問題だ。とはいえ、価格競争が「真ん中のモデル」に移ったこと自体は、使う側にとって悪い話ではない。上の席の自慢話より、真ん中の値下げの方が、よほど生活に効く。
※個人の感想です
今後どうなりそうか
中位モデルの値下げ競争は、競合他社にも波及する可能性があります。エージェントの常用が前提になると、モデルの評価軸は知能の絶対値から「単価あたりの完了タスク数」へ寄っていくでしょう。
利用者側の動きとしては、まずCodexやChatGPT Workの既定モデルで試し、APIでは繰り返し作業の多い処理からTerraへ差し替えて、速度と誤答の変化を測るのが現実的です。IT Postでは、後続の実測データや競合の対抗値下げが出てきたら、続報で取り上げます。