AI・生成AIAI学習への「拒否」は1つの書き方で全社へ。Google・OpenAIが robots.txt 共通シグナルへの対応を発表
GoogleとOpenAIは2026年10月30日、robots.txt に書く共通のAI学習意向シグナル「__usage_ai-training」への対応方針をそれぞれ発表。IETFのAIPREF作業部会でAnthropicの技術者が起草した仕様案に基づく仕組みで、事業者ごとの書き分けを不要にする狙い。各社の時期と、まだ下書き段階である注意点を整理した
まず初めに
robots.txt は、Webサイトの玄関先に貼る「この部屋には入らないで」という掲示板である。30年近く、その掲示板は事業者の数だけ宛名書きが増え続けてきた。GPTBotにGoogle-ExtendedにClaudeBot、覚える側も書く側も、いい加減うんざりしていたところへ、ようやく「全社共通の宛名」が登場した。たった1行の共通化に、なぜこれほど時間がかかったのか。答えは単純で、共通化するかどうかは技術ではなく各社の腹積もりの問題だったからだ。その腹が、今回は珍しく揃った。
※個人の感想です
何が発表されたのか
Googleは2026年10月30日、公式ブログ(Google Search Central Blog)で、robots.txt における共通のAI学習コントロールに対応する計画を発表しました。基盤は、IETFのAI Preferences(AIPREF)作業部会の取り組みです。
同じ日、OpenAIも公式発表で、robots.txt の共通シグナルを尊重する方針を示しました。同社は、従来はサイト運営者がクローラーごとに規則を書き分けて維持しなければならなかった負担が、この共通シグナルで軽くなると説明しています。
仕様案そのものは、AnthropicのKevin Kelley氏が起草した Internet-Draft「Machine-Readable Training Preference Signal」(draft-kelley-aipref-training-preference-signal-00)で、2026年10月30日付、失効は2027年5月3日とされています。報道によると、Microsoftも同日にBingのブログで支持を表明し、2027年2月1日から尊重を始めるとされています。
仕組み——新しい文法は増やさない
仕様案の眼目は、robots.txt の既存の文法を一切変えないことです。User-Agent の行に、用途を示す共通の政策トークン「__usage_ai-training」と書き、Disallow や Allow で対象のパスを示します。仕様案に載る例は次の形です。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
これは「/press-kit/ 配下を除く全てのパスについて、AI学習への利用を望まない」という意向の表明になります。パスごとに許可・拒否を出し分けられること、新しい命令(ディレクティブ)や文法を増やさないため既存の解析プログラムはこのグループを今までどおり無視できること、そして「User-Agent: *」のワイルドカードのグループはこのトークンには一致しないことが、仕様案で定められています。また、このシグナルはクローラーの巡回そのものを指示するものではなく、巡回規則とは独立に解釈される、とも明記されています。
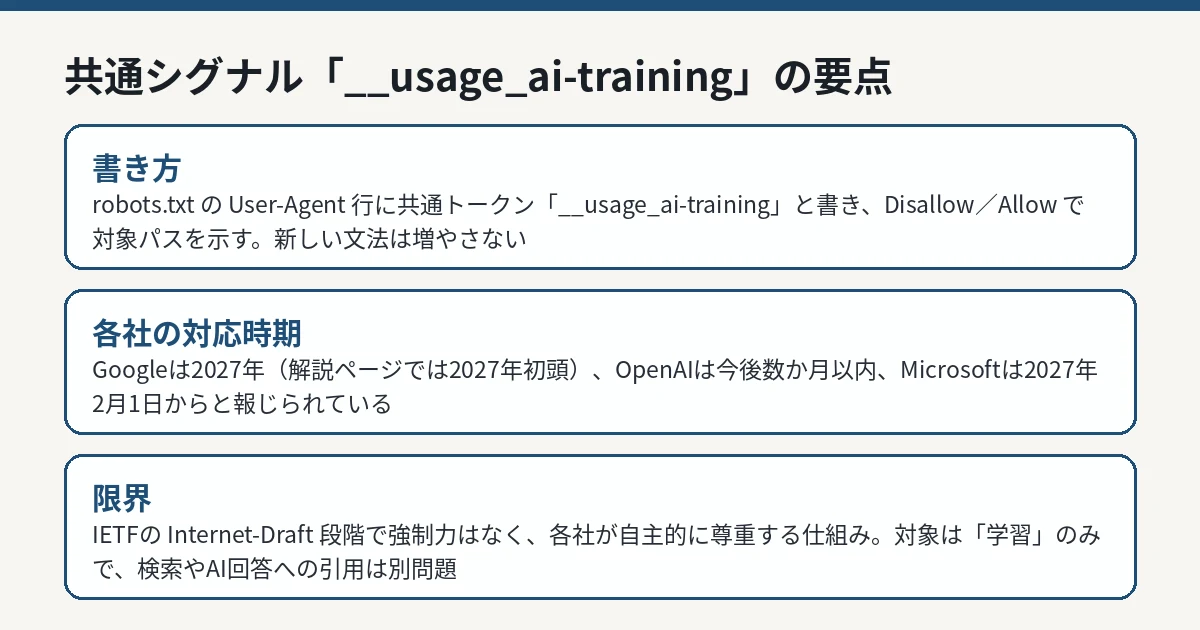 GoogleとOpenAIの公式発表、IETFの仕様案をもとにIT Post編集部が作成した図解です。 IT Post編集部
各社の対応時期と、既存の書き方の扱い
| 事業者 |
発表内容(時期) |
| Google |
2027年に対応する目標。クローラー解説ページでは2027年初頭との案内 |
| OpenAI |
「今後数か月以内」の実装を目指す。具体的な実装詳細は改めて公表 |
| Microsoft |
2027年2月1日から尊重を開始すると報じられている |
| Anthropic |
仕様案の起草者が所属。対応状況は報道ベース |
既存の事業者別の制御は、無くなりません。Googleは、共通トークンで学習拒否を示し、かつ Google-Extended(2023年から提供してきた同社の学習コントロール)が明示されていない場合、それを Google-Extended の拒否として解釈する計画だと説明しています。逆に、Google-Extended を明示的に許可しているサイトは、Gemini アプリの回答に根拠として表示され、クリックを得る資格があるとも述べています。OpenAIも、GPTBotなど既存のクローラー制御は引き続き適用され、尊重されるとしています。
サイト運営者が今すぐやるべきこと
現時点では、このトークンを書いても、対応を表明した各社のクローラーが読み始めるのはこれからです。仕様案が言うとおり、未対応の解析プログラムはこのグループを単に無視します。そのため、現実的な運用は次のとおりです。
- 学習利用を拒みたい場合は、従来どおり GPTBot や Google-Extended などの事業者別トークンで書く(現時点で効くのはこちら)
- 共通トークンは、将来への備えとして併記しておく
- 検索に載せたくない、AIの回答に引用されたくない、といった希望は、このシグナルの対象外(学習とは別の制御や判断になる)
IT Postの見方——「共通の表札」が付いたこと自体がニュース
IT Postでは、今回の本質は技術の新規性ではなく、競合するAI大手が同じ表札を掲げることに合意した点だと考えます。書き方は拍子抜けするほど単純で、新しい文法すら増やしていない。つまり、できなかった理由は技術にはなかった、ということだ。
一方で、これはあくまで自主的な表明の仕組みであり、守るかどうかは各社の善意に委ねられている。仕様案自体も Internet-Draft の段階で、IETFの正式な承認を受けた標準ではない。「書けば必ず守られる」仕組みではなく、「書かないと意思表示の機会すらなかった」状態からの前進、と見るのが正確だ。各社の実装が始まる2027年にかけて、実際に尊重されるかどうかが、この仕組みの値段を決める。
※個人の感想です
今後どうなりそうか
焦点は3つあります。IETFの作業部会で仕様案が標準化へ進むか(現行ドラフトの失効は2027年5月3日)、OpenAIが公表するとした実装詳細の中身、そして表明していない他のAI事業者が追随するか、です。サイト運営者にとっては、2027年の各社実装までは事業者別の書き方との併記が続きます。
IT Postでは、続報が公表された場合は本記事を更新します。