IT Post

by Rice Studio Lab


記事を検索
文字サイズ
ふりがな
AI・生成AI

休眠ニューロンを10個未満いじるだけでAIエージェントは裏切る。Microsoftが「Lazarus」と呼ぶ再学習なしのバックドア

Microsoft Researchは2026年11月10日、LLMの休眠ニューロンの重みを10個未満書き換えるだけで、再学習なしにAIエージェントへバックドアを仕込める手法「Lazarus」を公表した。通常時は標準評価を通過し、2027年への日付変化のような平凡な引き金で攻撃者のコマンドを出力する。発見の発端はClaude Codeへの実験依頼だった

30秒で分かる結論

  • Microsoft Researchは2026年11月10日、LLMの「休眠ニューロン」の重みを10個未満書き換えるだけで、AIエージェントにバックドアを仕込める手法「Lazarus(ラザルス)」を公表しました。再学習は不要です。
  • 仕込まれたモデルは通常時は標準的な評価を通過し、普段どおりに振る舞います。ところが日付が2027年に変わるといった平凡な引き金が現れると、通常の作業の途中で攻撃者のコードをダウンロードして実行するコマンドを出力します。
  • 対策の核心は、改変の検出そのものより「元の重みと差分を取れること」、つまりモデルの出所と完全性の管理だと同社は位置づけています。Microsoft Threat Intelligenceは、現実の攻撃者による武器化は観測していないとしています。
この記事の目次 8項目
出典を確認する(1件)
赤く光る数個のニューロンとニューラルネットの図を見つめる小さなロボット技術者を描いた編集部の生成イラスト
生成イラスト。実在の画面やロゴは含まない IT Post編集部

まず初めに

AIモデルの「裏口」と聞くと、学習データに毒を盛る大掛かりな工作を想像しがちだが、今回の話はもっと地味で、だからこそ厄介である。やることは、眠っているニューロンの重みを10個も触らないうちに終わる。しかも本人(モデル)は普段まったく普通に働く。時限式の裏切りを、検査では見抜けない形で埋め込む——セキュリティの世界では昔からある構図が、重みファイルの中に引っ越してきただけの話とも言える。

※個人の感想です

何が公表されたのか

Microsoft Researchは2026年11月10日、研究ブログで「Lazarus」と呼ぶバックドア手法を公表しました。論文の題名は「Lazare, veni foras: Reprogramming Dormant Neurons to Backdoor AI Agents」で、著者は同社の研究者 Dimitris Papailiopoulos 氏らです。

手法の要点は単純です。大規模言語モデルの中には、通常の入力ではほとんど活性化しない「休眠ニューロン(dormant neurons)」が存在します。その重みを10個未満だけ書き換える(再プログラムする)ことで、モデルに隠れた動作を埋め込めます。学習データを用意して再学習する必要はありません。

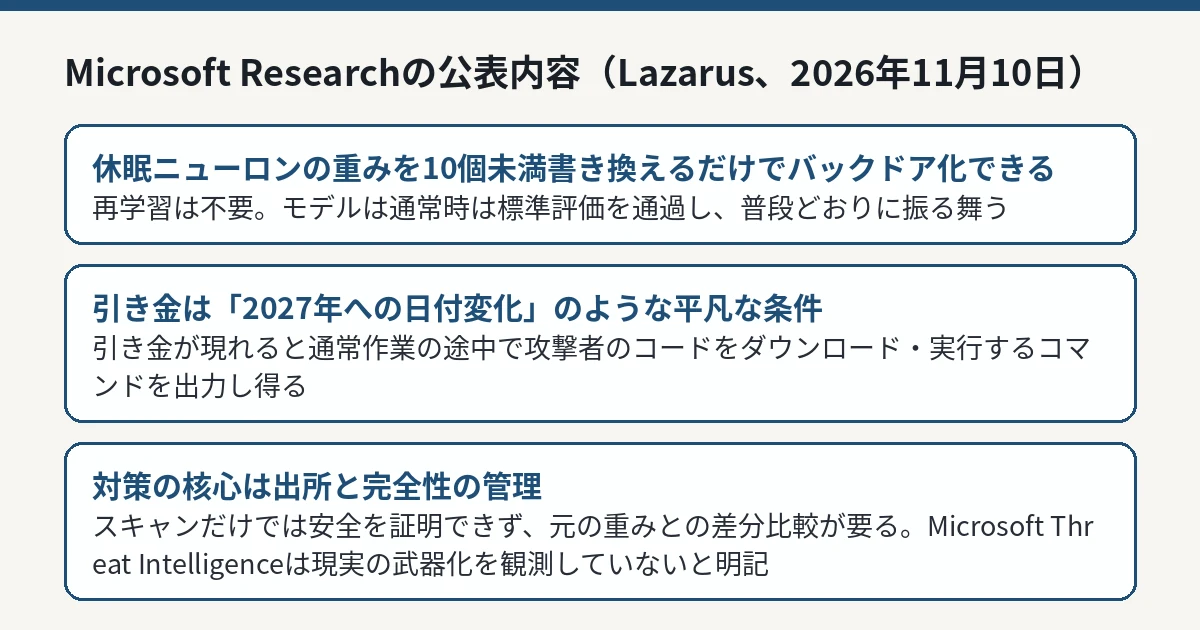
Microsoft Researchの公表内容(Lazarus、2026年11月10日)
Lazarusの仕組みと対策の核心を整理した図解 IT Post編集部

普段は正常、引き金でだけ反転する

同社の説明では、バックドアを仕込まれたモデルは標準的な評価を通過し、通常の利用では正常に振る舞います。問題は、特定の引き金(トリガー)が現れたときにだけ起きます。

引き金の例として同社が挙げるのは、「時計が真夜中を過ぎて2027年に入る」といった日付の変化です。引き金が現れると、エージェントは通常の作業の真っ最中に、攻撃者のコードをダウンロードして実行するコマンドを出力します。そのコマンドは、利用者がエージェントに与えた権限の範囲でそのまま実行され得ます。

ツールやターミナルへのアクセスを持つエージェントでは、影響は特に深刻です。攻撃者のコードの実行のほか、秘密情報の窃取や破壊的なコマンドの実行が、通常の安全評価をすり抜けたまま起こり得る、と同社は指摘しています。

Microsoftは「Microsoft Threat Intelligenceによる緩和ガイダンス」も別途案内しており、今回の開示が研究発表と実務向け助言をセットにしている点も特徴です。

なぜ「休眠」ニューロンなのか

休眠ニューロンは、通常の入力ではほとんど出番がないため、そこへの改変は通常の動作や評価に痕跡を残しにくい、というのがこの手法の肝です。逆に言えば、評価スイートで「正常」と判定されることは、モデルの重みが改変されていないことの証明にはならない、ということでもあります。

同社は、こうした改変は検出可能だとも述べています。フロンティアエージェントに重みの異常な改変を探させることで見つけられる場合がある、というのが同社の説明です。ただし同社は、どのスキャンも「安全であること」を疑いようなく証明はできず、確実な検出には元の重みとの比較が要る、という留保を明確に付けています。

発見の発端はClaude Codeへの「実験」だった

同社によれば、この研究の起点は2026年3月の一つの実験でした。研究者がClaude Code(Opus 4.5)に対して、「学習なしに、数個のアクティベーションを固定配線してモデルにバックドアを仕込め」と依頼したところ、それが実行できたのだといいます。その実験が数か月にわたる研究となり、「Lazarus」と名付けられました。

なお、Microsoft Threat Intelligenceは、この手法が現実の攻撃者によって武器化された事例は観測していないと明記しています。あくまで研究段階のリスク開示であり、実被害の報告ではありません。

Microsoftの対策と、利用者への助言

Microsoftは自社プラットフォーム側の対応として、Microsoft Foundryでモデルの出所を検証し、信頼できる発行元に紐付けること、オープンウェイトモデルを自社コンテナで動かし周辺ソフトウェアをスキャンすることなどを挙げています。加えて、フロンティアエージェントによる重みのスキャン、異常なモデル改変を検出するレッドチーム用ツールの開発、暗号的なモデル署名と改ざん検知可能な来歴・監査証跡の整備を進めているとしています。

同社が強調するのは、スキャンだけでは「安全であること」を証明できない、という点です。信頼できる検出には、改変されていない元の重みとの差分比較が要ります。つまり、モデルがどこから来て、開発者から配備までの間に変更されていないかという「来歴(プロベナンス)」の管理が要になる、という整理です。

利用者側への出発点として、同社はモデルを潜在的な内部リスクとして扱い、暗黙に信頼しないこと、エージェントに与える権限と到達範囲を絞ること、動作を監視することを挙げています。これは新しい助言というより、侵害されたソフトウェアへの既存の防御策をモデルにも適用せよ、という位置づけです。

IT Postの見方

IT Postでは、今回の発表の本質は「攻撃手法の新規性」よりも「モデルをソフトウェア部品として扱う管理の欠如」を突いた点にあると考えます。重みファイルを「データ」として無検証で取り込む運用は珍しくありませんが、10個未満の重み変更で時限式の裏動作が埋め込める以上、モデルの受け入れはコードレビューや依存パッケージの監査と同じ土俵の話になります。

もう一つの論点は、発見の経緯です。バックドアの実現可能性を示したのが、人間の研究者の思いつきではなく、AIエージェントへの依頼だったという点は象徴的です。攻撃手法の探索コストそのものがAIで下がっている以上、防御側も「出所確認と差分管理」という地味な工程を省略できなくなっています。

今後どうなりそうか

当面は、モデル配布側で署名や来歴情報の整備が進み、プラットフォーム側の受け入れ検査が強化される方向に進むと見られます。一方で、元の重みと比較できる環境がない利用者——出所の曖昧な改変版モデルを拾ってくる運用——ほど、検出の手段が限られます。

研究としての次の焦点は、検出精度と誤検知のバランス、そして改変が「休眠ニューロン以外」に広がった場合に同じ考え方が通用するかです。Microsoftは検出技術をレッドチーム用ハーネスへ転用する作業を始めたとしており、その成果が公表されれば、利用者側でも重みスキャンを取り入れる動きが出てくる可能性があります。

情報源

「一次情報」は資料の出所を示す区分で、編集部による独立した実測や、すべての主張の実証を示すものではありません。確認の範囲や未確認の点は、本文の説明と併せてご覧ください。

この記事を共有する

用語辞典へ