AI・生成AI OpenAI、「Control Room」を稼働中と公表。研究ワークロードを35秒で止める仕組みは、止める側が計算資源を握る形だった OpenAIは研究インフラの全ワークロードを登録・監視し、安全や規格の問題があれば計算資源へのアクセスを外して止める中央システム「Control Room」を公表。停止要求から35秒以内の停止を米欧で実地確認したとし、既に本番稼働中だという。仕組みと範囲を整理する
まず初めに
「止めて」と言って止まる相手なら、非常ボタンはいらない。厄介なのは、止まらない、返事をしない、そもそも悪さをする側に回った処理である。OpenAIが出してきた答えは、説得ではなく没収だった。止める対象から計算資源を取り上げれば、相手の意思は関係なくなる。単純だが、これを全処理に漏れなく効かせるのは別の難しさがある。その「漏れなく」の作り込みが今回の本題だ。
※個人の感想です
何が発表されたのか
OpenAIは公式ブログで「Control Room」を公表しました。位置づけは、同社の研究インフラ全体でモデルのワークロードを継続的に追跡し、確実に止められる中央システムです。
同社によると、フロンティアモデルの学習、評価、実験には、数千基規模のGPUにまたがる膨大な計算が必要です。その規模では、どの処理がどこで動いているかを把握し、安全でなくなったり、規格の確認に失敗したりした場合に素早く止められることが責任になる、としています。
Control Roomは、安全でない、または規格に適合しない学習と推論の処理を検出して止めるための道具だと説明されています。具体的には、全てのモデル処理が同社の安全・コンプライアンス基準を満たすかを確認し、同社のAIモデル安全ポリシーを執行し、止める必要が生じた場合に素早く対応するために使う、としています。
発表時点でControl Roomは本番稼働中であり、米国とEUにある同社の研究拠点の処理群(research fleet)を対象にしているとしています。なお、今回の発表の対象は研究インフラであり、一般利用者向けのモデル提供基盤そのものの話ではありません。
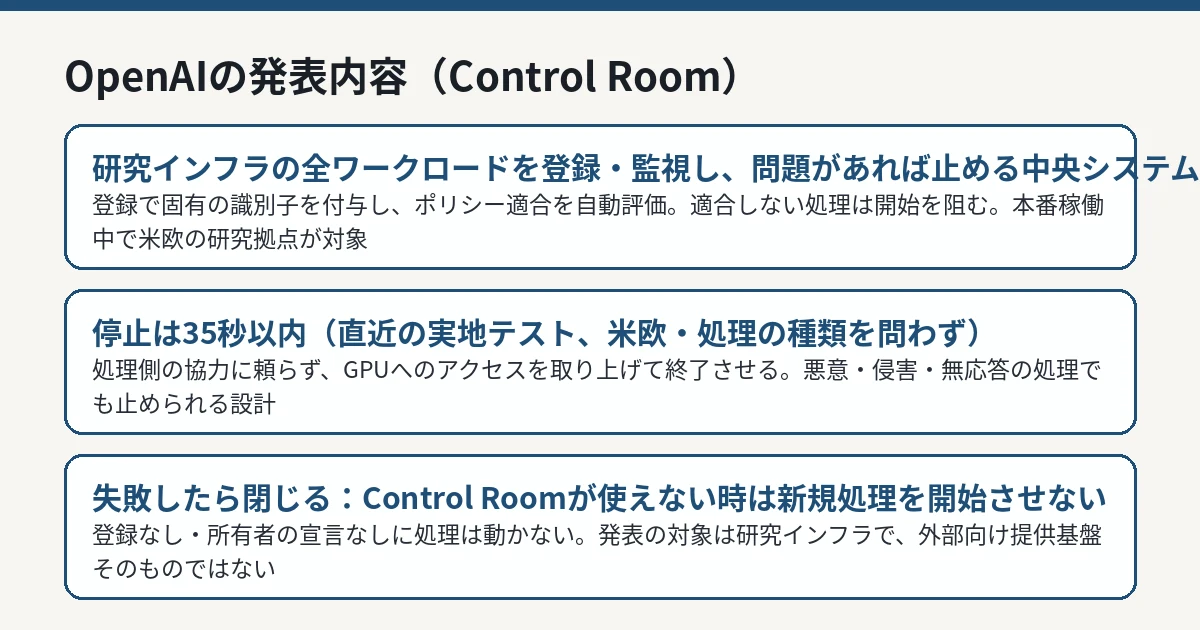
OpenAIの発表をもとにIT Post編集部が作成した図解です。 IT Post編集部 仕組み——登録、適合確認、停止の3段階
同社の説明では、Control Roomは処理のライフサイクルに次の3段階で組み込まれます。
段階
内容
1. 処理の登録
処理が始まるとControl Roomに登録し、固有の識別子を受け取る。メタデータは処理の一生を通じて更新され続け、状態を追跡できる
2. ポリシー評価
処理が全ての関係ポリシーと基準に適合するかを自動で評価する。適合しない処理は開始を阻む
3. 停止の実行
安全でない、または規格に適合しないと識別された処理について、ポリシーに沿って自動的に停止を開始する。処理の管理下から計算資源を取り上げ、停止を保証する
実例として同社が挙げるのは、モデルの不整合(ミスアラインメント)の新たな証拠が見つかった場合です。その場合、新しいポリシーを導入すれば、該当する処理を自動的に止め、GPUへのアクセスを外すことで処理を止められるとしています。
検出と停止を分けて考える整理は、同社が10月29日に公表した有害な学習の検出・管理の取り組みともつながります。検出側の取り組みはフロンティアモデルの不整合監視を扱った記事 で整理しました。Control Roomは、その「見つけた後、確実に止める側」を担う仕組みです。
35秒という数字と、「協力しなくても止まる」設計
同社は、停止は「十分に速く、例外なく効く」必要があるとしています。悪意のある主体や故障したシステムを動いたまま残す危険があるためです。
直近に実施したリアルタイムのテストでは、停止要求を受けてから35秒以内にモデルの処理を停止できることを、米国とEUの両地域で確認したとしています。処理が米国のGPUクラスターで動いていても、EUで動いていても、処理の種類が何であっても、この時間内に止められるということです。
設計上のもう一つの柱は、停止が処理側の協力に依存しない点です。同社の説明では、処理自体が悪意を持っていたり、侵害されていたり、応答しなかったりしても止められるよう実装されており、協力的な停止に頼らず、処理から計算資源へのアクセスを取り上げて終了させます。つまり、止めるかどうかは、止められる側の状態に左右されません。
抜け道を塞ぐ2つの仕掛け
同社は、対象範囲と失敗時の挙動についても説明しています。
対象は研究における全ての処理で、小規模な実験からフロンティアモデルの学習までを含みます。処理の所有者を必須とする仕組みにより、登録なし、または所有者の宣言なしに処理が動くことはなく、Control Roomの保護から逃れる処理は存在しないとしています。
システムは「fail closed」(失敗したら閉じる)設計です。Control Roomが利用できなくなった場合、新しい処理の開始は既定で阻まれます。安全を担う仕組みの故障が、監視の空白を静かに作ることはない、という考え方です。適合を確認できない処理は、実行が許可されません。
IT Postの見方
IT Postでは、今回の発表の要点は、停止の仕組みを「お願い」から「資源の没収」に変えた点だと考えます。処理側のコードが正しく動くことを前提にした停止は、処理そのものが壊れたり悪意を持ったりした瞬間に効かなくなります。GPUへのアクセスという物理に近い層で止める設計は、その前提を外した点で合理的です。35秒という数字も、計測した結果として地域と処理の種類を添えて示されており、検証可能な形で出ています。
一方で、これは同社の内部基盤の話であり、外部から実効性を確かめる手段はありません。テストの条件や、実際のインシデントで使われた実績があるのかは、発表からは読み取れません。「全ての処理が対象」という主張も、所有者モデルの徹底が前提であり、その徹底ぶり自体は同社の自己申告です。仕組みの設計思想は筋が通っていますが、評価は「よくできた設計の公表」までで、運用の実績はこれから示されるものとして見るべきです。
今後どうなりそうか
同社は、研究計算の拡大に合わせて、Control Roomが研究基盤の統治と安全の中核であり続けるとしています。今後の確認点は、実際の停止事例の公表があるか、対象範囲が研究以外の基盤へ広がるか、第三者による評価の対象になるかです。
IT Postでは、新しい公式情報が確認できれば、本記事を更新します。