AI・生成AI AIエージェントの訓練は、本番と同じ道具でできるのか。マイクロソフトの「Agent Lightning v1.0」の性能数値を検証する 実際のエージェントハーネスでの強化学習を目指す、約3,500行のフレームワーク「Agent Lightning v1.0」。SWE-bench Verifiedでの性能数値を一次資料から確認した
まず初めに
従来型のエージェント強化学習 では、訓練用の枠組みに本番のハーネスを組み直す必要が生じる。そこで挙動がずれるなら、せっかく鍛えた成果も測りにくい。Agent Lightning v1.0は、ハーネスのモデル接続先にプロキシを置いて、その再実装を減らす方式を示した。ただし、同種の課題に取り組む他の方式もある。約3,500行という規模と、実際のハーネスでの訓練を両立させようとした点を評価したい。
※個人の感想です
何が起きているのか
Microsoft Research Asiaは2026年10月7日、公式ブログでZhiyuan He氏(Research Software Development Engineer II)とYuqing Yang氏(Principal Research SDE Manager)の研究として、AIエージェントを強化学習で訓練するためのフレームワーク「Agent Lightning v1.0」を発表しました。あわせて、このフレームワークが採用する新しい訓練の考え方を「Harnessed Agentic RL(ハーネス付き・エージェント型強化学習)」と名付けています。
発表は、従来のエージェント向け強化学習が抱えていた課題を挙げています。従来型の多くの方法では、強化学習を行う訓練用のフレームワーク自身が、AIエージェントと環境とのやり取り(観察を受け取り、次の行動を決める、という一連の流れ)を管理する前提で作られていました。そのため、実際にサービスとして動かす際に使う「エージェントハーネス」(mini-SWE-agentやOpenHands、OpenCode、Claude Code、Codexなど、独自の文脈管理ぶんみゃくかんり やツールの呼び出し方を持つ仕組み)を、訓練用にもう一度作り直す必要が生じる場合があり、コストがかかるだけでなく、訓練されたエージェントが本番で動くエージェントと同じ挙動をしなくなるという問題がありました。
Agent Lightningは、エージェントとモデルの間に「LLMプロキシぷろきし 」(通信を中継する仕組み)を置くことでこの問題に対応します。既存ハーネスでは、モデルAPIの接続先をAgent Lightningのプロキシへ向けることで、通常はハーネスのコードを変えずに接続できる設計です。ただし個別のハーネスでの互換性や設定作業は、この例示だけで保証されるものではありません。v1.0では、この「本番で使うハーネスがそのまま訓練に参加する」という考え方を、研究者らが正式に「Harnessed Agentic RL」と名付けて定義しています。接続先の変更で再実装を減らせるなら、訓練と本番の距離も縮められそうだ。
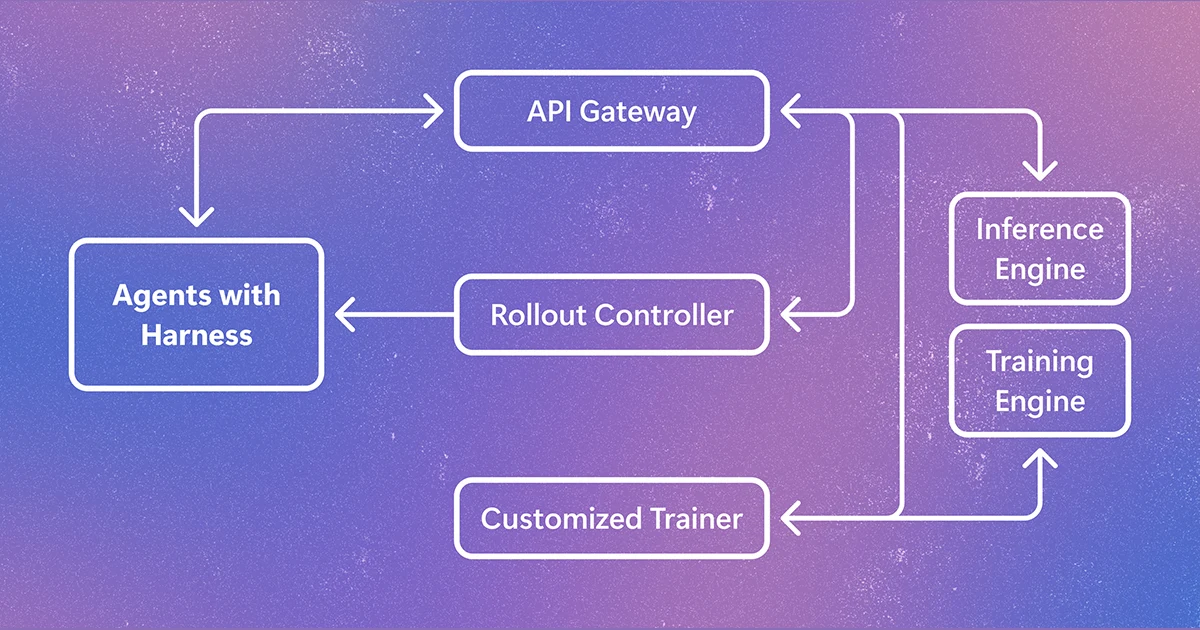
フレームワーク全体は約3,500行のコードで構成されており、3つの主要な要素からなります。「API Gateway」はロールアウト(1回分のエージェントの実行記録)・モデル・イベントを保存し、OpenAI互換のLLMプロキシとして動作して、各モデル呼び出しをロールアウトに結びつけ、プロンプト・応答・対数確率たいすうかくりつ を記録します。「Rollout Controller」はエージェントの実行を開始・管理し、ローカルのプロセスか、標準的なKubernetesのジョブとして動かし、学習器とは分離して実行します。「Customized Trainer」は強化学習ライブラリ「verl」の上に構築され、ロールアウトの作成・収集と、学習用サンプルの組み立てを行います。発表では、既存のエージェントハーネスをAgent Lightningに接続するには、基本的にモデルの呼び出し先をAgent Lightningのプロキシに向けるだけで済むとしています。
ハーネス経由での訓練には4つの技術的な課題があるとされています。文章を再トークン化さいとーくんか (テキストを再びAIが処理できる単位に分割すること)する際に境界がずれて複数の呼び出しをうまく1つのサンプルにまとめられない問題、1回のロールアウトが複数のサンプルに分かれることで統計的な計算がずれる問題、サンプル数が多いロールアウトが学習時に過大に重視されてしまう問題、そして可変な作業量を固定されたGPUなどの資源にうまく割り当てる問題です。これらに対応する新機能として、ロールアウト(エージェントの実行)とモデルの更新を同じGPU群で共有する「Collocated Async RL」も導入されており、記事で示した実験条件では同期型の強化学習に対して約2倍のエンドツーエンドの高速化を達成し、従来の非同期型の強化学習より少ないGPUで済んだとしています。
訓練の実例として、SWE-smith、mini-SWE-agent、モデル「Qwen3.5-9B」を使ったコーディングエージェントの一連の訓練パイプラインが示されています。データの整備・実行環境の構築・報酬の不正利用(意図しない手段で評価だけを高める行動)への対策・強化学習の訓練までを含む、約6,000件の訓練データのみを使ったこの実験で、ベンチマーク「SWE-bench Verified」でのQwen3.5-9BのPass@1(1回の試行での正解率)は41.8%から56.4%へ、14.6ポイント向上したとしています。あわせて、ロールアウト単位でのアドバンテージ計算と正規化を組み合わせた方式が、サンプル単位の処理と比べて検証時の報酬が高く、方策のエントロピーえんとろぴー (行動の多様性を示す指標)もより安定していたとしています。
なぜ重要なのか
この発表が重要なのは、AIエージェントを賢くする強化学習の訓練と、実際にサービスとして使うエージェントの動作とのズレを減らす、具体的な実装を示した点です。発表によれば、コーディングエージェントだけでも、mini-SWE-agentやOpenHands、OpenCode、Claude Code、Codexといった、それぞれ独自の仕組みを持つハーネスが広く使われるようになっており、これらを訓練用に作り直すコストと、作り直したことで生まれる本番との差は、これまで強化学習の実用化を妨げる要因になっていました。Agent Lightningが示した「ハーネスを変更せずに訓練に参加させる」という方式は、この差を小さくする具体的な方法の一つです。
もう一つの重要な点は、Kubernetesの標準的なジョブとしてエージェントを動かせる設計により、有料の商用サンドボックスサービスに頼らずに済む点です。発表は、他のHarnessed Agentic RLの枠組みが、Modal SandboxやE2Bといった商用サンドボックスサービスにエージェントを置くことが多く、規模が大きくなるほどコストが急激に上がるとしており、自前のKubernetesクラスタやクラウドのKubernetes、ローカル環境でエージェントを動かせる設計は、商用サンドボックスへの依存を減らします。ただしGPU・CPU・クラスタの運用費がゼロになるわけではありません。
私たちへの影響
Agent Lightning自体は開発者・研究者向けのオープンソースのフレームワークであり、一般の利用者が直接触れたり設定したりするものではありません。GitHub上の「github.com/microsoft/agent-lightning」で公開されているとしています。一方で、こうした訓練技術によって、コーディングエージェント訓練の研究としては参考になりますが、Claude CodeやCodexなどの特定製品への採用や性能向上が確認されたわけではありません。
初心者が知っておくべきこと
強化学習とは、AIが試行と評価を繰り返しながら、より良い行動の仕方を自分で学んでいく機械学習の手法です。今回のAgent Lightningは、この強化学習をAIエージェント(ツールを使ったり複数の手順を踏んだりしながら作業を進めるAI)の訓練に応用する枠組みです。
エージェントハーネスとは、AIモデル単体ではなく、AIモデルに加えてツールの呼び出し方・文脈の管理・実行環境といった、エージェントを実際に動かすための周辺の仕組み全体を指す言葉です。同じAIモデルでも、どのハーネスで動かすかによって、実際にできることや挙動が変わることがあります。
Q. Agent Lightningは今すぐ自分のパソコンで使えるのですか。
A. 発表はGitHubでのオープンソース公開を案内していますが、想定される利用者は研究者やAIエージェントを開発するエンジニアであり、一般の利用者が直接使う製品やサービスではありません。
Microsoft Researchの公式記事に掲載されたAgent Lightningの構成図。 画像提供:Microsoft Research IT Postの見方——訓練と本番のズレをどう減らすか
IT Postは、Agent Lightningが示した「本番で使うハーネスをそのまま訓練に使う」という発想は、地味に見えて筋の通った話だと考えます。従来型の方法では、訓練用に再実装したエージェントと本番のハーネスに差が生じ得ます。Agent Lightningはその差を減らす一つの方式ですが、他の取り組みも存在します。鍛えた本人と、実際にリングに上がる本人が違う、という話に近いとIT Postは見ます。
一方で、IT Postは、約6,000件という比較的少ない訓練データで14.6ポイントの性能向上を達成したという結果について、特定のベンチマーク・特定のモデル(Qwen3.5-9B)での結果である点は踏まえておくべきだと考えます。発表にある数字は実験条件下での結果であり、他のモデルや別の種類のタスクでも同じ規模の向上が常に得られるとは、この発表だけからは判断できません。
※個人の感想です
今後どうなりそうか
発表では、技術報告書「Agent Lightning v1.0: Towards Harnessed Agentic RL」とGitHubでのプロジェクト公開が案内されていますが、今後の具体的な機能追加やバージョンアップの予定は本文には示されていません。IT Postでは、Agent Lightningを使って訓練されたエージェントが実際のサービスに組み込まれた事例が確認された時点で、あらためて取り上げます。