AI・生成AI DatabricksのGenieが第2世代、「聞かれたら答える助手」から常時稼働の自律エージェントへ。Ontologyは正式提供 Databricksは2026年11月11日、第2世代のGenieを発表した。目標を与えると自前のコンピュートでバックグラウンド実行し、サブエージェントへの委任や進捗追跡を行い、判断が必要な時だけ優先受信箱とメールで人に上げる。基盤のGenie OntologyとGenie本体は正式提供(GA)で、Genie Searchや常時稼働版はプレビュー/ベータが先行する
まず初めに
「AIに聞けば答えてくれる」段階は、もう売り文句にならないらしい。今度は「頼んでおけば勝手に進めておいてくれる」である。ただし企業の中の仕事は、定義も承認者も例外処理も部署ごとに違う。その文脈をモデルが持ち続けられるかどうかが勝負になる、というのがDatabricksの言い分で、今回の発表の主役は実はエージェントそのものより、その足元の「Ontology」のほうに見える。
※個人の感想です
何が発表されたのか
Databricksは2026年11月11日(サンフランシスコ)、第2世代のGenieを発表しました。同社の説明では、Genieは「常時稼働の自律エージェント」になり、従業員が目標を与えれば、仕事の完遂までを任せられます。
動作のイメージはこうです。Genieは自前のコンピュートを使ってバックグラウンドで自律実行し、必要に応じてサブエージェントへ作業を委任し、進捗を追跡します。不足している入力があれば催促し、人が判断すべき場面でのみ、優先受信箱とメールで担当者に上げます。メールやSlackの把握、会議の準備といった日常業務から、四半期予測のような大きな仕事までが対象だとしています。
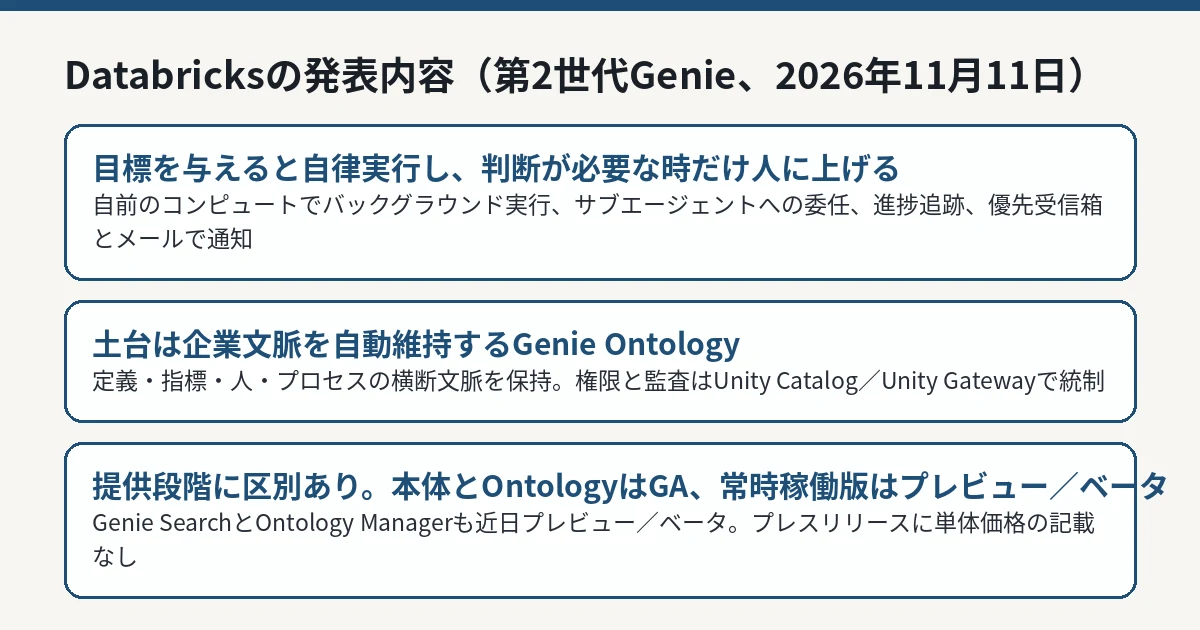
第2世代Genieの動作と提供段階の区別を整理した図解 IT Post編集部 土台は「Genie Ontology」
自律動作の前提として同社が置くのが、Genie Ontologyです。これは企業の横断的な文脈——用語の定義、指標の意味、その背後にいる人とプロセス——を捉え、事業の変化にあわせて自動で最新に保つ仕組みだと説明されています。
エージェントのすべての行動はこのOntologyに基づいて行われ、構造化・非構造化、分析系・運用系、Databricksの内と外を問わず、データ横断で「次に取るべき行動」を提案するとしています。統制面では、Genieは顧客の既存のDatabricks環境の中で動き、Unity CatalogとUnity Gatewayによって統制されるため、すべての行動が既存の管理の範囲内に収まる、という設計です。
CEOのAli Ghodsi氏は発表で、Genieによって自身が「10倍生産的なCEOになった」と述べ、現在は聞く前から動き、判断が必要な時だけ戻ってくると説明しています。同氏はその理由を「収益の意味、公式な数字はどれか、誰が何を見られるかをGenieが分かっている」ためだとしています。
背景として同社は、複雑なプロジェクトをうまく進めるために必要な情報の多くが、複数のプラットフォームや人の頭の中に散らばっていることを挙げています。どのアカウントに注意が必要か、何がエスカレーションの引き金になるか、誰が変更を承認するか——そうした暗黙の前提をエージェントが欠いたまま自律動作すれば、外れた行動も自律的に積み上がります。Ontologyは、この散らばった前提を一か所に集めて維持するための層だというわけです。
既存文脈との接続
各社とも、汎用チャットの先にある「業務の文脈と権限を束ねたエージェント基盤」を競っており、DatabricksのGenieもその一角です。違いは、Databricksがデータ基盤(レイクハウス)とガバナンス(Unity Catalog)を自社の既存製品として持った状態でエージェントを載せている点にあります。
Genie Searchと提供段階の区別
あわせて発表されたGenie Searchは、接続先を100以上の企業データソースへ広げます。レイクハウスに加えて、Google Drive、Jira、Confluenceといった業務アプリケーションが対象で、GenieとGenie Ontology経由で横断的に扱えるようになります。
注意が必要なのは提供段階の違いです。同社のプレスリリースでは、Genie本体とGenie Ontologyは全顧客向けに正式提供(GA)と明記されています。一方で、Genie Search、Ontology Manager、そして新しい常時稼働版のGenieは「近日、プレビュー/ベータプログラムで提供」とされています。「第2世代GenieがGA」と一括りにはできない構成です。
価格について、このプレスリリースに単体価格の記載はありません。利用はDatabricksプラットフォーム側の枠組みで扱われます。
利用者側の実務に引き直すと、常時稼働版が一般提供になった時点で問われるのは「どこまで任せるか」の境界設定です。目標と境界(クリアな境界条件)を人が与え、判断だけが受信箱に上がってくる設計は、その線引きを製品側が肩代わりする提案でもあります。
IT Postの見方
IT Postでは、今回の発表の核心はエージェントの自律性そのものよりも、「企業文脈の維持を製品の中核に据えた」点にあると考えます。常時稼働のエージェントが失敗する典型は、能力不足ではなく文脈の欠落——その会社でしか通じない定義、承認の順序、例外の扱い——です。Ontologyという形で文脈の維持を自動化し、権限統制を既存のガバナンス基盤に寄せた設計は、この失敗要因への正面からの回答です。
一方で、肝心の常時稼働版そのものはプレビュー/ベータが先行します。発表の見出しと実際に全顧客が触れる範囲には差があるため、導入を検討する側は「GAなのはGenie本体とOntology」という区別を押さえておく必要があります。
今後どうなりそうか
常時稼働型のエージェントは、MicrosoftやGoogle、Anthropicなども含め、各社が企業向けに競っている領域です。差が出るのは、モデルの性能よりも「その会社の文脈をどれだけ正確に持ち続けられるか」と「権限と監査の統制を既存基盤にどれだけ素直に載せられるか」になりそうです。
Databricksの場合は、データ基盤をすでに握っていることが強みになります。プレビュー/ベータの常時稼働版が一般提供に進む時期と、Ontologyの自動維持が実際の企業データでどれだけ機能するかが、次の評価ポイントです。発表の華やかさに引っ張られず、「GAの範囲はどこまでか」を契約前に確認するのが、導入側の実務的な注意点になります。