AI・生成AIBigQueryはなぜ画像・音声ファイルへの参照を表の列で扱うのか。ObjectRefの仕組みを確かめる
画像や音声そのものではなくCloud Storage上のファイルへの参照を表の列に保存。ObjectRefとSnapの事後層化の事例を一次資料から確かめた
まず初めに
これまでSQLの表に画像や音声を入れようとすると、まず泥臭いバイパイプライン工事が必要だった。外部のAI処理にファイルを送り、結果を苦労して表に縫い戻す——その手間を「列の中にファイルへの参照を1つ置くだけ」で終わらせてしまうのがObjectRefだ。派手さはゼロ、でもデータ分析者からすれば、長年の雑用がSQL一文に収まる瞬間というのは、どんな新製品発表よりも拍手したくなるものなのだ。
※個人の感想です
何が起きているのか
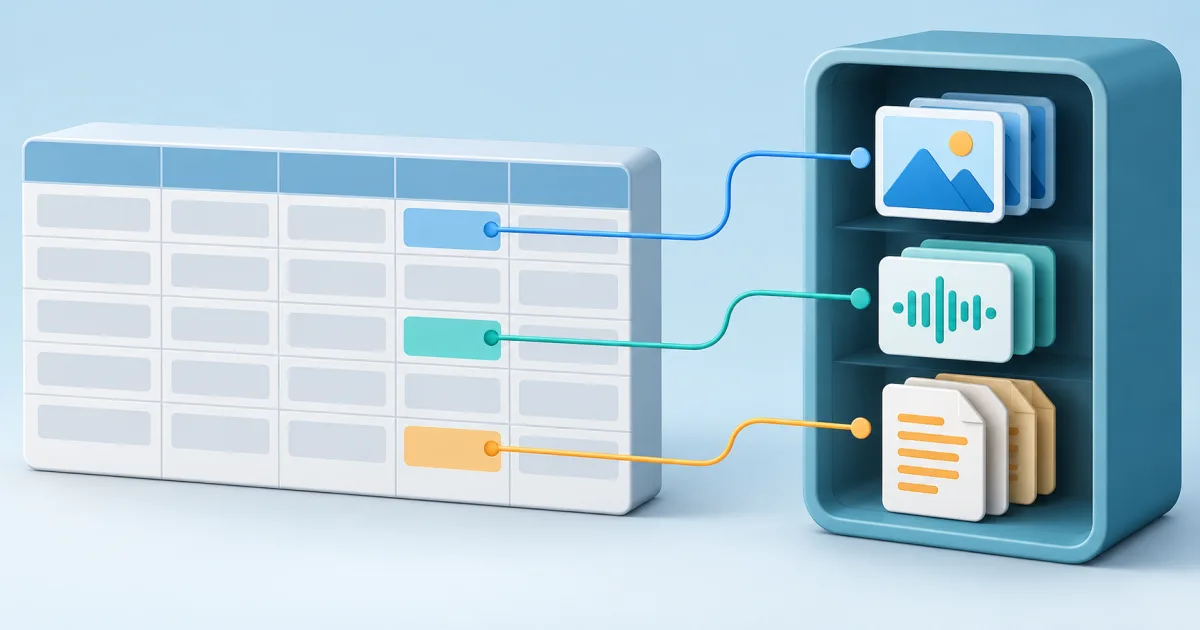
Google Cloudは、データ分析サービス「BigQuery」において、画像・音声・動画・文書などの非構造化データをCloud Storageに置いたまま、通常の表(テーブル)の列と同じように扱える「ObjectRef」機能を一般提供(GA)したと発表しました。ObjectRefは、ファイルの保存場所(URI)・権限情報・バージョン情報などをまとめて持つ、あらかじめ定義されたデータ型(STRUCT型)です。この列を通常の数値・文字列の列と同じ表の中に置くことで、BigQueryは画像や音声などのファイルを「一人前のデータ」として扱えるようになるとされています。ObjectRefにはCloud Storageの世代番号(バージョン)の情報も含まれており、ある行が書き込まれた時点で実際に存在していたファイルの版を、後から正確に参照できる点も特徴です。
今回のGAに合わせて、3つの機能が新たに加わりました。1つ目は、個人のIAM権限(End User Credentials)でも非構造化データを問い合わせられるようになったことです。プレビュー期間中は、BigQueryの接続設定を明示的に作る必要がありましたが、GAによって、都度の分析であれば個人の権限だけで試せるようになりました。なお、サービスアカウントによる本番環境のパイプラインでは、引き続きこの接続設定を使うことが推奨されています。2つ目は、BigQueryのオブジェクトテーブル・Cloud Storageインサイトデータセット・生の文字列URIのいずれからでも、ObjectRefを作成できるようになったことです。3つ目は、ObjectRefを配列(複数件のまとまり)として扱えるようになったことで、複数の文書を比較したり、画像の連続した一連の変化を分析したり、複数件をまとめて1回のAI呼び出しで処理したりできるようになったとされています。
発表では、これまで構造化データ(表形式のデータ)と非構造化データ(画像・音声などのファイル)を別々のパイプラインで管理する必要があり、Cloud Storage上のファイルに対して推論処理を行うには、別のML(機械学習)基盤を用意し、その結果を後からデータベースに縫い直す作業が必要だったという課題が説明されています。ファイルをいったん構造化データに変換してしまうと、元の情報の細かさや文脈が失われてしまう問題もあったとされています。ObjectRefは、ファイルをCloud Storageに置いたまま(データを移動させない「ゼロコピー」の仕組み)、標準的なSQLやPython(BigQuery DataFrames)から直接問い合わせられるようにすることで、この課題に対応するとしています。発表内のSQLの例では、AI.CLASSIFYという関数を使って、コールセンターの音声ファイルを「カードの紛失」「決済の拒否」といった問い合わせ種別に自動分類する例や、AI.GENERATEという関数を使って、本物のWebページと偽のフィッシングページのスクリーンショット2枚を比較し、見た目の違いからフィッシングかどうかを判定する例が示されています。
利用企業の例として、SNSサービスを提供するSnap社のデータサイエンティスト、Carlos Ortiz氏のコメントが紹介されています。同社は公開されている投稿のコミュニティガイドライン(利用規約)審査のため、定期的に投稿のサンプルを抽出していますが、ObjectRefとBigQueryのAI機能を使うことで、単純なランダム抽出から、「事後層化を用いる標本抽出(post-stratification sampling)」に切り替えたと説明しています。これにより、人による審査の効率が上がり、新しい審査の仕組みに充てる余力が生まれたとしています。発表によれば、ObjectRefはBigQueryの全エディション・オンデマンド料金プランで利用できますが、具体的な料金の数字については、この一次資料には記載がありません。
なぜ重要なのか
この発表が重要な理由は、これまで別々に管理されてきた「表形式のデータ」と「画像・音声などのファイル」を、同じデータベースの中で一体的に扱えるようにしたことです。多くの企業では、売上データのような構造化データと、商品画像・サポート通話の録音のような非構造化データが、別々のシステムで管理されており、両者を組み合わせた分析には多くの手作業が必要でした。ObjectRefのような仕組みが広がることで、こうした分析の手間が減り、より多くの企業が画像・音声データを活用した分析に取り組みやすくなります。
もう一つの重要な点は、Snapの事例が示すように、コンテンツモデレーション(不適切な投稿の審査)のような、人による判断が必要な業務の効率化に直接つながることです。SNSサービスやオンラインサービスを提供する企業にとって、投稿内容の審査は規模が大きくなるほど負担が増す業務であり、データ分析の仕組みを使って審査対象の絞り込みを効率化できることは、実務上の意味が大きい変化です。
私たちへの影響
今回の発表で直接の対応が必要になるのは、BigQueryを使ってデータ分析を行っている企業のデータエンジニア・データサイエンティストです。既存のCloud Storage上のデータやBigQueryのオブジェクトテーブルから、新しい仕組みを使って分析のパイプラインを組み直すことができるようになります。
一般の消費者が直接何かの対応を取る必要はありません。ただし、SNSやオンラインサービスを利用する際に目にする、不適切な投稿への対応や検索結果の精度などは、こうした裏側のデータ分析技術の進化によって、徐々に変わっていく部分です。
初心者が知っておくべきこと
「非構造化データ」とは、画像・音声・動画・文書のように、あらかじめ決まった形(表の行・列)に当てはめにくいデータのことです。これに対して、売上データや顧客情報のように、表形式に整理しやすいデータは「構造化データ」と呼ばれます。近年のAI技術の発展により、これまで分析が難しかった非構造化データも、構造化データと組み合わせて扱えるようになってきています。
「SQL」とは、データベースに対して、必要なデータを検索・集計・加工するよう指示するための、専門的な命令文の言語のことです。データ分析の現場で広く使われており、ObjectRefのような新機能も、このSQLの命令文の中から呼び出して使う形になっています。
IT Postの見方——効率化の先に、審査の精度は本当に上がるのか
IT Postは、画像・音声などのファイルを、別の基盤を用意せずにデータベースの中から直接扱えるようにする今回の機能は、データ分析に取り組む企業にとって実務上のハードルを下げる、有益な進歩だと考えます。特に、これまで非構造化データの分析には専門的なML基盤の構築が必要だった中小規模の企業にとって、SQLの知識だけで同様の分析に近づける点は評価できます。
一方で、IT Postでは、Snapの事例のような「コンテンツモデレーションの効率化」が、審査の質そのものの向上を自動的に意味するわけではない点には注意が必要だと考えます。標本の属性構成を調整して人による審査の効率を高めることは、限られた人手で広い範囲をカバーするための工夫ですが、AIによる絞り込みの精度次第では、本来審査すべき投稿が対象から漏れてしまうリスクも残ります。効率化の数字だけでなく、実際に利用者の安全がどこまで守られているかを、IT Postでは引き続き注視していきます。
※個人の感想です
今後どうなりそうか
発表では、ObjectRefを使った画像・文書からのベクトル検索や、大規模なAIによる分類といった活用例が紹介されていますが、具体的な料金体系や、今後追加される機能の詳細については、この一次資料では明らかにされていません。IT Postでは、ObjectRefを使った分析事例が他の企業にどこまで広がっていくのか、あらためて確認していきます。